recuperación de información

Enseñar a un parser a leer 30 años de artículos

Construir un parser capaz de extraer información de un artículo científico es, hoy en día, algo sencillo (relativamente) cuando todos los documentos siguen una misma estructura, pero, tal como se comentaba en la entrada anterior, esto cambia cuando se deben procesar casi 30 años de publicaciones, espacio de tiempo en el que ha cambiado el diseño de las revistas, la presentación de los autores, resúmenes, palabras clave y referencias bibliográficas e incluso los formatos de publicación (sin olvidarnos de identificadores como DOI u ORCID que no existían a principios de siglo).
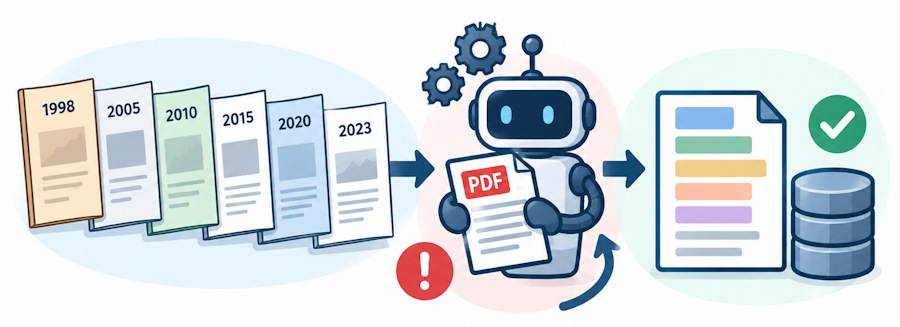
Enseñar a un parte durante casi 30 años, metáfora global.

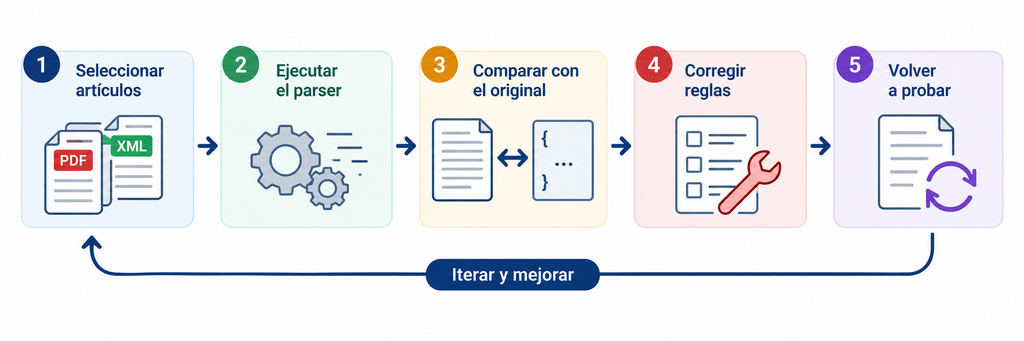
Esta ha sido una de las principales dificultades encontradas durante el desarrollo de DOCUMENTALIA. No buscamos que el parser funcione con unos cuantos artículos recientes, sino que sea capaz de reconocer de forma consistente la estructura de documentos publicados en épocas y condiciones editoriales diferentes. Para conseguirlo, ha habido que enseñar al parser de forma progresiva: seleccionar una muestra de artículos de distintos años, ejecutar el script, comparar los datos obtenidos con los originales, localizar errores, modificar las reglas y volver a probar. La experiencia muestra que un corpus histórico no contiene únicamente documentos antiguos y modernos; contiene distintas formas de representar la información que se han sucedido a lo largo del tiempo.

Un mismo artículo, muchas formas de representarlo

Cuando una persona lee un artículo. reconoce el título, los autores o la bibliografía, es un proceso que suele resultar sencillo. Después utilizamos el contenido, la posición, la tipografía y nuestro conocimiento de cómo se organiza el mismo. Un parser de PDF debe convertir esos indicios en reglas: dónde aparece una línea, qué hay antes y después, cómo comienza una referencia o qué patrones permiten reconocer un correo electrónico, una fecha o un DOI (son las directrices gramaticales formales que determinan cómo se estructuran, agrupan y validan los tokens de una cadena de entrada).

Una regla que funciona con los artículos de un determinado año puede fallar cuando cambia la plantilla de la revista. En DOCUMENTALIA, además, el corpus incluye artículos de Anales de Documentación y Cuadernos de Gestión de Información publicados en épocas diferentes y con muchos cambios en las plantillas (especialmente en la primera revista que es la más longeva).

El parser no tiene que aprender una plantilla: debe reconocer las regularidades que permanecen detrás de plantillas diferentes. Las primeras pruebas mostraron que los fallos no siempre son evidentes y que pasan prácticamente desapercibidos a nuestros ojos. El script puede terminar correctamente y generar un fichero JSON donde guardar la información que ha identificado, aparentemente completo, pero con malas interpretaciones de algunos elementos. Por ejempo, hemos encontrado afiliaciones de autores interpretadas como autores («Universidad de Córdoba» por «Juana López. Universidad de Córdoba»), líneas incorporadas indebidamente al título, palabras clave mal separadas (esto ha sido más frecuente de lo esperado), resúmenes en distintos idiomas mezclados, párrafos considerados encabezados de sección o referencias bibliográficas partidas o fusionadas (algo demasiado frecuente que luego dificulta el cómputo de las citas a esos artículos por parte de los índices). Todos estos errores muestran el mismo problema: extraer el texto de un PDF no equivale siempre a comprender su estructura documental.
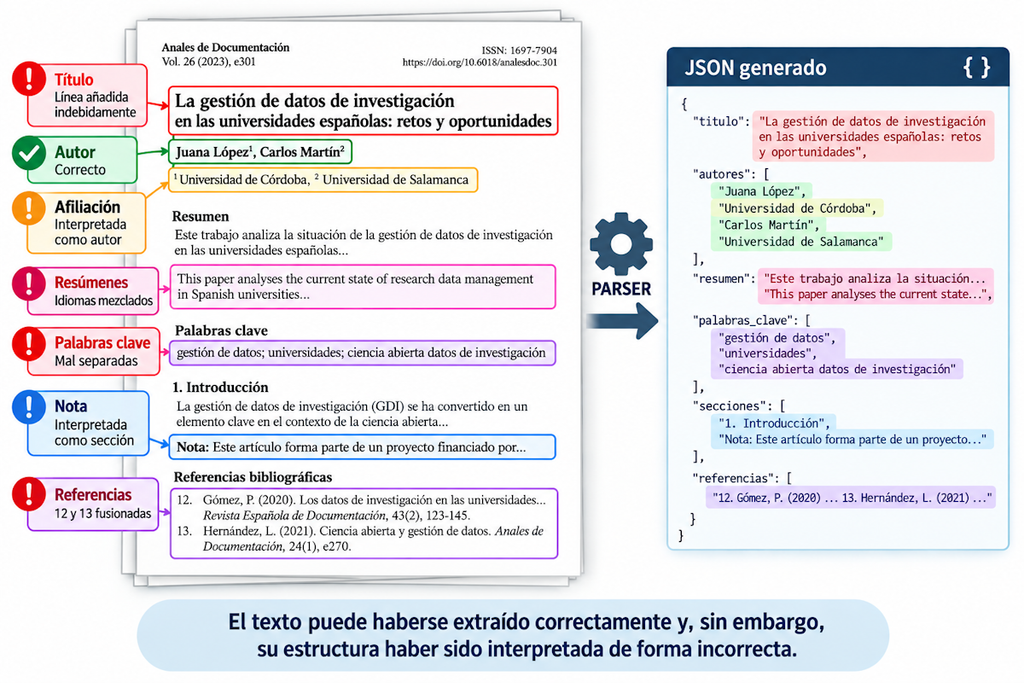
Posibles fallos en la interpretación automática del contenido de un artículo científico.
Cuando el texto es correcto pero la estructura no.

En el ejemplo de la imagen observamos que Autor está bien reconocido; la Afiliación se confunde con un autor; el Título tiene una línea añadida; la Nota se considera una sección y las Referencias 12 + 13 se han fusionado (error).

El parser debe viajar hacia atrás en el tiempo

Una parte especialmente interesante ha consistido en probar el parser con números cada vez más antiguos. Los documentos publicados en 1998, por ejemplo, plantearon unos problemas apenas presentes en artículos recientes: títulos y metadatos, autorías corporativas, palabras clave, segmentación de secciones o bibliografía. También se fueron incorporando a la revista tipos documentales, como reseñas y traducciones, cuya estructura no coincide con la de un artículo de investigación convencional o un artículo que recoge una experiencia aplicada (caso práctico). Con documentos más recientes han aparecido otros problemas: en artículos de 2022 tuvimos que tratar títulos traducidos truncados, notas numeradas interpretadas como secciones y referencias bibliográficas fusionadas.

Otro caso ilustrativo de la serie de fallos aparecidos fue en un artículo de Cuadernos de Gestión de Información de 2023. El número de referencias extraídas parecía correcto —53—, pero dos estaban truncadas. Una regla utilizada para eliminar números de página alteraba la reconstrucción del texto al cambiar de página y columna. Su corrección permitió recuperar las referencias completas sin alterar su número. Este ejemplo resume bien el problema: los indicadores cuantitativos pueden ser correctos y esconder errores cualitativos en la extracción de información.
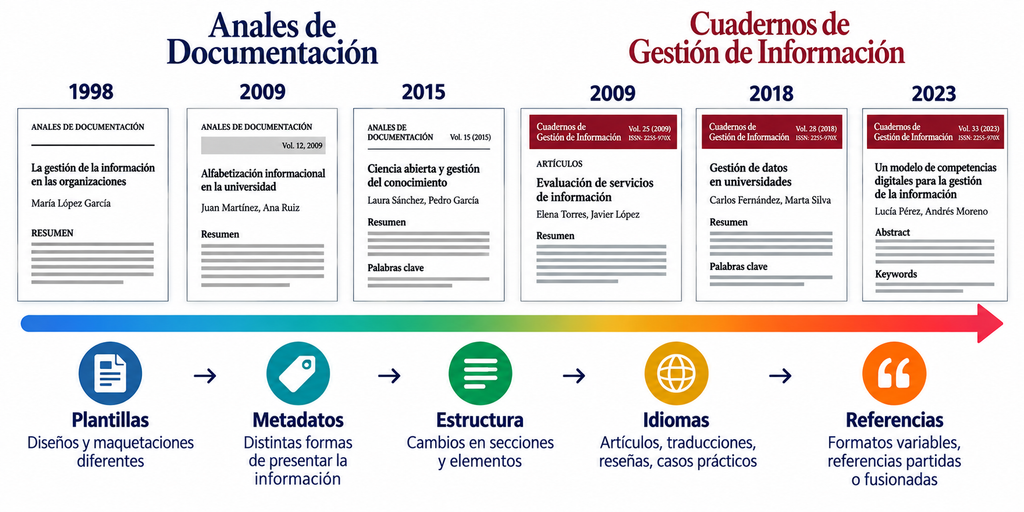
Casi treinta años de revistas: muchas formas de publicar

Corregir un error puede crear otro

Hay que ser consciente de que. al modificar una regla para resolver un problema, se puede provocar que un documento que antes se procesaba sin problemas deje de hacerlo (es lo que se conoce como «regresión», problema que ocurre cuando una modificación introduce un fallo en un comportamiento que anteriormente funcionaba. Por ello, no basta con volver a procesar el artículo que provocó el cambio, debemos reprocesar documentos que sí funcionaban, las correcciones deben verificarse con el mayor alcance posible. Esta forma de proceder se convirtió en una regla básica durante el afinado de DOCUMENTALIA: corregir el documento que falla no es suficiente: la modificación debe funcionar sin estropear los documentos que ya funcionaban.

Las excepciones son necesarias, pero también peligrosas

Cuando se presentaba un documento problemático (en Anales de Documentación hay un número donde el encabezado de la primera página de cada artículo es la referencia bibliográfica de ese artículo, por ejemplo), es tentador (y lógico) programar una excepción específica. De hacer lo mismo varias veces, terminaríamos elaborando un parser formado por una acumulación de casos particulares, difícil de mantener y poco preparado para documentos nuevos (y sus casuísticas). Por esta razón, hemos intentado distinguir entre excepciones documentales y regularidades editoriales. Cuando aparece un error no nos preguntamos únicamente cómo hacemos que «funcione ese artículo», la cuestión a resolver es ¿qué característica ha provocado el error y en qué otros documentos podría aparecer? Una buena regla del parser debe resolver una clase de problemas, no memorizar un documento dentro del código del script.

No todos los documentos científicos son artículos de investigación

El recorrido por todo el corpus reveló otra fuente de heterogeneidad: el tipo documental. Nuestras revistas publican mayoritariamente artículos de investigación, pero también recogen reseñas, traducciones u otros contenidos que no contienen los mismos elementos. En nuestras pruebas, por ejemplo, las reseñas de Anales de Documentación carecen de los elementos habituales de un artículo (resúmenes o palabras clave), lo que es normal y no constituye un error. El error sería obligar al parser a encontrar información que ese documento no contiene. Por tanto, la ausencia de un campo no siempre significa que la extracción haya fallado. Para interpretar el resultado también debemos conocer qué tipo de documento estamos procesando y se han introducido rutinas para identificarlo de forma automática.

El «afinado»: del artículo problemático a una regla más general

Este proceso de refinamiento puede resumirse del siguiente modo: documento → extracción → comparación → error → explicación → regla → nueva prueba → regresión

La fase fundamental es explicar el error. Si dos referencias aparecen unidas, no basta con separarlas, es necesario determinar por qué ocurrió. Las causas pueden ser variadas: ¿un salto de página?, ¿un cambio de columna?, ¿una referencia con una estructura diferente?, ¿una línea eliminada durante el preprocesamiento?, etc. Identificarla permite formular una regla más general y comprobarla sobre otros artículos.
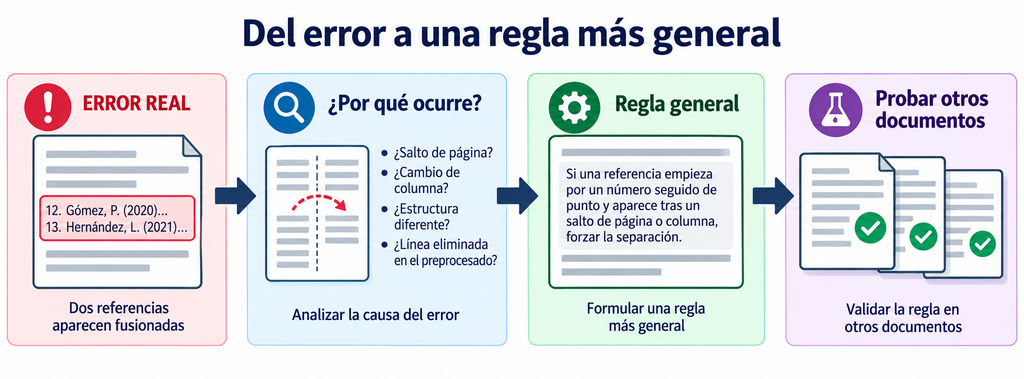
Refinamiento del parser: del error a una regla de alcance más general.

Un parser se construye con un corpus, no con un documento

Tras llevar a cabo numerosas iteraciones, reforzamos la idea de que un parser no se valida porque procese correctamente un artículo, sino porque podamos observar que mantiene un comportamiento consistente ante la diversidad del corpus. Si solo lo probamos con artículos recientes, habríamos obtenido un script aparentemente eficaz pero incapaz de interpretar una buena parte de la colección histórica. Las pruebas artículo por artículo han permitido descubrir cambios de plantilla, estructuras poco frecuentes, distintos tipos documentales y errores inesperados.

Pero este procedimiento tiene un límite. Revisar cuidadosamente cinco, diez o veinte artículos sirve para construir y corregir reglas. No demuestra que esas reglas funcionen sobre centenares de documentos.

De enseñar al parser a ponerlo a prueba

Cuando las principales reglas se estabilizan es necesario cambiar la escala de la prueba. En nuestro proyecto hemos pasado de revisar artículos de forma individual y/o pequeños conjuntos a ejecutar el parser sobre muestras aleatorias mucho mayores, algunas de hasta 200 artículos, buscando verificar si las reglas generalizan, localizan anomalías poco frecuentes y detectan regresiones. El resultado ha sido altamente positivo debido a la gran cantidad de cambios que habíamos ido introduciendo de forma previa con muestras más pequeñas. La diferencia entre ambas fases puede resumirse en dos preguntas:

  • Afinado: «¿Por qué falla este documento?»
  • Validación: «¿Con qué frecuencia falla el parser y qué errores siguen apareciendo?»

El cambio de escala nos lleva al siguiente paso: determinar cuándo el parser está suficientemente estabilizado para procesar el corpus completo y podemos incorporar los resultados a la base de datos de DOCUMENTALIA.
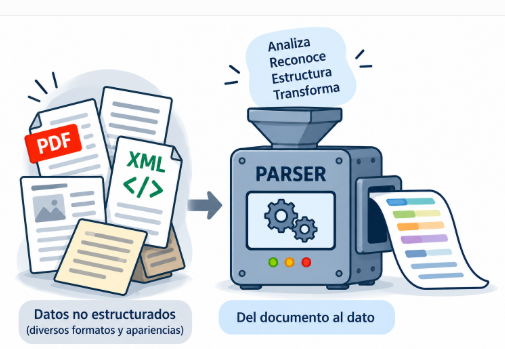
El parser transforma artículos en datos

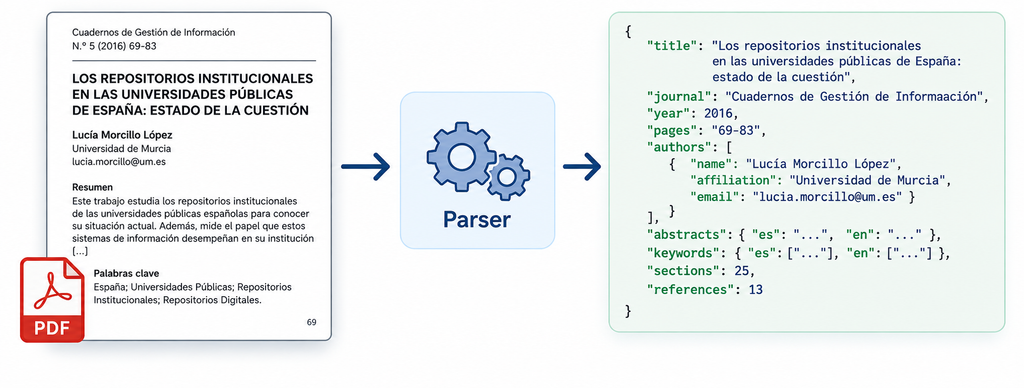
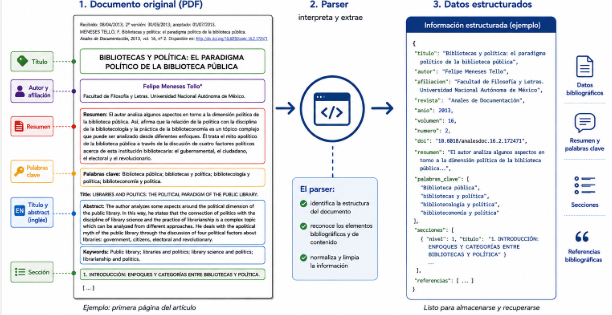
Esquema del funcionamiento de un parser: transforma documentos no estructurados en formatos PDF y XML en datos identificados y estructurados para su posterior recuperación.

En la entrada anterior hemos intentado mostrar la arquitectura general de DOCUMENTALIA, finalizando con una pregunta aparentemente sencilla: ¿cómo convertir una colección de artículos científicos heterogéneos en un corpus estructurado para que una «máquina» pueda interpretarla de forma consistente? Podemos contestar que la pregunta ha terminado ocupando buena parte de las primeras semanas de desarrollo centradas casi en exclusiva en el parser. Vamos a intentar explicarlo.

Antes de pasar a generar embeddings, realizar búsquedas semánticas o conectar el proyecto con un LLM, debemos saber qué contiene cada artículo: cuál es su título, identificar los autores, tener claro dónde empieza y termina el resumen, cuáles son sus palabras clave, qué secciones forman el texto o qué referencias bibliográficas contiene (entre otras cosas). Un ser humano reconoce casi inmediatamente esa estructura al mirar una página, en cambio, un programa informático tiene que aprender a reconocerla.

Comenzamos: un artículo es algo más que su texto

Podemos sintetizar el esquema de un artículo científico como: Artículo → metadatos + contenido estructurado + referencias.

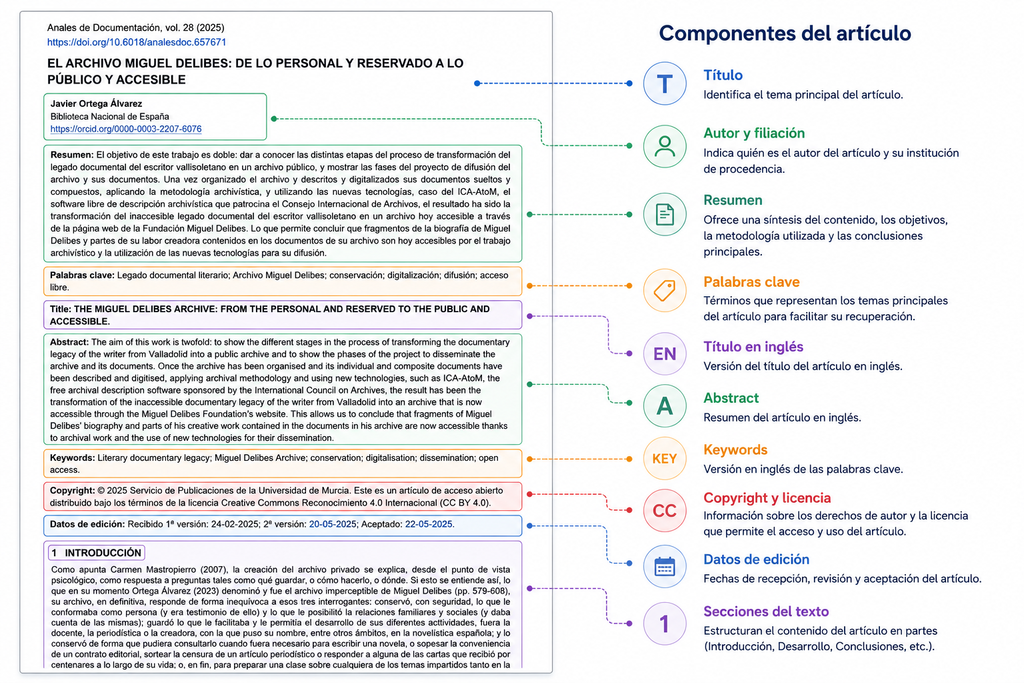
Hay que tener claro que la diferencia entre obtener texto y obtener información estructurada es fundamental. Si extraemos de un archivo PDF las palabras que contiene, hemos recuperado su texto, lo que es un primer paso, aunque todavía necesitamos determinar qué palabras corresponden al título, cuáles identifican a los autores, cuáles pertenecen al resumen o dónde comienza una determinada sección: extraer texto es recuperar las palabras de un artículo; extraer su estructura es identificar qué función desempeña cada parte de ese texto.

Representación de un artículos científico de Anales de Documentación
De la página al artículo: sus componentes.

Esta estructura es importante para casi todo lo que se debe hacer posteriormente: va a permitir almacenar correctamente los artículos, fragmentarlos con mayor criterio, recuperar evidencias dentro de determinadas secciones y, algo muy interesante en este proyecto que sirve para el estudio de la literatura científica, relacionar cada resultado con su fuente original.

El parser: convertir documentos en datos

El programa encargado de realizar esta tarea se denomina parser, aplicación que transforma y preprocesa datos no estructurados. En DOCUMENTALIA utilizamos este término para referirnos al programa que analiza un documento, reconoce los elementos que nos interesan y los transforma en datos estructurados que puedan ser procesados posteriormente. Nosotros intentamos identificar, entre otros elementos: título, revista, año, volumen y número; autores y afiliaciones; DOI y otros identificadores; resúmenes y palabras clave; secciones y subsecciones; y referencias bibliográficas. El esquema básico parece sencillo: Documento → parser → datos estructurados

En la práctica, la salida del parser adopta una estructura organizada en campos. El documento deja de ser únicamente una sucesión de páginas y texto: el título se identifica como título, un autor como autor, cada resumen queda asociado a su idioma y las secciones conservan su posición y nivel dentro del artículo. Así, la información que en el artículos editado en PDF estaba destinada a la lectura por parte de una persona (de muchas a poder ser), pasa ahora a estar identificada, estructurada y preparada para su tratamiento automático.

cionamiento y propósito del módulo parser.

El problema va a aparecer cuando observamos los documentos de entrada y percibimos los problemas que genera no tener un formato común (o mínimamente común).

XML-JATS y PDF: dos formas muy distintas de representar un artículo

Una parte de los artículos más recientes está disponible en XML-JATS, mientras que la mayor parte del corpus histórico está formada por PDF. Como ya señalamos en la entrada anterior, ambos formatos plantean cuestiones en la extracción diferentes.

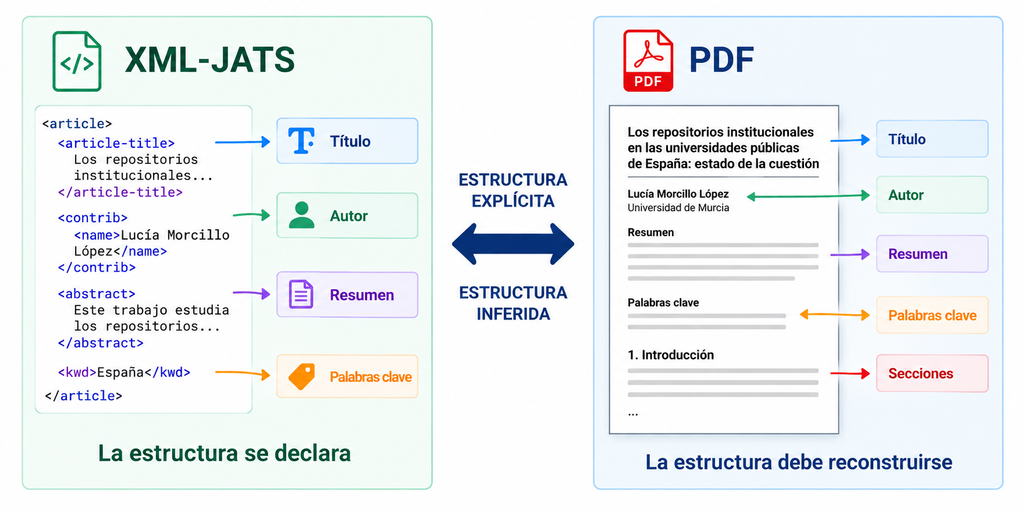
JATS (Journal Article Tag Suite) es un estándar XML concebido específicamente para representar artículos científicos. En un documento XML-JATS encontramos estructuras semejantes a «<article-title>El título del artículo</article-title>» donde el propio documento está indicando que ese texto es el título. También existen etiquetas para autores, resúmenes, palabras clave, secciones o referencias bibliográficas. El parser debe interpretarlas, pero dispone de una ventaja fundamental: la estructura está expresada explícitamente en el documento. Con los documentos PDF la situación cambia porque las personas vemos una página y reconocemos el título fácilmente sabiendo que debajo aparecen los autores y que posteriormente comienza el resumen. En este formato, se conserva perfectamente esa apariencia visual sin gtener que decir explícitamente que cada uno de esos elementos cumple esas funciones. Por tanto, en los artículos en formato XML-JATS la estructura está declarada; en los documentos PDF la estructura debe ser reconstruida.

Diferencias en la estructura de los artículos XML-Jats y los editados en PDF
Diferencias entre la estructura de los artículos XML-Jats y los editados en PDF

El problema no es solo el formato PDF: son los 30 años de PDFs

Si todos los artículos hubieran utilizado exactamente la misma plantilla, reconstruir esa estructura habría sido bastante más sencillo, pero no ha sido el caso. Anales de Documentación comenzó a publicarse a finales de los años noventa y durante ese tiempo han cambiado sus diseños, las tecnologías utilizadas para la edición y algunas convenciones editoriales, incluso la norma requerida para elaborar las referencias bibliográficas que cambió de ISO-690 a APA 7th. Además, nuestro proyecto incorpora una segunda revista (de vida más corta), Cuadernos de Gestión de Información, con su propia maquetación y con una forma de redactar la bibliografía no muy convencional. Por eso no existe realmente una única estructura sobre la que podamos escribir un conjunto fijo de reglas.

Se han hallado documentos escritos a una o dos columnas; autores y afiliaciones en diferentes posiciones; uno, dos o tres resúmenes; distintas formas de presentar palabras clave; varios sistemas de numeración de secciones; cambios en las referencias bibliográficas; DOI en los artículos recientes y otros identificadores en documentos anteriores. Incluso las reseñas han cambiado el formato de escritura con el paso de los años.

El problema más persistente ha sido que los documentos reales no siempre respetan perfectamente la plantilla editorial que deberían seguir, y no han sido fallos puntuales. Por ello. una diferencia apenas perceptible para una persona puede ser suficiente para que una regla automática interprete incorrectamente un elemento. Eso explica por qué la maquetación a nivel interno de nuestra base de datos, algo que inicialmente parecía secundario, se ha convertido en uno de los principales problemas técnicos del proyecto (el que más ha costado arreglar, de momento).

Durante el desarrollo apareció enseguida una necesidad muy práctica: necesitábamos saber qué estaba leyendo el parser. Antes de introducir automáticamente cientos de artículos en la base de datos teníamos que comprobar qué se estaba realmente interpretando. Por eso incorporamos una salida intermedia en formato JSON para revisarla debidamente, introducir cambios en el algoritmo, volver a validar y, si no ya se veían las deficiencias corregidas, cargar los artículos en la base de datos. El fichero JSON funciona como una especie de «radiografía» de la interpretación realizada por el programa. Con esa información, hemos sido capaces de verificar si el parser había encontrado correctamente el título, cuántos autores había reconocido, qué resúmenes se habían extraído, cómo se habían dividido las secciones o cuántas referencias bibliográficas se identificaban. Además, podíamos saber dónde residía el problema, pedirle a chatGPT que corrigiera el código del script y continuar revisando.

Debemos tener claro que un «OK» en esa revisión no significa necesariamente que todo esté bien. De hecho, esta ha sido una de las lecciones prácticas de DOCUMENTALIA. El parser podía ejecutar un documento sin producir ningún error de tipo informático y, sin embargo, interpretarlo incorrectamente, confundiendo lugar de trabajo con el nombre del autor o autora, incorporando una línea al título, no reconociendo determinadas palabras clave por no estar bien separadas en el texto, cortando una sección antes de tiempo o dividiendo (o uniendo) las referencias bibliográficas incorrectamente. Por eso hemos tenido que contrastar los resultados inciales con el artículo original sucesivamente y el desarrollo del parser ha terminado convirtiéndose en un proceso iterativo:

Secuencia de diseño del parser de DOCUMENTALIA

Aquí aparece además un problema conocido en desarrollo de software: corregir un caso puede estropear otro. Una regla introducida para interpretar correctamente un aspecto de una plantilla específica puede interferir con otra utilizada en artículos de una época diferente. Por ello no ha bastado con volver a procesar el documento que provocó la modificación: ha habido que verificar que la nueva regla no introducía errores en la extracción de información de artículos que antes funcionaba (como dato, vamos a comenzar la carga masiva esta misma semana y ya llevamos 26 versiones del parser).

Existía una solución sencilla, pero poco recomendable: añadir una regla específica para cada documento que falla. Esto no nos servía porque no queremos construir un parser lleno de excepciones. Si el artículo A da problemas y escribimos una excepción para A, luego, al fallar el B, añadimos otra y así sucesivamente, probablemente conseguiríamos que todo el corpus acabara procesándose correctamente, pero estaríamos construyendo un programa para unos documentos concretos, no un parser suficientemente generalizable. Nuestro objetivo es diferente: identificar regularidades documentales y convertirlas en reglas generales evitando, si es posible, recurrir a excepciones particulares.

Lo cierto es que un corpus real contiene anomalías y es posible que algunas tengan que tratarse específicamente. Pero es importante distinguir entre una nueva regularidad no reconocida previamente y una peculiaridad exclusiva de un documento. Esta diferencia determina hasta qué punto el trabajo realizado en DOCUMENTALIA puede reutilizarse posteriormente con otras colecciones.

¿Cuántos artículos tenemos que comprobar?

He aquí otra cuestión práctica. Si nuestro objetivo es automatizar la extracción de varios centenares de artículos, revisar manualmente todos ellos eliminaría buena parte de la ventaja de utilizar un parser, pero testear un reducido grupo de documentos tampoco proporcionaría suficiente certeza de estar haciéndolo bien. La estrategia seguida ha sido construir un muestreo deliberadamente heterogéneo buscando cantidad y variabilidad. Se han seleccionado documentos de diferentes años de ambas revistas, diversas maquetaciones, varios idiomas y tipos documentales diferentes. También han resultado especialmente útiles los artículos próximos a momentos en los que sabemos que cambió el diseño editorial. Cada nueva muestra sirve para responder a la misma pregunta: ¿siguen funcionando las reglas del parser al aplicarlas a documentos diferentes de aquellos con los que fueron diseñadas?

Este cambio de perspectiva es importante porque va más alla de demostrar que el parser funciona con los artículos que ya hemos utilizado para corregirlo. Queremos aumentar nuestra confianza en que funcionará con los documentos que todavía no hemos revisado.

De la prueba artesanal a la prueba masiva

Las primeras fases de afinado se realizaron revisando pequeños grupos de artículos de diferentes años. Viendo que la presencia de singularidades era muy frecuente, se decidió revisar alrededor de cuatro artículos por número editado de las dos revistas. Además de los artículos científicos (el grueso del corpus), se testeó el parser con traducciones y reseñas. En el caso de los ficheros editados en XML-JATS, se han utilizado todos porque sólo llevamos dos números editando con ese formato. Ese procedimiento ha sido indispensable y ha permitido observar con detalle los tipos de errores y entender por qué se producen.

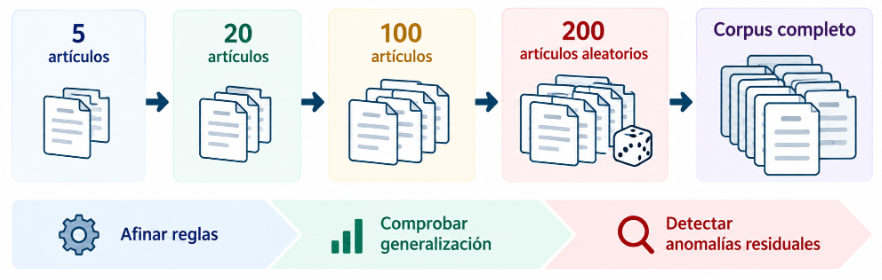
En una fase posterior, previa a la ingesta masiva de documentos a la base de datos, se necesita cambiar de escala. Esto ocurre cuando las reglas básicas parecen razonablemente estables. Hemos ejecutado el parser sobre muestras mucho mayores y se han analizado sistemáticamente los resultados. Este es precisamente el punto en el que nos encontramos mientras escribimos esta entrada: hemos pasado de probar cuidadosamente artículos individuales y pequeños conjuntos a comprobar el comportamiento del parser sobre muestras aleatorias mucho mayores del corpus, algunas de ellas de hasa 200 artículos. El objetivo es localizar errores menos evidentes, regresiones y casos que todavía no habíamos encontrado.

Validación del parser de DOCUMENTALIA mediante muestras crecientes de 5, 20, 100 y 200 artículos aleatorios antes de procesar el corpus completo, para afinar reglas, comprobar su generalización y detectar anomalías residuales.
DOCUMENTALIA: de las pruebas iniciales a la validación masiva del parser.

Primero los datos, después la IA

Todo esto ocurre antes de producir un solo embedding. Estamos convencidos de que este trabajo condicionará directamente la calidad de lo que hagamos después (y más en este caso que estamos aprendiendo cómo construir un buscador de esta naturaleza). Una estructura documental fiable permitirá crear mejores fragmentos, conocer de qué sección procede cada evidencia, filtrar por metadatos, relacionar los resultados con sus autores y proporcionar al usuario el DOI o el enlace del artículo original.

La metáfora general puede resumirse así: la calidad de la búsqueda futura depende en buena medida de la calidad de los datos que consigamos extraer ahora.

Un modelo LLM puede interpretar muy bien un fragmento de texto, pero no puede corregir automáticamente todos los problemas provocados por una extracción defectuosa o por la pérdida de contexto documental. Como DOCUMENTALIA aspira a generar respuestas trazables hasta los artículos originales, conservar correctamente la estructura y la identidad de los documentos es apropiado e importante. En la arquitectura ya publicada, el control de calidad y los identificadores persistentes aparecen precisamente como elementos transversales del sistema.

Lo que casi treinta años de artículos están enseñando al parser

El trabajo de extracción ha producido un resultado que no estaba entre los objetivos iniciales del proyecto. Al revisar documentos de diferentes épocas, se ha reconstruido de facto una pequeña historia de las regularidades, cambios y anomalías de maquetación de las revistas. Algunas diferencias eran previsibles: nuevas plantillas, cambios en las normas bibliográficas o la aparición del DOI (hace casi 30 años no existía). Otras lo eran bastante menos: se han encontrado casos en los que una tabla altera la interpretación del documento, reseñas cuya estructura se alejaba completamente de la de un artículo convencional, referencias que requerían reglas diferentes según la época o elementos aparentemente triviales que hacen fallar una extracción que funcionaba perfectamente en decenas de documentos anteriores (muchas veces porque el editor del documento impreso introdujo en un número un texto adicional o un elemento visual que luego no volvió a aparecer). También ha resultado curioso encontrar artículos publicados sin un apartado de bibliografía porque las referencias iban como nota a pie de página.

Esta serie de casuísticas son precisamente los que más han ayudado a mejorar el parser, y también los que mejor permiten explicar cómo se construye realmente un sistema de este tipo. En la próxima entrada profundizaremos en el «laboratorio del parser PDF«: veremos algunos de esos errores reales, cómo los hemos detectado y qué modificaciones nos han obligado a introducir en el código fuente del script.

¿Qué necesitamos para construir un buscador IA sobre una colección documental?

Logo del proyecto DOCUMENTALIA

En la entrada anterior presentamos el proyecto DOCUMENTALIA y explicamos su propósito: formular preguntas en lenguaje natural sobre una colección de artículos científicos y obtener respuestas fundamentadas en los documentos recuperados. Ahora vamos a mirar dentro de este sistema.

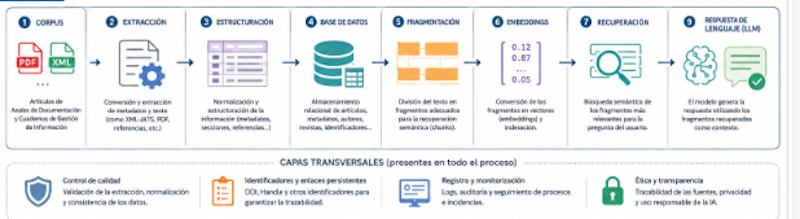
Un buscador de este tipo no se construye simplemente conectando una colección de artículos de revista almacenados en PDF o XML-JATS con un modelo IA. Entre los documentos originales y la respuesta final existe una cadena de procesos que permite extraer, organizar, representar y recuperar la información. Un buscador IA sobre una colección documental necesita de un corpus documental, mecanismos de extracción y estructuración de información, un sistema de almacenamiento, una estrategia de fragmentación, una representación semántica de los contenidos, un sistema de recuperación y un modelo de lenguaje que genere la respuesta a partir de las evidencias recuperadas. DOCUMENTALIA utiliza precisamente esta arquitectura.

Arquitectura general de Documentalia

De los documentos a la respuesta

La secuencia reflejada en la figura representa, de forma general, la arquitectura del sistema que vamos a construir: Corpus → extracción → estructuración → base de datos → fragmentación → embeddings → recuperación → modelo de lenguaje → respuesta con fuentes. Esta arquitectura proporciona el mapa de lo que iremos construyendo. Algunas partes ya están desarrolladas cuando escribimos esta entrada en este cuaderno de bitácora, otras corresponden a fases aun inexploradas. Veamos qué función cumple cada componente de DOCUMENTALIA.

1. Corpus: definir sobre qué documentos queremos preguntar

Todo comienza con una colección documental o corpus que, en nuestro proyecto, la constituyen inicialmente los artículos de Anales de Documentación y Cuadernos de Gestión de Información. No son documentos creados expresamente para realizar el experimento, sino publicaciones reales ya editadas (algunas van camino de los 30 años) bajo distintas condiciones editoriales (los rimeros números de Anales de Documentación solo tenían edición impresa pero pronto pasamos a disponer de la digital y, desde hace ya bastante tiempo, sólo de la digital). Esto introduce un primer problema: el corpus no es homogéneo. Se dispone, mayoritariamente de documentos en formato PDF y también en XML-JATS (correspondientes a los últimos número de Anales de Documentación), revista pionera en nuestra universidad en esta cuestión junto con Anales de Psicología). Los primeros conservan principalmente la presentación visual del artículo y los segundo contienen información estructurada mediante etiquetas; los segundos y serán los que se irán añadiendo a DOCUMENTALIA a partir de ahora.

c
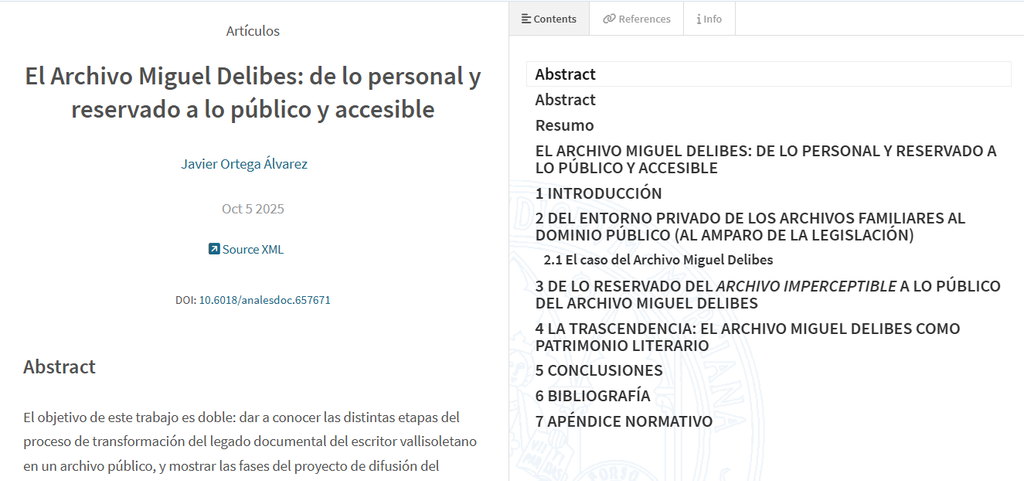
Vista de un artículo en formato XML-Jats en la revista Anales de Documentación

Por tanto, antes de pensar en aplicar la inteligencia artificial, es preciso saber qué documentos tenemos y qué podemos extraer de ellos.

2. Extracción: convertir documentos en datos

El siguiente componente es el parser. En recuperación de información es el programa encargado de interpretar los documentos y extraer la información que necesitamos. En un artículo científico queremos reconocer elementos como: título, autores, afiliaciones, fecha, revista, volumen, número, identificadores, resúmenes, palabras clave, secciones y referencias bibliográficas.

El problema a abordar es diferente según el formato. En los artículos que están ya redactados en XML-JATS, por ejemplo, una etiqueta puede indicar explícitamente que determinado texto corresponde al título o a un autor. En los documentos escritos en PDF (la gran mayoría), esa estructura debe ser reconstruida a partir del contenido y de determinadas regularidades documentales.

Cuestiones a resolver

Hay que tener presente que extraer el texto de un documento no implica haber extraído su estructura ni haber identificado correctamente la información que contiene. Esta cuestión ha ocupado la mayor parte del tiempo dedicado al proyecto en las primeras fases y será objeto de las próximas entradas.

3. Estructuración: representar documentos diferentes de una forma común

Los documentos originales pueden representar una misma información de maneras distintas. Un artículo puede disponer de DOI, otro, de handle; otro puede aportar los dos identificadores permanentes (eso sería lo deseable aunque, de momento, el repositorio de la Universidad de Murcia no devuelve el handle en la consulta por algún tipo de protección de seguridad), puede presentar tres resúmenes hasta en diferentes idiomas (es frecuente en los artículos escritos por autores brasileños); una reseña tiene una estructura completamente diferente de un artículo de investigación. Necesitamos transformar esa diversidad en una representación común.

Así entendido, la estructuración y normalización documental consiste en organizar la información extraída conforme a un modelo estable, independientemente de cómo estuviera originalmente representada. Gracias a ello, DOCUMENTALIA puede tratar de forma coherente artículos procedentes de diferentes formatos y épocas.

4. Base de datos: conservar la estructura del corpus

La información normalizada se almacena en una base de datos relacional creada al principio del proyecto con MySQL. En ella no guardamos únicamente una sucesión de textos, representamos entidades y relaciones: revistas, artículos, autores, afiliaciones, resúmenes, palabras clave, secciones, referencias e identificadores. Esto permite saber, por ejemplo, qué autores pertenecen a un artículo, qué resúmenes tiene, qué secciones hemos reconocido o qué DOI y handle permiten identificarlo. La base de datos y la futura búsqueda semántica cumplen, por tanto, funciones diferentes: la base de datos conserva la estructura conocida de la colección y la búsqueda semántica permite localizar información por su significado. Ambas formas de representación serán necesarias.

5. Fragmentación: dividir para recuperar mejor

Un artículo científico completo es una unidad demasiado grande para responder con precisión a una pregunta concreta (un artículo puede tratar varios temas y/o cuestiones). Si la información relevante está contenida en dos párrafos de un documento de veinte páginas, necesitamos ser capaces de recuperar esos párrafos y no necesariamente el artículo completo. Para ello dividiremos el contenido en fragmentos o chunks. El proceso de fragmentar persigue crear unidades de texto adecuadas para la recuperación: suficientemente pequeñas para ser precisas y suficientemente amplias para conservar el contexto. En una colección científica surge además una posibilidad interesante: aprovechar la propia estructura del artículo —introducción, metodología, resultados, discusión, conclusiones— para realizar una fragmentación más informada que un simple corte cada determinado número de palabras. Esta será una de las decisiones que tendremos que evaluar experimentalmente.

6. Embeddings: representar semánticamente los fragmentos

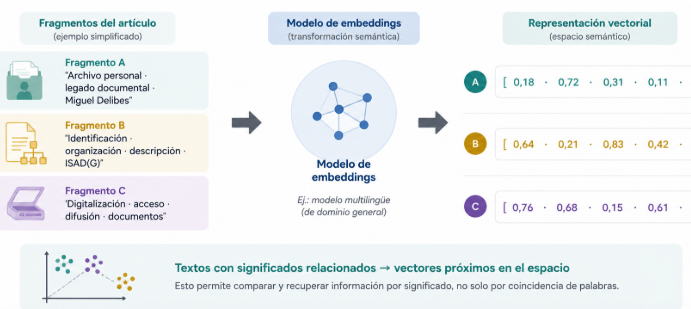
Una vez creados los fragmentos necesitamos una forma de comparar su significado con el de las preguntas formuladas por los usuarios, Aquí aparecen los embeddings (representación numérica de un contenido textual que permite comparar computacionalmente su proximidad semántica con otros textos).

Esquema del proceso de embeddings: fragmentos de un artículo científico se transforman en vectores numéricos que permiten comparar y recuperar textos por su significado semántico.
¿Qué es un embeding?

De manera simplificada, a un fragmento de texto se le aplica un modelo de embeddings para producir un vector. A la pregunta del usuario se le ha de aplicar el mismo procedimiento (tal como hace el modelo tf-idf en la RI clásica). De esta forma, tendremos dos vectores (representaciones) que se van a comparar para localizar fragmentos relacionados con una pregunta aunque no utilicen exactamente las mismas palabras. Es importante precisar qué los embeddings no responden a la pregunta, sino que ayudan a localizar qué partes del corpus pueden contener la respuesta.

7. Recuperación: encontrar las evidencias

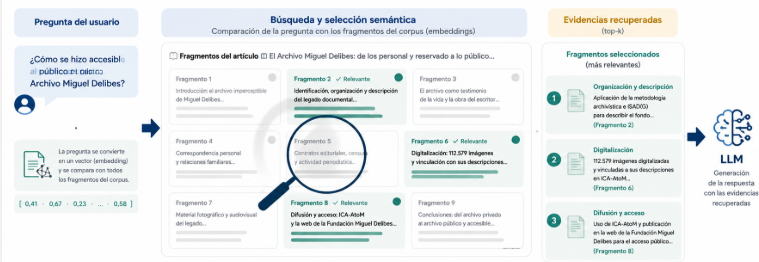
El siguiente componente selecciona, entre todos los fragmentos disponibles, aquellos más relevantes para la consulta. La proximidad entre embeddings puede constituir uno de sus mecanismos, pero no tiene por qué ser el único, se puede combinar búsqueda semántica con términos, metadatos, fechas, revistas u otros criterios de la búsqueda clásica.

Esquema del proceso de recuperación semántica: una pregunta se compara con los fragmentos del corpus, se seleccionan las evidencias más relevantes y se envían al modelo de lenguaje para generar la respuesta.
Esquema del proceso de recuperación semántica

La calidad de esta fase es crítica. Un modelo de lenguaje difícilmente podrá construir una respuesta correctamente fundamentada si previamente le proporcionamos fragmentos irrelevantes. Por ello, DOCUMENTALIA tendrá que evaluar dos cuestiones diferentes: (1) ¿hemos recuperado las evidencias adecuadas? y (2) el modelo ha respondido correctamente utilizando esas evidencias?

Separar ambas preguntas permitirá localizar mejor dónde se produce un posible error. No debemos olvidar que la recuperación no genera la respuesta: selecciona los fragmentos del corpus que pueden contener la información necesaria.

8. Modelo de lenguaje: generar la respuesta

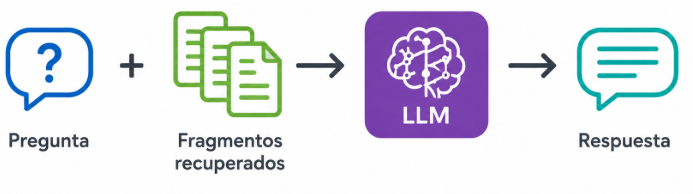
Solo después de recuperar información necesaria interviene el modelo de lenguaje o LLM. El mismo recibe la pregunta junto con los fragmentos seleccionados y genera una respuesta utilizando ese contexto documental. Se puede resumir en:

Modelo LLM: pregunta + fragmentos recuperados → LLM → respuesta

La función del modelo no es sustituir al sistema de recuperación, sino interpretar y sintetizar las evidencias que este ha localizado. En DOCUMENTALIA añadimos una condición esencial: la respuesta debe mantener la relación con los artículos de los que procede la información.

9. Respuesta con fuentes: cerrar el círculo documental

El resultado que buscamos no es simplemente un texto generado, aspiramos a obtener una respuesta trazable, acompañada de las fuentes utilizadas para construirla y, siempre que sea posible, con acceso al artículo correspondiente. Esto permite al usuario pasar de la respuesta generada al documento original y comprobar la evidencia. En una aplicación sobre artículos científicos como es nuestro proyecto, esta trazabilidad es especialmente importante porque la respuesta no debe convertirse en el punto final de la búsqueda, sino en una nueva vía de acceso a los documentos (artículos científicos) que contienen el conocimiento recuperado.

Hay componentes que atraviesan toda la arquitectura

El esquema de DOCUMENTALIA incorpora además varias capas transversales.

  • El control de calidad debe comprobar que la extracción y normalización son correctas.
  • Los identificadores persistentes mantienen la identidad y trazabilidad de los documentos.
  • El registro y la monitorización permiten conocer qué ocurre durante los procesos automáticos y localizar incidencias.

Finalmente, la ética y la transparencia afectan al sistema completo: procedencia de la información, trazabilidad de las fuentes, tratamiento de los documentos y uso responsable de los modelos de inteligencia artificial. No son etapas que ocurran al final, son requisitos que acompañan a todo el proceso.

No todo es inteligencia artificial

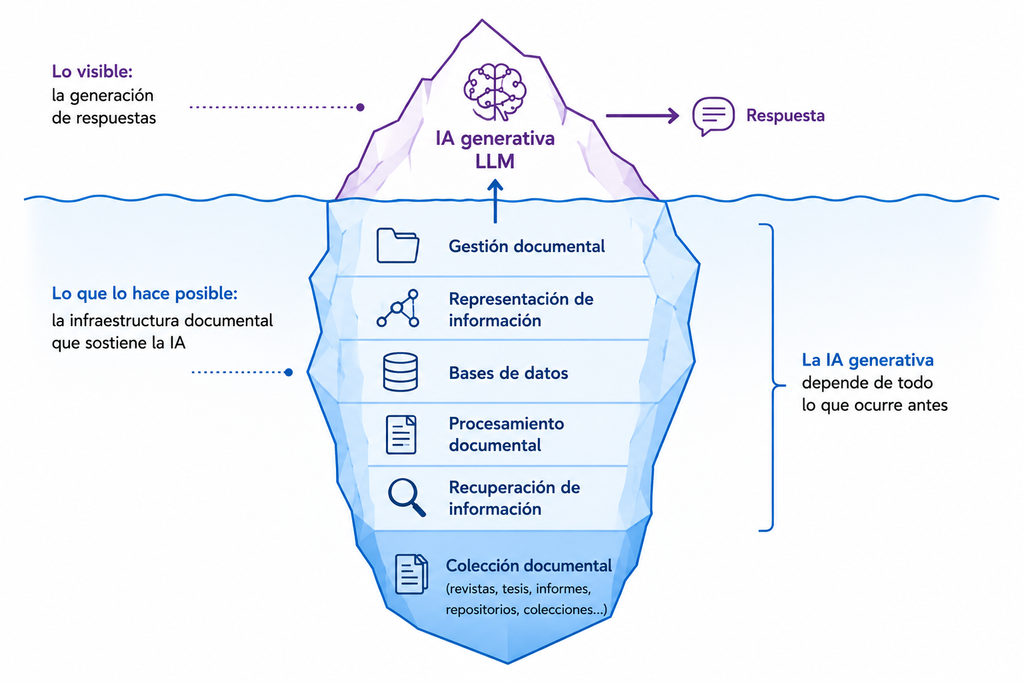
En la anterior entrada ya hacíamos mención a esta cuestión, reincidimos en ella. La arquitectura general del proyecto permite extraer una primera conclusión: no se trata únicamente de un problema de inteligencia artificial, es también un problema de gestión documental, representación de información, bases de datos y recuperación de información.

No todo es IA en DOCUMENTALIA

Antes de que un modelo de lenguaje pueda generar una respuesta habrá que seleccionar los documentos, interpretarlos, estructurar su información, almacenarla, dividir su contenido, representarlo y recuperar las evidencias adecuadas. La IA generativa ocupa una posición importante en la arquitectura, pero depende de todo lo que ocurre antes. Esta perspectiva es especialmente relevante en DOCUMENTALIA porque queremos comprobar hasta qué punto esta arquitectura puede reutilizarse con otras colecciones: repositorios institucionales, revistas, tesis doctorales, informes técnicos, colecciones patrimoniales o bibliotecas digitales.

¿Por dónde empezamos?

Se puede decir que ya disponemos del mapa general, toca ahora comenzar a recorrerlo de izquierda a derecha. El primer obstáculo apareció muy pronto: los artículos de las revistas no tienen todos la misma estructura ni están disponibles en el mismo formato de fichero. El gran problema han sido las maquetaciones, aspecto que podría parecer insignificante ante la potencia de la tecnología LLM, se ha convertido en un problema, tanto por los cambios de plantilla como por los muchos fallos a la hora de editar los artículos (es difícil encontrar tres o cuatro seguidos «bien maquetados»). Muchas formas de escribir en la Ciencia han cambiado con los años, también ha cambiado la norma para las referencias bibliográficas y existen artículos de investigación, reseñas, editoriales y otros tipos de documentos.

Por tanto, antes de construir embeddings o conectar un modelo de lenguaje, ha habido que resolver una cuestión mucho más básica: ¿cómo convertir una colección de documentos heterogéneos en un corpus estructurado que una máquina pueda interpretar de forma consistente?

Con suerte, lo podremos explicar en la siguiente entrada.

Retrieval Augmented Generative (RAG)

Esta mañana ha venido a visitarme mi director de departamento a preguntarme si se explicaba algo sobre RAG en la asignatura Recuperación de Información de tercero del grado. Le he dicho que no pero que tenía previsto hacerlo a partir del próximo mes de septiembre. Como prueba de ello publico este vídeo que le pedí a Google LLM que creara a partir de una serie de fuentes de información que nos permiten saber cómo está cambiando el ecosistema de las búsquedas de información tras la irrupción de chatGPT et al. hace poco más de tres años.

RAG: la convergencia entre los motores de búsqueda tradicionales y los Modelos de Lenguaje Extensos (LLM).

RAG son las siglas en inglés de «Generación Aumentada por Recuperación», técnica empleada por las lA para mejorar la precisión de los LLM (modelos de lenguaje extensos) al conectarles fuentes de datos externas y actualizadas antes de generar una respuesta. Su uso reduce alucinaciones y proporciona información contextualizada, siendo ideal para datos privados o de empresa. Esta integración permite superar limitaciones históricas, como la información desactualizada o las respuestas inexactas, al fundamentar la IA en datos específicos y verificables.

LLM y motores de búsqueda

La relación entre los motores de búsqueda y los modelos de lenguaje extensos se define como simbiótica porque ambas tecnologías aprovechan las fortalezas de la otra para superar sus limitaciones individuales, creando sistemas de información más inteligentes y eficientes. Mientras que los motores de búsqueda ofrecen frescura y cobertura masiva de datos, los LLM aportan capacidades de comprensión del lenguaje natural y síntesis de información

LLM y recuperación de información: cambio de paradigma

Esta integración no es solo una mejora incremental, sino un cambio de paradigma hacia servicios de búsqueda centrados en el usuario . Sistemas como el nuevo Bing o Google AI Overviews son ejemplos de esta simbiosis en acción, donde el motor de búsqueda recupera la información más relevante y actual, y el LLM la procesa para ofrecer una interacción fluida y personalizada

¿Recuperamos información o datos?

Nota de actualización de entracda antigua en el blog

Actualizo una entrada antigua de este blog que escribí en el año 2006 sobre la cierta confusión existente sobre si, en una búsqueda, recuperamos información o datos. Vamos a ver cómo queda.

En el campo de la recuperación de información (‘information retrieval‘), casi al principio de la disciplina, era normal encontrar autores que empleaban la expresión «recuperación de datos» cuando en realidad de lo que estaban hablando era de recuperar información. Teniendo en cuenta las fechas de lasque hablamos (años 80, cuando el tecnopop), Esto se debía, fundamentalmente, a una clara influencia de la terminología informática, disciplina cuya rapidísima evolución llevó a muchos autores a cometer el error de considerar sinónimos ambos conceptos, llegándose a olvidar, como afirmaba Brookes, que se puede recuperar información sin emplear procedimientos informáticos (hecho indiscutible aunque no sea lo más común hoy en día, evidentemente).

Portda del Diccionaro MacMillan de Tecnologías de la Informació

El frecuente y necesario empleo de una tecnología no sustituye la obligatoriedad de utilizar adecuadamente los conceptos terminológicos. Un ejemplo de este desacierto lo hallamos en el Glosario ALA que define “information retrieval” como “recuperación de la información» en su primera acepción y como “recuperación de datos” en una segunda, considerando sinónimos ambos términos en lengua inglesa. De parecida opinión es el Diccionario Mac Millan de Tecnología de la Información, que considera la recuperación de información como el conjunto de “técnicas empleadas para almacenar y buscar grandes cantidades de datos y ponerlos a disposición de los usuarios”.

Afortunadamente, es mayor el grupo de autores que establecen diferencias entre ambos conceptos. Entre ellos destaca Meadow, para quien la recuperación de la información es “una disciplina que involucra la localización de una determinada información dentro de un almacén de información o base de datos”. Este autor establece de forma implícita una ligazón entre recuperación de información y el concepto de «selectividad» a la hora de presentar esa información al usuario siguiendo algún tipo de criterio discriminatorio (selectivo por tanto) entre una gran colección de documentos. Meadow marca un poco más estas diferencias, al afirmar que no es lo mismo la recuperación de información entendida como traducción del término inglés information recovery que cuando se traduce el término information retrieval, porque “en el primer caso no es necesario proceso de selección alguno”. Pérez-Carballo y Strzalkowski refuerzan esta idea afirmando que “una típica tarea de la recuperación de información es traer documentos relevantes desde una gran archivo en respuesta a una pregunta formulada por un usuario y ordenar estos documentos de acuerdo con su relevancia”.

Grossman y Frieder indican que la recuperación de información es “hallar documentos relevantes, no encontrar simples correspondencias a unos patrones de bits”. De similar criterio es el W3C que define recuperar información como “dado un conjunto de documentos y una pregunta, encontrar el conjunto de documentos más relevantes con la pregunta”.

En clase, explico a mis estudiantes que, en la recuperacíón de datos, las preguntas son altamente formalizadas y la respuesta  es directamente toda la información deseada. Así, “recuperar los títulos de los libros escritos por Jorge Luis Borges en la década de los 50” sería la ecuación “SELECT titulo WHERE autor=’Jorge Luis Borges’ AND fecha>1949  AND fecha<1960”. Otra pregunta fácil es saber cuántos ciudadanos de Murcia tienen alguna multa de tráfico sin abonar al Ayuntamiento de la ciudad y cuánto totaliza esa deuda para las arcas municipales. Nos movemos en un paradigma determinista, el territorio del modelo relacional de bases de datos. También les explico que en la recuperación de información, las preguntas son más difíciles de trasladar a un lenguaje formal y la respuesta es un conjunto de documentos que probablemente contendrá la información deseada, siempre con un factor de cierta indeterminación. En este modelo, el territorio de los SRI, La consulta sería, por ejemplo, «Obras Borges década 50”.

Foto de C.J: Rijsbergen, de la Universidad de Glasgow

El gran profesor ‘Keith’ Rijsbergen establece en la siguiente tabla las diferencias entre recuperar datos e información:

Diferencias entre recuperación de datos y recuperación de información según Keith Risjbergen

Finalizo siempre esta cuestión presentando la siguiente cita de Ricardo Baeza-Yates:

“dada una necesidad de información (consulta + perfil del usuario + … ) y un conjunto de documentos, ordenar los documentos de más a menos relevantes para esa necesidad y presentar un subconjunto de aquellos de mayor relevancia”

¿Sigue este tema vigente?

Creo que esta distinción conceptual sigue siendo especialmente pertinente hoy en día. Si se observa la evolución reciente de los sistemas de búsqueda y acceso a la información. Las tecnologías actuales —como la búsqueda semántica, el uso de representaciones vectoriales (embeddings) o los modelos de lenguaje de gran tamaño (LLMs)— no han eliminado el problema clásico de la recuperación de información, sino que han añadido nuevas capas de complejidad. Estos sistemas ya no se limitan a la coincidencia literal entre términos (‘matching‘), sino que operan sobre representaciones semánticas del contenido, aproximándose con mayor eficacia a la noción de relevancia, aunque sin resolverla plenamente.

Datos, información y recuperación en sistemas de búsqueda actuales
Datos, información y recuperación en sistemas de búsqueda actuales.
Imagen elaborada por chatGPT.

Muchos de los SRI contemporáneos combinan, de forma híbrida, procedimientos propios de la recuperación de datos y de la recuperación de información. La indexación estructurada, las búsquedas exactas o las consultas sobre bases de datos conviven con mecanismos de ranking, inferencia semántica y estimación de relevancia. Esta convergencia tecnológica no invalida la distinción conceptual entre ambos enfoques; al contrario, la hace más necesaria, ya que permite comprender mejor los límites, fortalezas y riesgos interpretativos de cada tipo de sistema. En este contexto, los sistemas basados en modelos de lenguaje de gran tamaño y arquitecturas de retrieval-augmented generation (RAG) reintroducen, bajo nuevas formas, el debate clásico entre datos e información. Aunque estos modelos pueden generar respuestas coherentes y contextualmente plausibles, su funcionamiento depende en gran medida de procesos previos de recuperación y selección de documentos relevantes. La calidad informativa del resultado no reside únicamente en la capacidad generativa del modelo, sino en la adecuación del proceso de recuperación que lo alimenta, confirmando la vigencia de los principios fundamentales de la recuperación de información.

Fuentes bibliográficas. 

[1] Brookes afirma esto en la presentación del primer capítulo de la obra Information Retrieval Research titulado ‘Information Technology and Information Science’, donde recuerda que el problema de la recuperación de información no ha de aplicarse sólo a lo automático, sino también a lo manual. (Oddy et al, 1981). Salton también lo recalca al comentar que no siempre se recupera información textual (Salton & McGill, 1983).

[2] Meadow, C.T. (1992) Text Information Retrieval. 

[3] Pérez-Carballo, J. and Strzalkowski, T. ‘Natural language information retrieval: progress report’. Information Processing and Management 36, 2000. p. 155-178

[4] (Grossman and Frieder, 1998) Grossman, D.A. and Frieder, O. Information retrieval: algorithms and heuristics. Boston: Kluwer Academia Publishers, 1998.

El carácter selectivo de la recuperación de información

Cubierta del libro ‘Language and representation in information retrieval’, de DC Balir

Uno de los libros fundamentales sobre recuperación de información es la obra ‘Language and representation in information retrieval’ de D.C. Blair de 1990. Y una de sus principales aportaciones es, sin duda alguna, el llegar a establecer una clara diferenciación entre el término ‘data retrieval’ y el término ‘information retrieval’, utilizando como criterios distintivos: 

  1. En recuperación de datos se usan preguntas altamente formalizadas, cuya respuesta es directamente la información deseada. En cambio, en recuperación de información las preguntas resultan difíciles de trasladar a un lenguaje normalizado (aunque existen lenguajes para ello son de naturaleza mucho menos formal que los empleados en los sistemas relacionales) y la respuesta es un conjunto de documentos que pueden contener, sólo probablemente, lo deseado, con un evidente factor de indeterminación.
     
  2. De lo anterior y según la relación entre el requerimiento al sistema y la satisfacción de usuario, la recuperación de datos es determinista y la recuperación de información es posibilista, por causa del nivel de incertidumbre presente en la respuesta.
     
  3. En cuanto al éxito de la búsqueda, en recuperación de datos el criterio a emplear es la exactitud de lo encontrado, mientras que en recuperación de información, el criterio de valor es el grado en el que la respuesta obtenida satisface las necesidades de información del usuario, es decir, su percepción personal de utilidad, más conocido como la relevancia de la respuesta..
Diferencias entre búsquedas de datos y de información.
Imagen elaborada con chatGPT.

Jesús Tramullas destaca un aspecto de las reflexiones de Blair, “la importancia, en ocasiones ignorada, que tiene el factor de predicción por parte del usuario, ya que éste debe intuir, en numerosas ocasiones, los términos que han sido utilizados para representar el contenido de los documentos, independientemente de la presencia de mecanismos de control terminológico. Este criterio de predicción es otro de los elementos que desempeñan un papel fundamental en el complejo proceso de la recuperación de información” y que no se presenta en el campo de la recuperación de datos.

El primer método de evaluación de los buscadores web

tabla de comparativa de la efectividad de dos buscadores web

tabla de comparativa de la efectividad de dos buscadores webSin duda alguna, el honor de haber propuesto el primer método de evaluación de los sistemas de recuperación de información en la web le corresponde a Heiting Chu y Marilyn Rosenthal, quienes en el año 1996 (prácticamente en el inicio del desarrollo de los buscadores web) publicaron el trabajo ‘Search Engines for the World Wide Web: A Comparative Study and Evaluation Methodology‘ con motivo de la conferencia ASIS’96.

Se compararon tres sistemas de búsqueda (AltaVista, Excite y Lycos), midiendo  sus capacidades de búsqueda (por ejemplo, lógica booleana, truncamiento, búsqueda por campos, búsqueda de palabras y de frases) y de su rendimiento en la recuperación de información (es decir, precisión y tiempo de respuesta), utilizando consultas de ejemplo extraídas de preguntas reales de referencia.

La exhaustividad (recall), el otro criterio clásico de evaluación en recuperación de información, se omite deliberadamente en este estudio, ya que resulta imposible suponer cuántos ítems relevantes existen para una consulta determinada dentro del enorme y cambiante sistema de la web. Ya adelantaba este estudio pionero la poca utilidad de calcular esta ratio en este contexto (nadie aspira a consultar la mayor parte de la respuesta, con la primera y/o segunda página de resultados va a ser suficiente).

Los autores del estudio constataron que AltaVista superaba a Excite y Lycos tanto en las funcionalidades de búsqueda como en el rendimiento de recuperación, aunque Lycos presentaba la mayor cobertura de recursos web entre los tres motores de búsqueda analizados.

Como resultado de esta investigación, se propuso además una metodología para evaluar otros motores de búsqueda web no incluidos en el presente estudio.

Propuesta y desarrollo de un modelo para la evaluación de la recuperación de información en Internet

La recuperación de información, como disciplina claramente diferenciada de la recuperación de datos, posee una naturaleza no determinista que provoca ineludiblemente ciertas dosis de incertidumbre a la hora de realizar una operación de búsqueda. Es por ello que, desde el inicio del desarrollo de esta disciplina, ha sugerido una considerable cantidad de propuestas de medida de la efectividad del funcionamiento de los sistemas encargados de esta tarea: los sistemas de recuperación de información (SRI). La consolidación de la World Wide Web como ejemplo paradigmático del desarrollo de la Sociedad de la Información y del Conocimiento, y la continua multiplicación del número de documentos que en ella se publican cada día, propicia la creación de los sistemas de recuperación de información más avanzados, de mayor volumen de documentos gestionados y de mayor popularidad: los motores de búsqueda.

En estos sistemas, no obstante, subyacen las dudas sobre su efectividad, máxime cuando los mismos suelen ofrecer grandes cantidades de referencias entre las cuales abundan muchas poco relevantes con la necesidad de información del usuario. La evaluación de estos sistemas ha sido, hasta el momento, dispersa y dispar. La dispersión procede de la poca uniformidad de los criterios empleados y la disparidad surge de la aperiodicidad de los estudios y por la diferente cobertura de los mismos. Surge entonces la necesidad de proponer el desarrollo de un modelo de evaluación multidimensional de estos sistemas, próximos a los usuarios y al contexto donde se desarrolla, la World Wide Web, entorno difícil de gestionar y que, además, se encuentra afectado de grandes dosis de volatilidad. Nuestra propuesta de modelo de evaluación adapta medidas empleadas en otros procesos de la misma naturaleza, basadas en los juicios de relevancia y en la detección de errores y/o duplicados e implementa una función discreta de ponderación de la relevancia de los documentos recuperados.

Autor Principal: Martínez Méndez, Francisco Javier

Título: Propuesta y desarrollo de un modelo para la evaluación de la recuperación de información en Internet

Mención de Responsabilidad: / Francisco Javier Martínez MéndezRodríguez Muñoz, José Vicente (Profesor Titular de Universidad de Ciencias de la Información, Universidad de Murcia)

Publicación: Alicante : Biblioteca Virtual Miguel de Cervantes, 2003

Nota General: Calificación de la tesis : Sobresaliente cum laude

Portal: Biblioteca Virtual Miguel de Cervantes

Materias:

CDU:

Encabezamiento de materia:

Autor Secundario: Universidad de Murcia , Facultad de Ciencias de la Documentación

Año: 2002