En la entrada anterior presentamos el proyecto DOCUMENTALIA y explicamos su propósito: formular preguntas en lenguaje natural sobre una colección de artículos científicos y obtener respuestas fundamentadas en los documentos recuperados. Ahora vamos a mirar dentro de este sistema.
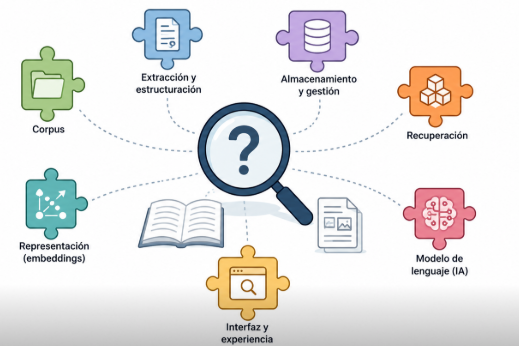
Un buscador de este tipo no se construye simplemente conectando una colección de artículos de revista almacenados en PDF o XML-JATS con un modelo IA. Entre los documentos originales y la respuesta final existe una cadena de procesos que permite extraer, organizar, representar y recuperar la información. Un buscador IA sobre una colección documental necesita de un corpus documental, mecanismos de extracción y estructuración de información, un sistema de almacenamiento, una estrategia de fragmentación, una representación semántica de los contenidos, un sistema de recuperación y un modelo de lenguaje que genere la respuesta a partir de las evidencias recuperadas. DOCUMENTALIA utiliza precisamente esta arquitectura.
De los documentos a la respuesta
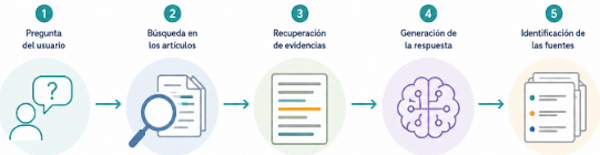
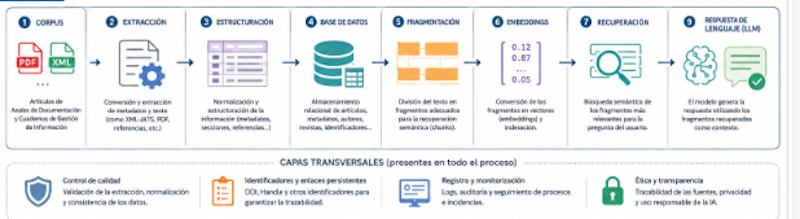
La secuencia reflejada en la figura representa, de forma general, la arquitectura del sistema que vamos a construir: Corpus → extracción → estructuración → base de datos → fragmentación → embeddings → recuperación → modelo de lenguaje → respuesta con fuentes. Esta arquitectura proporciona el mapa de lo que iremos construyendo. Algunas partes ya están desarrolladas cuando escribimos esta entrada en este cuaderno de bitácora, otras corresponden a fases aun inexploradas. Veamos qué función cumple cada componente de DOCUMENTALIA.
1. Corpus: definir sobre qué documentos queremos preguntar
Todo comienza con una colección documental o corpus que, en nuestro proyecto, la constituyen inicialmente los artículos de Anales de Documentación y Cuadernos de Gestión de Información. No son documentos creados expresamente para realizar el experimento, sino publicaciones reales ya editadas (algunas van camino de los 30 años) bajo distintas condiciones editoriales (los rimeros números de Anales de Documentación solo tenían edición impresa pero pronto pasamos a disponer de la digital y, desde hace ya bastante tiempo, sólo de la digital). Esto introduce un primer problema: el corpus no es homogéneo. Se dispone, mayoritariamente de documentos en formato PDF y también en XML-JATS (correspondientes a los últimos número de Anales de Documentación), revista pionera en nuestra universidad en esta cuestión junto con Anales de Psicología). Los primeros conservan principalmente la presentación visual del artículo y los segundo contienen información estructurada mediante etiquetas; los segundos y serán los que se irán añadiendo a DOCUMENTALIA a partir de ahora.
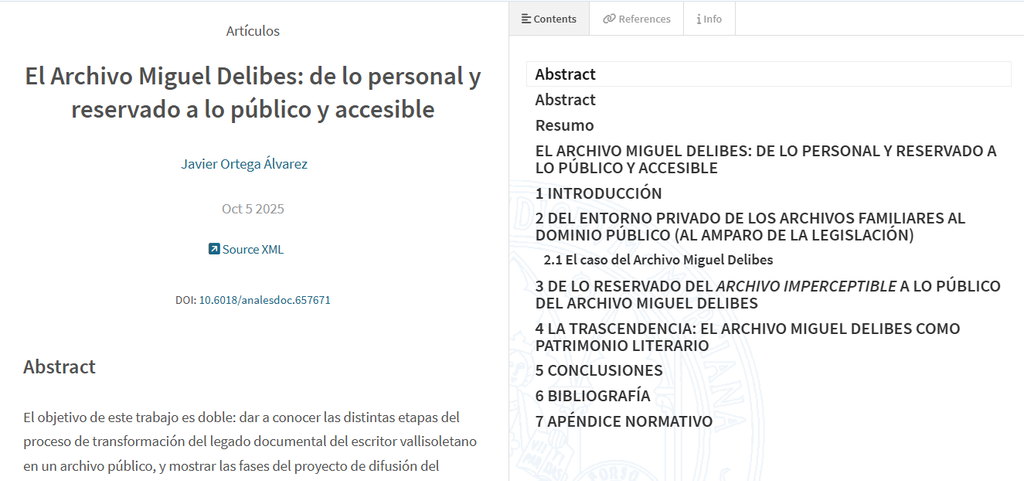
Por tanto, antes de pensar en aplicar la inteligencia artificial, es preciso saber qué documentos tenemos y qué podemos extraer de ellos.
2. Extracción: convertir documentos en datos
El siguiente componente es el parser. En recuperación de información es el programa encargado de interpretar los documentos y extraer la información que necesitamos. En un artículo científico queremos reconocer elementos como: título, autores, afiliaciones, fecha, revista, volumen, número, identificadores, resúmenes, palabras clave, secciones y referencias bibliográficas.
El problema a abordar es diferente según el formato. En los artículos que están ya redactados en XML-JATS, por ejemplo, una etiqueta puede indicar explícitamente que determinado texto corresponde al título o a un autor. En los documentos escritos en PDF (la gran mayoría), esa estructura debe ser reconstruida a partir del contenido y de determinadas regularidades documentales.
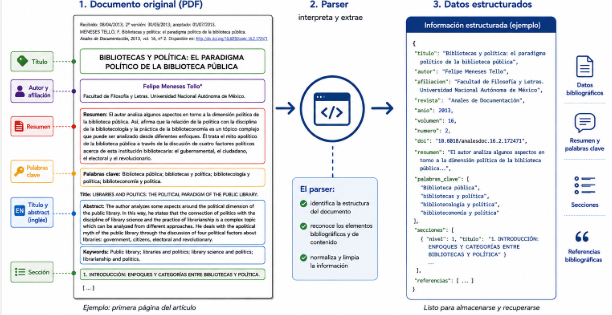
Hay que tener presente que extraer el texto de un documento no implica haber extraído su estructura ni haber identificado correctamente la información que contiene. Esta cuestión ha ocupado la mayor parte del tiempo dedicado al proyecto en las primeras fases y será objeto de las próximas entradas.
3. Estructuración: representar documentos diferentes de una forma común
Los documentos originales pueden representar una misma información de maneras distintas. Un artículo puede disponer de DOI, otro, de handle; otro puede aportar los dos identificadores permanentes (eso sería lo deseable aunque, de momento, el repositorio de la Universidad de Murcia no devuelve el handle en la consulta por algún tipo de protección de seguridad), puede presentar tres resúmenes hasta en diferentes idiomas (es frecuente en los artículos escritos por autores brasileños); una reseña tiene una estructura completamente diferente de un artículo de investigación. Necesitamos transformar esa diversidad en una representación común.
Así entendido, la estructuración y normalización documental consiste en organizar la información extraída conforme a un modelo estable, independientemente de cómo estuviera originalmente representada. Gracias a ello, DOCUMENTALIA puede tratar de forma coherente artículos procedentes de diferentes formatos y épocas.
4. Base de datos: conservar la estructura del corpus
La información normalizada se almacena en una base de datos relacional creada al principio del proyecto con MySQL. En ella no guardamos únicamente una sucesión de textos, representamos entidades y relaciones: revistas, artículos, autores, afiliaciones, resúmenes, palabras clave, secciones, referencias e identificadores. Esto permite saber, por ejemplo, qué autores pertenecen a un artículo, qué resúmenes tiene, qué secciones hemos reconocido o qué DOI y handle permiten identificarlo. La base de datos y la futura búsqueda semántica cumplen, por tanto, funciones diferentes: la base de datos conserva la estructura conocida de la colección y la búsqueda semántica permite localizar información por su significado. Ambas formas de representación serán necesarias.
5. Fragmentación: dividir para recuperar mejor
Un artículo científico completo es una unidad demasiado grande para responder con precisión a una pregunta concreta (un artículo puede tratar varios temas y/o cuestiones). Si la información relevante está contenida en dos párrafos de un documento de veinte páginas, necesitamos ser capaces de recuperar esos párrafos y no necesariamente el artículo completo. Para ello dividiremos el contenido en fragmentos o chunks. El proceso de fragmentar persigue crear unidades de texto adecuadas para la recuperación: suficientemente pequeñas para ser precisas y suficientemente amplias para conservar el contexto. En una colección científica surge además una posibilidad interesante: aprovechar la propia estructura del artículo —introducción, metodología, resultados, discusión, conclusiones— para realizar una fragmentación más informada que un simple corte cada determinado número de palabras. Esta será una de las decisiones que tendremos que evaluar experimentalmente.
6. Embeddings: representar semánticamente los fragmentos
Una vez creados los fragmentos necesitamos una forma de comparar su significado con el de las preguntas formuladas por los usuarios, Aquí aparecen los embeddings (representación numérica de un contenido textual que permite comparar computacionalmente su proximidad semántica con otros textos).
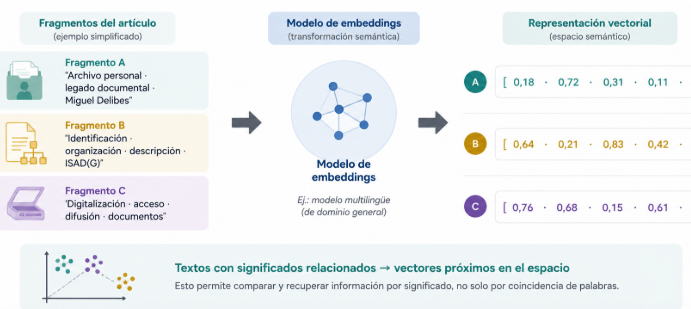
De manera simplificada, a un fragmento de texto se le aplica un modelo de embeddings para producir un vector. A la pregunta del usuario se le ha de aplicar el mismo procedimiento (tal como hace el modelo tf-idf en la RI clásica). De esta forma, tendremos dos vectores (representaciones) que se van a comparar para localizar fragmentos relacionados con una pregunta aunque no utilicen exactamente las mismas palabras. Es importante precisar qué los embeddings no responden a la pregunta, sino que ayudan a localizar qué partes del corpus pueden contener la respuesta.
7. Recuperación: encontrar las evidencias
El siguiente componente selecciona, entre todos los fragmentos disponibles, aquellos más relevantes para la consulta. La proximidad entre embeddings puede constituir uno de sus mecanismos, pero no tiene por qué ser el único, se puede combinar búsqueda semántica con términos, metadatos, fechas, revistas u otros criterios de la búsqueda clásica.
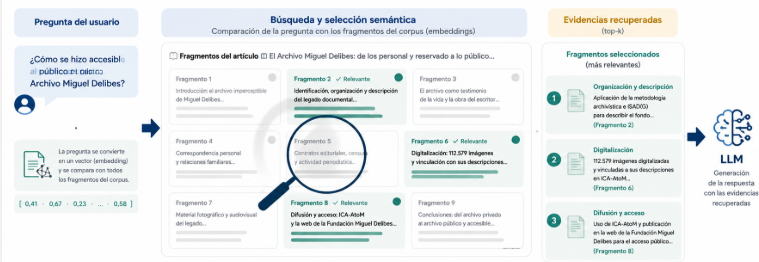
La calidad de esta fase es crítica. Un modelo de lenguaje difícilmente podrá construir una respuesta correctamente fundamentada si previamente le proporcionamos fragmentos irrelevantes. Por ello, DOCUMENTALIA tendrá que evaluar dos cuestiones diferentes: (1) ¿hemos recuperado las evidencias adecuadas? y (2) el modelo ha respondido correctamente utilizando esas evidencias?
Separar ambas preguntas permitirá localizar mejor dónde se produce un posible error. No debemos olvidar que la recuperación no genera la respuesta: selecciona los fragmentos del corpus que pueden contener la información necesaria.
8. Modelo de lenguaje: generar la respuesta
Solo después de recuperar información necesaria interviene el modelo de lenguaje o LLM. El mismo recibe la pregunta junto con los fragmentos seleccionados y genera una respuesta utilizando ese contexto documental. Se puede resumir en:
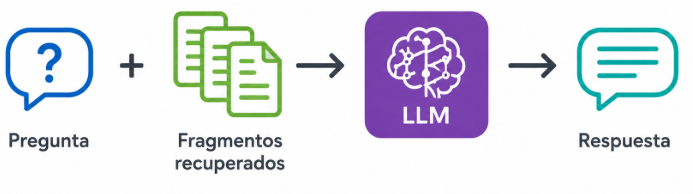
La función del modelo no es sustituir al sistema de recuperación, sino interpretar y sintetizar las evidencias que este ha localizado. En DOCUMENTALIA añadimos una condición esencial: la respuesta debe mantener la relación con los artículos de los que procede la información.
9. Respuesta con fuentes: cerrar el círculo documental
El resultado que buscamos no es simplemente un texto generado, aspiramos a obtener una respuesta trazable, acompañada de las fuentes utilizadas para construirla y, siempre que sea posible, con acceso al artículo correspondiente. Esto permite al usuario pasar de la respuesta generada al documento original y comprobar la evidencia. En una aplicación sobre artículos científicos como es nuestro proyecto, esta trazabilidad es especialmente importante porque la respuesta no debe convertirse en el punto final de la búsqueda, sino en una nueva vía de acceso a los documentos (artículos científicos) que contienen el conocimiento recuperado.
Hay componentes que atraviesan toda la arquitectura
El esquema de DOCUMENTALIA incorpora además varias capas transversales.
- El control de calidad debe comprobar que la extracción y normalización son correctas.
- Los identificadores persistentes mantienen la identidad y trazabilidad de los documentos.
- El registro y la monitorización permiten conocer qué ocurre durante los procesos automáticos y localizar incidencias.
Finalmente, la ética y la transparencia afectan al sistema completo: procedencia de la información, trazabilidad de las fuentes, tratamiento de los documentos y uso responsable de los modelos de inteligencia artificial. No son etapas que ocurran al final, son requisitos que acompañan a todo el proceso.
No todo es inteligencia artificial
En la anterior entrada ya hacíamos mención a esta cuestión, reincidimos en ella. La arquitectura general del proyecto permite extraer una primera conclusión: no se trata únicamente de un problema de inteligencia artificial, es también un problema de gestión documental, representación de información, bases de datos y recuperación de información.
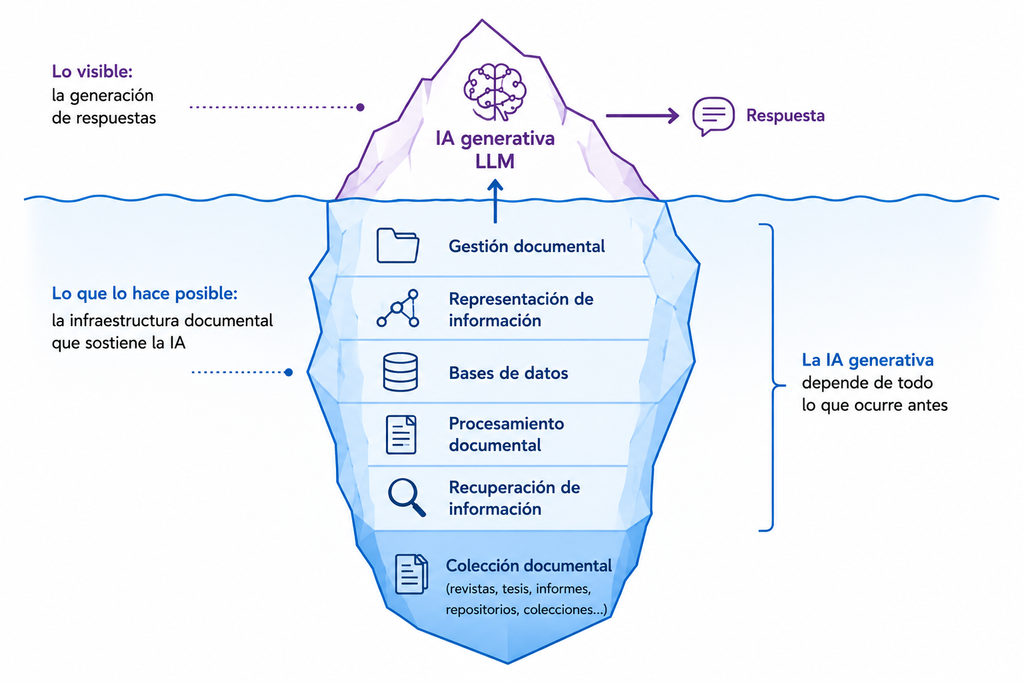
Antes de que un modelo de lenguaje pueda generar una respuesta habrá que seleccionar los documentos, interpretarlos, estructurar su información, almacenarla, dividir su contenido, representarlo y recuperar las evidencias adecuadas. La IA generativa ocupa una posición importante en la arquitectura, pero depende de todo lo que ocurre antes. Esta perspectiva es especialmente relevante en DOCUMENTALIA porque queremos comprobar hasta qué punto esta arquitectura puede reutilizarse con otras colecciones: repositorios institucionales, revistas, tesis doctorales, informes técnicos, colecciones patrimoniales o bibliotecas digitales.
¿Por dónde empezamos?
Se puede decir que ya disponemos del mapa general, toca ahora comenzar a recorrerlo de izquierda a derecha. El primer obstáculo apareció muy pronto: los artículos de las revistas no tienen todos la misma estructura ni están disponibles en el mismo formato de fichero. El gran problema han sido las maquetaciones, aspecto que podría parecer insignificante ante la potencia de la tecnología LLM, se ha convertido en un problema, tanto por los cambios de plantilla como por los muchos fallos a la hora de editar los artículos (es difícil encontrar tres o cuatro seguidos «bien maquetados»). Muchas formas de escribir en la Ciencia han cambiado con los años, también ha cambiado la norma para las referencias bibliográficas y existen artículos de investigación, reseñas, editoriales y otros tipos de documentos.
Por tanto, antes de construir embeddings o conectar un modelo de lenguaje, ha habido que resolver una cuestión mucho más básica: ¿cómo convertir una colección de documentos heterogéneos en un corpus estructurado que una máquina pueda interpretar de forma consistente?
Con suerte, lo podremos explicar en la siguiente entrada.