artículos científicos

Enseñar a un parser a leer 30 años de artículos

Construir un parser capaz de extraer información de un artículo científico es, hoy en día, algo sencillo (relativamente) cuando todos los documentos siguen una misma estructura, pero, tal como se comentaba en la entrada anterior, esto cambia cuando se deben procesar casi 30 años de publicaciones, espacio de tiempo en el que ha cambiado el diseño de las revistas, la presentación de los autores, resúmenes, palabras clave y referencias bibliográficas e incluso los formatos de publicación (sin olvidarnos de identificadores como DOI u ORCID que no existían a principios de siglo).
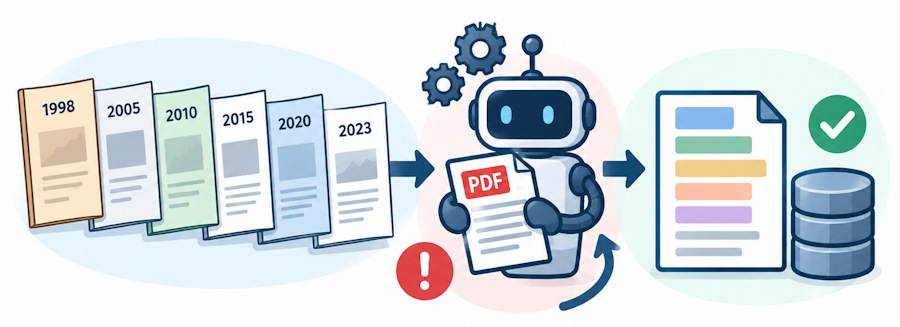
Enseñar a un parte durante casi 30 años, metáfora global.

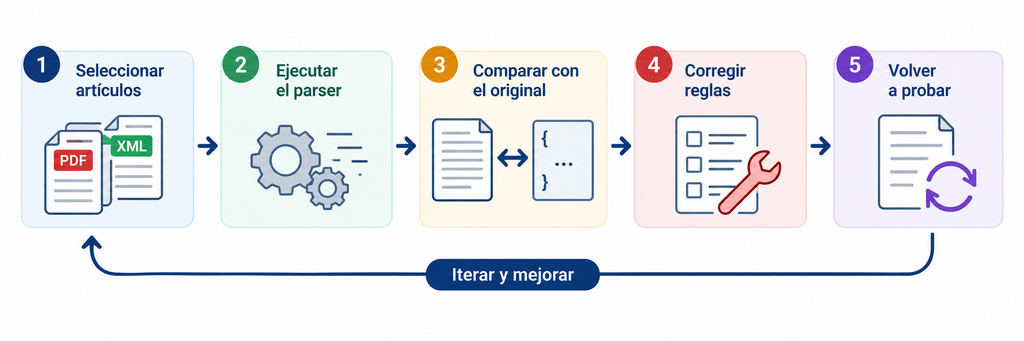
Esta ha sido una de las principales dificultades encontradas durante el desarrollo de DOCUMENTALIA. No buscamos que el parser funcione con unos cuantos artículos recientes, sino que sea capaz de reconocer de forma consistente la estructura de documentos publicados en épocas y condiciones editoriales diferentes. Para conseguirlo, ha habido que enseñar al parser de forma progresiva: seleccionar una muestra de artículos de distintos años, ejecutar el script, comparar los datos obtenidos con los originales, localizar errores, modificar las reglas y volver a probar. La experiencia muestra que un corpus histórico no contiene únicamente documentos antiguos y modernos; contiene distintas formas de representar la información que se han sucedido a lo largo del tiempo.

Un mismo artículo, muchas formas de representarlo

Cuando una persona lee un artículo. reconoce el título, los autores o la bibliografía, es un proceso que suele resultar sencillo. Después utilizamos el contenido, la posición, la tipografía y nuestro conocimiento de cómo se organiza el mismo. Un parser de PDF debe convertir esos indicios en reglas: dónde aparece una línea, qué hay antes y después, cómo comienza una referencia o qué patrones permiten reconocer un correo electrónico, una fecha o un DOI (son las directrices gramaticales formales que determinan cómo se estructuran, agrupan y validan los tokens de una cadena de entrada).

Una regla que funciona con los artículos de un determinado año puede fallar cuando cambia la plantilla de la revista. En DOCUMENTALIA, además, el corpus incluye artículos de Anales de Documentación y Cuadernos de Gestión de Información publicados en épocas diferentes y con muchos cambios en las plantillas (especialmente en la primera revista que es la más longeva).

El parser no tiene que aprender una plantilla: debe reconocer las regularidades que permanecen detrás de plantillas diferentes. Las primeras pruebas mostraron que los fallos no siempre son evidentes y que pasan prácticamente desapercibidos a nuestros ojos. El script puede terminar correctamente y generar un fichero JSON donde guardar la información que ha identificado, aparentemente completo, pero con malas interpretaciones de algunos elementos. Por ejempo, hemos encontrado afiliaciones de autores interpretadas como autores («Universidad de Córdoba» por «Juana López. Universidad de Córdoba»), líneas incorporadas indebidamente al título, palabras clave mal separadas (esto ha sido más frecuente de lo esperado), resúmenes en distintos idiomas mezclados, párrafos considerados encabezados de sección o referencias bibliográficas partidas o fusionadas (algo demasiado frecuente que luego dificulta el cómputo de las citas a esos artículos por parte de los índices). Todos estos errores muestran el mismo problema: extraer el texto de un PDF no equivale siempre a comprender su estructura documental.
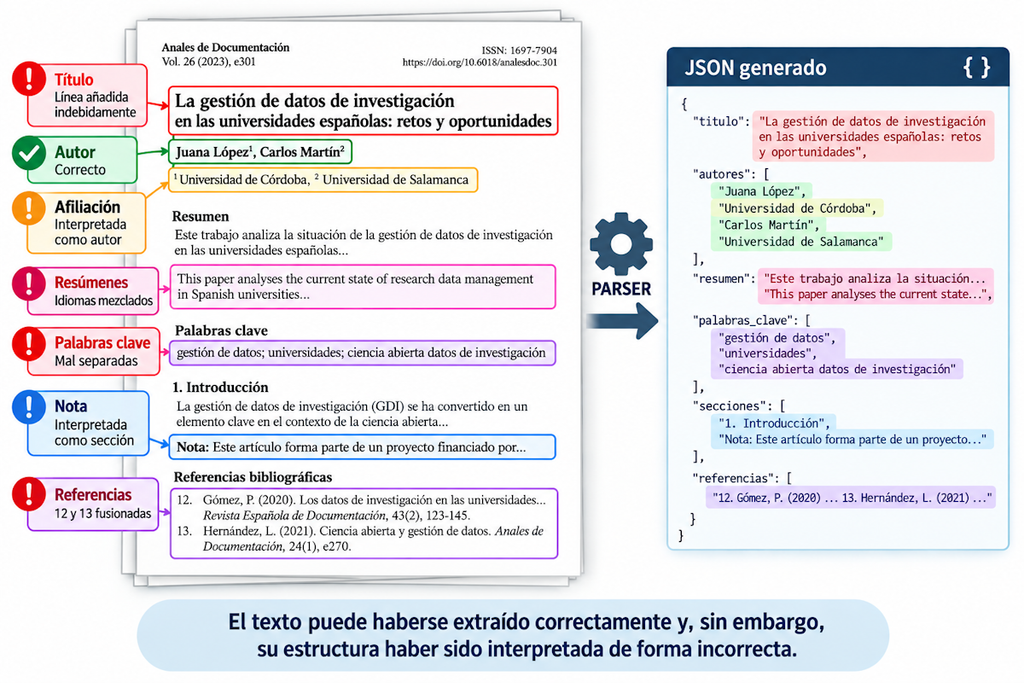
Posibles fallos en la interpretación automática del contenido de un artículo científico.
Cuando el texto es correcto pero la estructura no.

En el ejemplo de la imagen observamos que Autor está bien reconocido; la Afiliación se confunde con un autor; el Título tiene una línea añadida; la Nota se considera una sección y las Referencias 12 + 13 se han fusionado (error).

El parser debe viajar hacia atrás en el tiempo

Una parte especialmente interesante ha consistido en probar el parser con números cada vez más antiguos. Los documentos publicados en 1998, por ejemplo, plantearon unos problemas apenas presentes en artículos recientes: títulos y metadatos, autorías corporativas, palabras clave, segmentación de secciones o bibliografía. También se fueron incorporando a la revista tipos documentales, como reseñas y traducciones, cuya estructura no coincide con la de un artículo de investigación convencional o un artículo que recoge una experiencia aplicada (caso práctico). Con documentos más recientes han aparecido otros problemas: en artículos de 2022 tuvimos que tratar títulos traducidos truncados, notas numeradas interpretadas como secciones y referencias bibliográficas fusionadas.

Otro caso ilustrativo de la serie de fallos aparecidos fue en un artículo de Cuadernos de Gestión de Información de 2023. El número de referencias extraídas parecía correcto —53—, pero dos estaban truncadas. Una regla utilizada para eliminar números de página alteraba la reconstrucción del texto al cambiar de página y columna. Su corrección permitió recuperar las referencias completas sin alterar su número. Este ejemplo resume bien el problema: los indicadores cuantitativos pueden ser correctos y esconder errores cualitativos en la extracción de información.
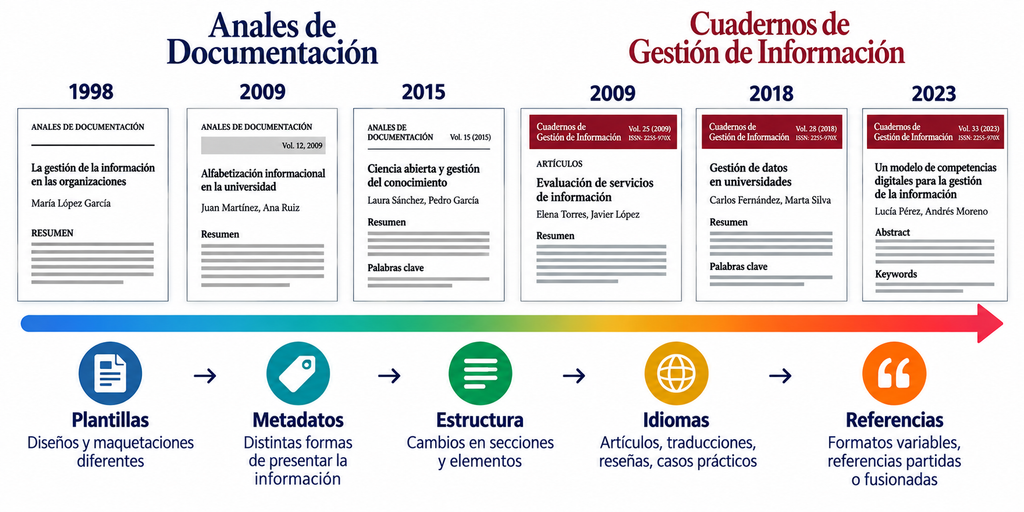
Casi treinta años de revistas: muchas formas de publicar

Corregir un error puede crear otro

Hay que ser consciente de que. al modificar una regla para resolver un problema, se puede provocar que un documento que antes se procesaba sin problemas deje de hacerlo (es lo que se conoce como «regresión», problema que ocurre cuando una modificación introduce un fallo en un comportamiento que anteriormente funcionaba. Por ello, no basta con volver a procesar el artículo que provocó el cambio, debemos reprocesar documentos que sí funcionaban, las correcciones deben verificarse con el mayor alcance posible. Esta forma de proceder se convirtió en una regla básica durante el afinado de DOCUMENTALIA: corregir el documento que falla no es suficiente: la modificación debe funcionar sin estropear los documentos que ya funcionaban.

Las excepciones son necesarias, pero también peligrosas

Cuando se presentaba un documento problemático (en Anales de Documentación hay un número donde el encabezado de la primera página de cada artículo es la referencia bibliográfica de ese artículo, por ejemplo), es tentador (y lógico) programar una excepción específica. De hacer lo mismo varias veces, terminaríamos elaborando un parser formado por una acumulación de casos particulares, difícil de mantener y poco preparado para documentos nuevos (y sus casuísticas). Por esta razón, hemos intentado distinguir entre excepciones documentales y regularidades editoriales. Cuando aparece un error no nos preguntamos únicamente cómo hacemos que «funcione ese artículo», la cuestión a resolver es ¿qué característica ha provocado el error y en qué otros documentos podría aparecer? Una buena regla del parser debe resolver una clase de problemas, no memorizar un documento dentro del código del script.

No todos los documentos científicos son artículos de investigación

El recorrido por todo el corpus reveló otra fuente de heterogeneidad: el tipo documental. Nuestras revistas publican mayoritariamente artículos de investigación, pero también recogen reseñas, traducciones u otros contenidos que no contienen los mismos elementos. En nuestras pruebas, por ejemplo, las reseñas de Anales de Documentación carecen de los elementos habituales de un artículo (resúmenes o palabras clave), lo que es normal y no constituye un error. El error sería obligar al parser a encontrar información que ese documento no contiene. Por tanto, la ausencia de un campo no siempre significa que la extracción haya fallado. Para interpretar el resultado también debemos conocer qué tipo de documento estamos procesando y se han introducido rutinas para identificarlo de forma automática.

El «afinado»: del artículo problemático a una regla más general

Este proceso de refinamiento puede resumirse del siguiente modo: documento → extracción → comparación → error → explicación → regla → nueva prueba → regresión

La fase fundamental es explicar el error. Si dos referencias aparecen unidas, no basta con separarlas, es necesario determinar por qué ocurrió. Las causas pueden ser variadas: ¿un salto de página?, ¿un cambio de columna?, ¿una referencia con una estructura diferente?, ¿una línea eliminada durante el preprocesamiento?, etc. Identificarla permite formular una regla más general y comprobarla sobre otros artículos.
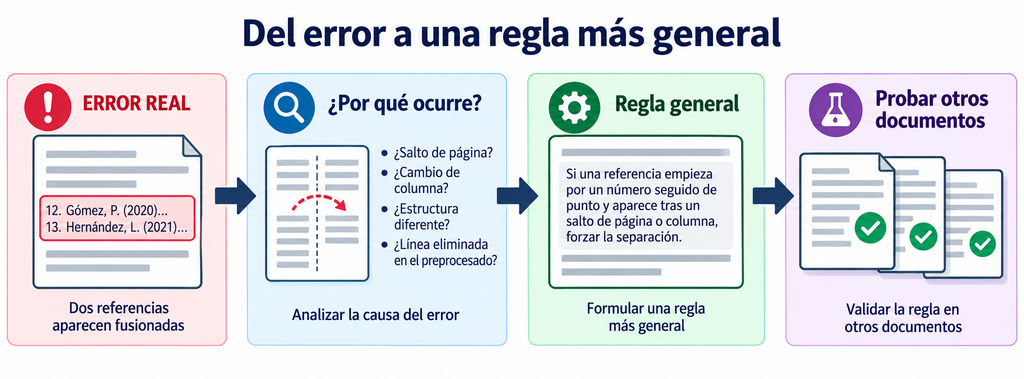
Refinamiento del parser: del error a una regla de alcance más general.

Un parser se construye con un corpus, no con un documento

Tras llevar a cabo numerosas iteraciones, reforzamos la idea de que un parser no se valida porque procese correctamente un artículo, sino porque podamos observar que mantiene un comportamiento consistente ante la diversidad del corpus. Si solo lo probamos con artículos recientes, habríamos obtenido un script aparentemente eficaz pero incapaz de interpretar una buena parte de la colección histórica. Las pruebas artículo por artículo han permitido descubrir cambios de plantilla, estructuras poco frecuentes, distintos tipos documentales y errores inesperados.

Pero este procedimiento tiene un límite. Revisar cuidadosamente cinco, diez o veinte artículos sirve para construir y corregir reglas. No demuestra que esas reglas funcionen sobre centenares de documentos.

De enseñar al parser a ponerlo a prueba

Cuando las principales reglas se estabilizan es necesario cambiar la escala de la prueba. En nuestro proyecto hemos pasado de revisar artículos de forma individual y/o pequeños conjuntos a ejecutar el parser sobre muestras aleatorias mucho mayores, algunas de hasta 200 artículos, buscando verificar si las reglas generalizan, localizan anomalías poco frecuentes y detectan regresiones. El resultado ha sido altamente positivo debido a la gran cantidad de cambios que habíamos ido introduciendo de forma previa con muestras más pequeñas. La diferencia entre ambas fases puede resumirse en dos preguntas:

  • Afinado: «¿Por qué falla este documento?»
  • Validación: «¿Con qué frecuencia falla el parser y qué errores siguen apareciendo?»

El cambio de escala nos lleva al siguiente paso: determinar cuándo el parser está suficientemente estabilizado para procesar el corpus completo y podemos incorporar los resultados a la base de datos de DOCUMENTALIA.
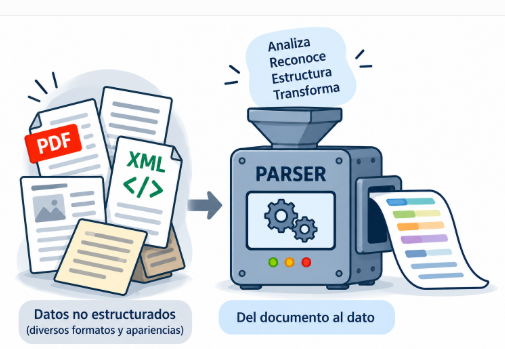
El parser transforma artículos en datos

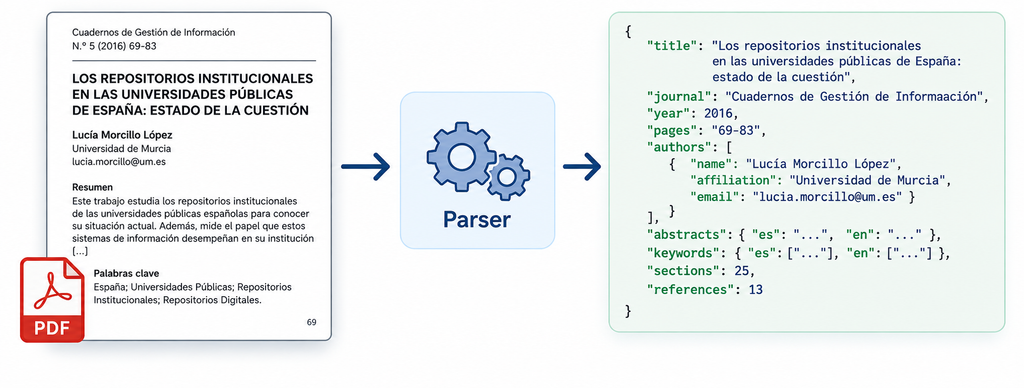
Esquema del funcionamiento de un parser: transforma documentos no estructurados en formatos PDF y XML en datos identificados y estructurados para su posterior recuperación.

En la entrada anterior hemos intentado mostrar la arquitectura general de DOCUMENTALIA, finalizando con una pregunta aparentemente sencilla: ¿cómo convertir una colección de artículos científicos heterogéneos en un corpus estructurado para que una «máquina» pueda interpretarla de forma consistente? Podemos contestar que la pregunta ha terminado ocupando buena parte de las primeras semanas de desarrollo centradas casi en exclusiva en el parser. Vamos a intentar explicarlo.

Antes de pasar a generar embeddings, realizar búsquedas semánticas o conectar el proyecto con un LLM, debemos saber qué contiene cada artículo: cuál es su título, identificar los autores, tener claro dónde empieza y termina el resumen, cuáles son sus palabras clave, qué secciones forman el texto o qué referencias bibliográficas contiene (entre otras cosas). Un ser humano reconoce casi inmediatamente esa estructura al mirar una página, en cambio, un programa informático tiene que aprender a reconocerla.

Comenzamos: un artículo es algo más que su texto

Podemos sintetizar el esquema de un artículo científico como: Artículo → metadatos + contenido estructurado + referencias.

Hay que tener claro que la diferencia entre obtener texto y obtener información estructurada es fundamental. Si extraemos de un archivo PDF las palabras que contiene, hemos recuperado su texto, lo que es un primer paso, aunque todavía necesitamos determinar qué palabras corresponden al título, cuáles identifican a los autores, cuáles pertenecen al resumen o dónde comienza una determinada sección: extraer texto es recuperar las palabras de un artículo; extraer su estructura es identificar qué función desempeña cada parte de ese texto.

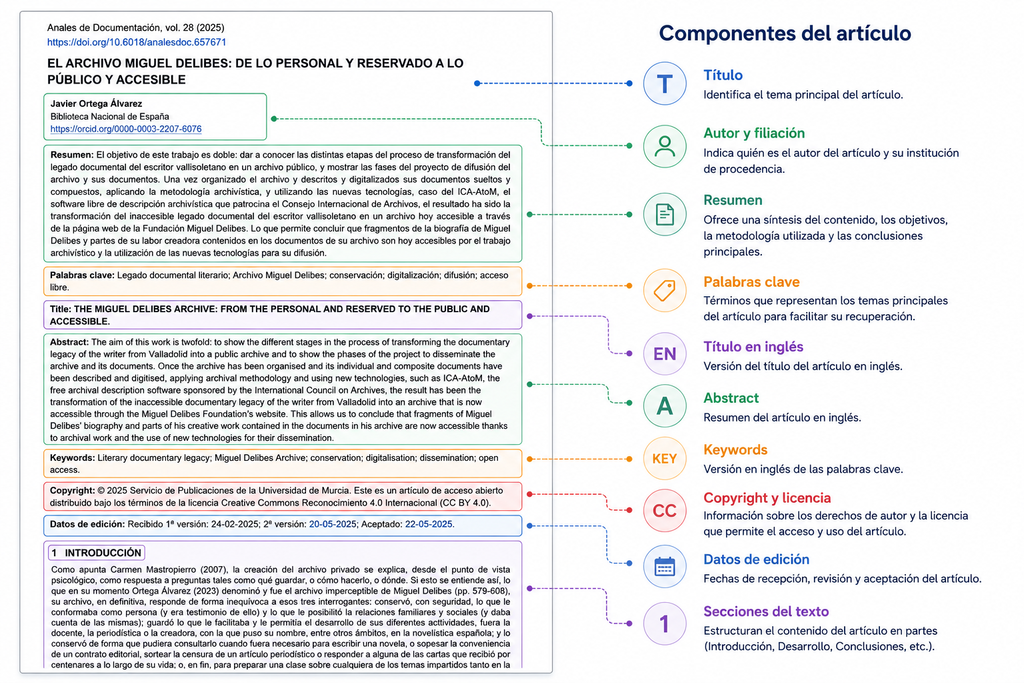
Representación de un artículos científico de Anales de Documentación
De la página al artículo: sus componentes.

Esta estructura es importante para casi todo lo que se debe hacer posteriormente: va a permitir almacenar correctamente los artículos, fragmentarlos con mayor criterio, recuperar evidencias dentro de determinadas secciones y, algo muy interesante en este proyecto que sirve para el estudio de la literatura científica, relacionar cada resultado con su fuente original.

El parser: convertir documentos en datos

El programa encargado de realizar esta tarea se denomina parser, aplicación que transforma y preprocesa datos no estructurados. En DOCUMENTALIA utilizamos este término para referirnos al programa que analiza un documento, reconoce los elementos que nos interesan y los transforma en datos estructurados que puedan ser procesados posteriormente. Nosotros intentamos identificar, entre otros elementos: título, revista, año, volumen y número; autores y afiliaciones; DOI y otros identificadores; resúmenes y palabras clave; secciones y subsecciones; y referencias bibliográficas. El esquema básico parece sencillo: Documento → parser → datos estructurados

En la práctica, la salida del parser adopta una estructura organizada en campos. El documento deja de ser únicamente una sucesión de páginas y texto: el título se identifica como título, un autor como autor, cada resumen queda asociado a su idioma y las secciones conservan su posición y nivel dentro del artículo. Así, la información que en el artículos editado en PDF estaba destinada a la lectura por parte de una persona (de muchas a poder ser), pasa ahora a estar identificada, estructurada y preparada para su tratamiento automático.

cionamiento y propósito del módulo parser.

El problema va a aparecer cuando observamos los documentos de entrada y percibimos los problemas que genera no tener un formato común (o mínimamente común).

XML-JATS y PDF: dos formas muy distintas de representar un artículo

Una parte de los artículos más recientes está disponible en XML-JATS, mientras que la mayor parte del corpus histórico está formada por PDF. Como ya señalamos en la entrada anterior, ambos formatos plantean cuestiones en la extracción diferentes.

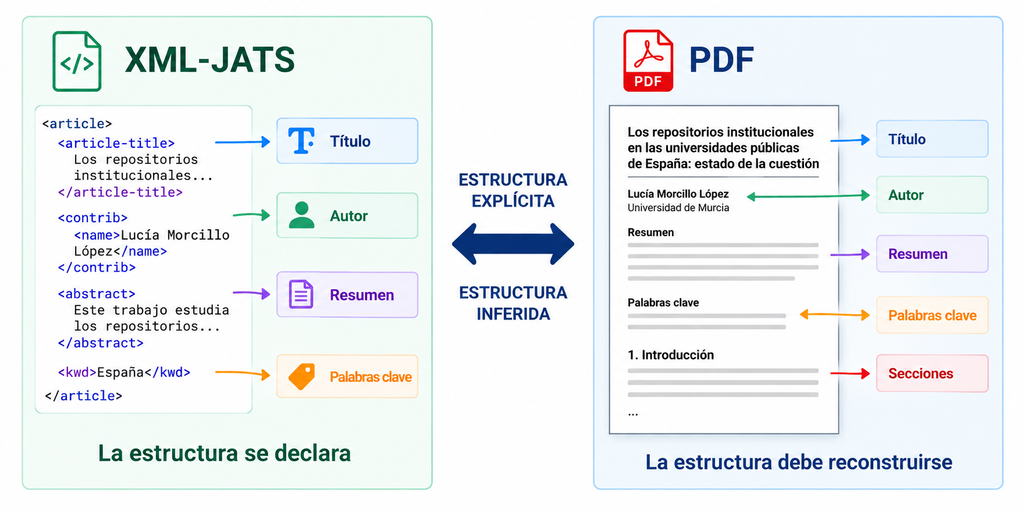
JATS (Journal Article Tag Suite) es un estándar XML concebido específicamente para representar artículos científicos. En un documento XML-JATS encontramos estructuras semejantes a «<article-title>El título del artículo</article-title>» donde el propio documento está indicando que ese texto es el título. También existen etiquetas para autores, resúmenes, palabras clave, secciones o referencias bibliográficas. El parser debe interpretarlas, pero dispone de una ventaja fundamental: la estructura está expresada explícitamente en el documento. Con los documentos PDF la situación cambia porque las personas vemos una página y reconocemos el título fácilmente sabiendo que debajo aparecen los autores y que posteriormente comienza el resumen. En este formato, se conserva perfectamente esa apariencia visual sin gtener que decir explícitamente que cada uno de esos elementos cumple esas funciones. Por tanto, en los artículos en formato XML-JATS la estructura está declarada; en los documentos PDF la estructura debe ser reconstruida.

Diferencias en la estructura de los artículos XML-Jats y los editados en PDF
Diferencias entre la estructura de los artículos XML-Jats y los editados en PDF

El problema no es solo el formato PDF: son los 30 años de PDFs

Si todos los artículos hubieran utilizado exactamente la misma plantilla, reconstruir esa estructura habría sido bastante más sencillo, pero no ha sido el caso. Anales de Documentación comenzó a publicarse a finales de los años noventa y durante ese tiempo han cambiado sus diseños, las tecnologías utilizadas para la edición y algunas convenciones editoriales, incluso la norma requerida para elaborar las referencias bibliográficas que cambió de ISO-690 a APA 7th. Además, nuestro proyecto incorpora una segunda revista (de vida más corta), Cuadernos de Gestión de Información, con su propia maquetación y con una forma de redactar la bibliografía no muy convencional. Por eso no existe realmente una única estructura sobre la que podamos escribir un conjunto fijo de reglas.

Se han hallado documentos escritos a una o dos columnas; autores y afiliaciones en diferentes posiciones; uno, dos o tres resúmenes; distintas formas de presentar palabras clave; varios sistemas de numeración de secciones; cambios en las referencias bibliográficas; DOI en los artículos recientes y otros identificadores en documentos anteriores. Incluso las reseñas han cambiado el formato de escritura con el paso de los años.

El problema más persistente ha sido que los documentos reales no siempre respetan perfectamente la plantilla editorial que deberían seguir, y no han sido fallos puntuales. Por ello. una diferencia apenas perceptible para una persona puede ser suficiente para que una regla automática interprete incorrectamente un elemento. Eso explica por qué la maquetación a nivel interno de nuestra base de datos, algo que inicialmente parecía secundario, se ha convertido en uno de los principales problemas técnicos del proyecto (el que más ha costado arreglar, de momento).

Durante el desarrollo apareció enseguida una necesidad muy práctica: necesitábamos saber qué estaba leyendo el parser. Antes de introducir automáticamente cientos de artículos en la base de datos teníamos que comprobar qué se estaba realmente interpretando. Por eso incorporamos una salida intermedia en formato JSON para revisarla debidamente, introducir cambios en el algoritmo, volver a validar y, si no ya se veían las deficiencias corregidas, cargar los artículos en la base de datos. El fichero JSON funciona como una especie de «radiografía» de la interpretación realizada por el programa. Con esa información, hemos sido capaces de verificar si el parser había encontrado correctamente el título, cuántos autores había reconocido, qué resúmenes se habían extraído, cómo se habían dividido las secciones o cuántas referencias bibliográficas se identificaban. Además, podíamos saber dónde residía el problema, pedirle a chatGPT que corrigiera el código del script y continuar revisando.

Debemos tener claro que un «OK» en esa revisión no significa necesariamente que todo esté bien. De hecho, esta ha sido una de las lecciones prácticas de DOCUMENTALIA. El parser podía ejecutar un documento sin producir ningún error de tipo informático y, sin embargo, interpretarlo incorrectamente, confundiendo lugar de trabajo con el nombre del autor o autora, incorporando una línea al título, no reconociendo determinadas palabras clave por no estar bien separadas en el texto, cortando una sección antes de tiempo o dividiendo (o uniendo) las referencias bibliográficas incorrectamente. Por eso hemos tenido que contrastar los resultados inciales con el artículo original sucesivamente y el desarrollo del parser ha terminado convirtiéndose en un proceso iterativo:

Secuencia de diseño del parser de DOCUMENTALIA

Aquí aparece además un problema conocido en desarrollo de software: corregir un caso puede estropear otro. Una regla introducida para interpretar correctamente un aspecto de una plantilla específica puede interferir con otra utilizada en artículos de una época diferente. Por ello no ha bastado con volver a procesar el documento que provocó la modificación: ha habido que verificar que la nueva regla no introducía errores en la extracción de información de artículos que antes funcionaba (como dato, vamos a comenzar la carga masiva esta misma semana y ya llevamos 26 versiones del parser).

Existía una solución sencilla, pero poco recomendable: añadir una regla específica para cada documento que falla. Esto no nos servía porque no queremos construir un parser lleno de excepciones. Si el artículo A da problemas y escribimos una excepción para A, luego, al fallar el B, añadimos otra y así sucesivamente, probablemente conseguiríamos que todo el corpus acabara procesándose correctamente, pero estaríamos construyendo un programa para unos documentos concretos, no un parser suficientemente generalizable. Nuestro objetivo es diferente: identificar regularidades documentales y convertirlas en reglas generales evitando, si es posible, recurrir a excepciones particulares.

Lo cierto es que un corpus real contiene anomalías y es posible que algunas tengan que tratarse específicamente. Pero es importante distinguir entre una nueva regularidad no reconocida previamente y una peculiaridad exclusiva de un documento. Esta diferencia determina hasta qué punto el trabajo realizado en DOCUMENTALIA puede reutilizarse posteriormente con otras colecciones.

¿Cuántos artículos tenemos que comprobar?

He aquí otra cuestión práctica. Si nuestro objetivo es automatizar la extracción de varios centenares de artículos, revisar manualmente todos ellos eliminaría buena parte de la ventaja de utilizar un parser, pero testear un reducido grupo de documentos tampoco proporcionaría suficiente certeza de estar haciéndolo bien. La estrategia seguida ha sido construir un muestreo deliberadamente heterogéneo buscando cantidad y variabilidad. Se han seleccionado documentos de diferentes años de ambas revistas, diversas maquetaciones, varios idiomas y tipos documentales diferentes. También han resultado especialmente útiles los artículos próximos a momentos en los que sabemos que cambió el diseño editorial. Cada nueva muestra sirve para responder a la misma pregunta: ¿siguen funcionando las reglas del parser al aplicarlas a documentos diferentes de aquellos con los que fueron diseñadas?

Este cambio de perspectiva es importante porque va más alla de demostrar que el parser funciona con los artículos que ya hemos utilizado para corregirlo. Queremos aumentar nuestra confianza en que funcionará con los documentos que todavía no hemos revisado.

De la prueba artesanal a la prueba masiva

Las primeras fases de afinado se realizaron revisando pequeños grupos de artículos de diferentes años. Viendo que la presencia de singularidades era muy frecuente, se decidió revisar alrededor de cuatro artículos por número editado de las dos revistas. Además de los artículos científicos (el grueso del corpus), se testeó el parser con traducciones y reseñas. En el caso de los ficheros editados en XML-JATS, se han utilizado todos porque sólo llevamos dos números editando con ese formato. Ese procedimiento ha sido indispensable y ha permitido observar con detalle los tipos de errores y entender por qué se producen.

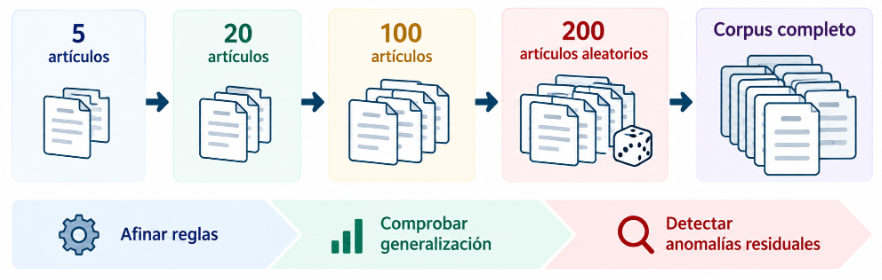
En una fase posterior, previa a la ingesta masiva de documentos a la base de datos, se necesita cambiar de escala. Esto ocurre cuando las reglas básicas parecen razonablemente estables. Hemos ejecutado el parser sobre muestras mucho mayores y se han analizado sistemáticamente los resultados. Este es precisamente el punto en el que nos encontramos mientras escribimos esta entrada: hemos pasado de probar cuidadosamente artículos individuales y pequeños conjuntos a comprobar el comportamiento del parser sobre muestras aleatorias mucho mayores del corpus, algunas de ellas de hasa 200 artículos. El objetivo es localizar errores menos evidentes, regresiones y casos que todavía no habíamos encontrado.

Validación del parser de DOCUMENTALIA mediante muestras crecientes de 5, 20, 100 y 200 artículos aleatorios antes de procesar el corpus completo, para afinar reglas, comprobar su generalización y detectar anomalías residuales.
DOCUMENTALIA: de las pruebas iniciales a la validación masiva del parser.

Primero los datos, después la IA

Todo esto ocurre antes de producir un solo embedding. Estamos convencidos de que este trabajo condicionará directamente la calidad de lo que hagamos después (y más en este caso que estamos aprendiendo cómo construir un buscador de esta naturaleza). Una estructura documental fiable permitirá crear mejores fragmentos, conocer de qué sección procede cada evidencia, filtrar por metadatos, relacionar los resultados con sus autores y proporcionar al usuario el DOI o el enlace del artículo original.

La metáfora general puede resumirse así: la calidad de la búsqueda futura depende en buena medida de la calidad de los datos que consigamos extraer ahora.

Un modelo LLM puede interpretar muy bien un fragmento de texto, pero no puede corregir automáticamente todos los problemas provocados por una extracción defectuosa o por la pérdida de contexto documental. Como DOCUMENTALIA aspira a generar respuestas trazables hasta los artículos originales, conservar correctamente la estructura y la identidad de los documentos es apropiado e importante. En la arquitectura ya publicada, el control de calidad y los identificadores persistentes aparecen precisamente como elementos transversales del sistema.

Lo que casi treinta años de artículos están enseñando al parser

El trabajo de extracción ha producido un resultado que no estaba entre los objetivos iniciales del proyecto. Al revisar documentos de diferentes épocas, se ha reconstruido de facto una pequeña historia de las regularidades, cambios y anomalías de maquetación de las revistas. Algunas diferencias eran previsibles: nuevas plantillas, cambios en las normas bibliográficas o la aparición del DOI (hace casi 30 años no existía). Otras lo eran bastante menos: se han encontrado casos en los que una tabla altera la interpretación del documento, reseñas cuya estructura se alejaba completamente de la de un artículo convencional, referencias que requerían reglas diferentes según la época o elementos aparentemente triviales que hacen fallar una extracción que funcionaba perfectamente en decenas de documentos anteriores (muchas veces porque el editor del documento impreso introdujo en un número un texto adicional o un elemento visual que luego no volvió a aparecer). También ha resultado curioso encontrar artículos publicados sin un apartado de bibliografía porque las referencias iban como nota a pie de página.

Esta serie de casuísticas son precisamente los que más han ayudado a mejorar el parser, y también los que mejor permiten explicar cómo se construye realmente un sistema de este tipo. En la próxima entrada profundizaremos en el «laboratorio del parser PDF«: veremos algunos de esos errores reales, cómo los hemos detectado y qué modificaciones nos han obligado a introducir en el código fuente del script.

DORA: Declaración de San Francisco sobre la evaluación de la investigación.

Logotipo de la declaración DORADe largo existe un amplio debate sobre la necesidad de mejorar la forma en que las agencias de financiación, las instituciones académicas y otros grupos de interés evalúan la investigación científica. Para abordar este tema, en diciembre del año 2012, un grupo de editores de revistas científicas se reunió en San Francisco aprovechando el encuentro anual de la American Society for Cell Biology (ASCB). Este grupo desarrolló una serie de recomendaciones, conocidas como la Declaración de San Francisco sobre la Evaluación de la Investigación, invitando a los grupos de investigación interesados de todas las disciplinas científicas a mostrar su apoyo añadiendo su nombre a esta declaración.
Como todos sabemos, los productos de la investigación científica son muchos y variados, e incluyen: artículos científicos que informan de los avances de la ciencia y de la generación de nuevos conocimientos, datos, reactivos y software; propiedad intelectual y también sirven para conocer el trabajo de jóvenes científicos capacitados. Las agencias financiadoras, las instituciones que emplean a los científicos y ellos mismos, tienen la necesidad de evaluar la calidad y el impacto de los resultados de sus investigaciones. Y siempre ha existido una discusión permanente sobre si el método tradicional de evaluación (basado fundamentalmente en el factor de impacto de la revista científica donde se publica nuestros trabajo) representa de verdad la calidad del mismo. En estos momentos ya es imperativo que la producción científica se mida con precisión y prudencia.

Entrada al Instituto de Información de Filadelfia, donde se creó el Factor de Impacto.
Entrada al Instituto de Información de Filadelfia

El factor de impacto se utiliza con frecuencia como parámetro principal con el que comparar la producción científica de individuos e instituciones. Este factor fue calculado, en un principio por Eugene Gardfield en el Instituto de Información de Filadelfia, luego Thomson Reuters y ahora por Clarivate Analytics, se creó originalmente como una herramienta para ayudar a los bibliotecarios a identificar las mejores revistas para completar las colecciones de sus instituciones, no como indicador de la calidad científica de un artículo. Teniendo esto en cuenta, es fundamental comprender que el factor de impacto tiene una serie de deficiencias bien documentadas como herramienta para la evaluación de la investigación.

Estas limitaciones incluyen:

  1. Las distribuciones de citas dentro de las revistas son muy sesgadas (Adler, Ewing y Taylor, 2008).
  2. Las propiedades del factor de impacto son específicas de cada campo: es un compuesto de múltiples tipos de artículos altamente diversos, incluyendo trabajos de investigación primaria y revisiones (Vanclay, (2012).
  3. Los factores de impacto pueden ser manipulados (o evaluados) por la política editorial (The PLoS Medicine Editors, 2006), y
  4. los datos utilizados para calcular el factor de impacto no son transparentes ni están abiertamente disponibles para el público [4, 6, 7]. (Vanclay, (2012), (Rossner et al., 2007) y (2008).

Recomendaciones

El grupo de trabajo reunido en San Francisco elaboró un conjunto de recomendaciones para mejorar la forma en la que se evalúa la calidad de la producción científica. Los productos que no sean artículos científicos crecerán en importancia a la hora de evaluar la eficacia de la investigación en el futuro, pero el documento por excelencia de la comunicación de los avances en la investigación revisado por pares seguirá siendo primordial para la evaluación de la investigación. Por lo tanto, estas recomendaciones se centran en las prácticas relacionadas con los artículos científicos publicados en revistas revisadas por pares, pero se puede y se debe ampliar su alcance recogiendo elementos adicionales, como los conjuntos de datos, ya que son productos de investigación importantes. Las recomendaciones se dirigen a las agencias financiadoras, instituciones académicas, revistas, organizaciones que proporcionan métricas e investigadores individuales y cubren:

  • La necesidad de eliminar el uso de métricas basadas en revistas, tales como el factor de impacto, en consideraciones de financiamiento, nombramiento y promoción,
  • La necesidad de evaluar la investigación por sus propios méritos (del autor o autores) en lugar de basarse en la revista en la que se publica la investigación, y …
  • … la necesidad de capitalizar las oportunidades que ofrece la publicación en línea (como flexibilizar los límites innecesarios en el número de palabras, figuras y referencias en los artículos, y explorar nuevos indicadores de importancia e impacto).

Hay que reconocer que bastante agencias financiadoras, instituciones, editores e investigadores ya están fomentando mejores prácticas en la evaluación de la investigación. Dichos pasos están comenzando a aumentar el impulso hacia enfoques más sofisticados y significativos para la evaluación de la investigación que ahora pueden ser desarrollados y adoptados por todas las partes clave involucradas.

Los signatarios de la Declaración de San Francisco sobre la Evaluación de la Investigación apoyan la adopción de las siguientes prácticas en la evaluación de la investigación.

Recomendación general

  1. No utilice métricas basadas en revistas, como el factor de impacto, como una medida sustituta de la calidad de los artículos de investigación individuales, para evaluar las contribuciones de un científico individual, o en las decisiones de contratación, promoción o financiación.

Para las agencias de financiación

  1. Sea explícito sobre los criterios utilizados para evaluar la productividad científica de los solicitantes de fondos de investigación, especialmente para los investigadores que están iniciando su carrera investigadora, que el contenido científico de un artículo es mucho más importante que las métricas de publicación o la identidad de la revista en la que fue publicado.
  2. Con el fin de evaluar la investigación, considere el valor y el impacto de todos los resultados de la investigación (incluidos los conjuntos de datos y el software) además de las publicaciones de investigación, y considere una amplia gama de medidas de impacto que incluyan indicadores cualitativos, como la influencia sobre la política y prácticas científicas.

Para las instituciones

  1. Sea explícito sobre los criterios utilizados para realizar decisiones de contratación, permanencia y promoción, destacando, especialmente para los investigadores que están iniciando su carrera investigadora, que el contenido científico de un trabajo es mucho más importante que las métricas de publicación o la identidad de la revista en la que fue publicado.
  2. Con el fin de evaluar la investigación, se debe considerar el valor y el impacto de todos resultados de la investigación (incluidos los conjuntos de datos y el software) además de las publicaciones de investigación, y considere una amplia gama de medidas de impacto, incluidos los indicadores cualitativos del impacto de la investigación, como la influencia sobre la política y prácticas científicas (el mismo consejo que se le ha dato a las agencias).

Para las editoriales

  1. Reducir profundamente el énfasis en el factor de impacto como herramienta promocional, idealmente dejando de promover su uso o presentando la métrica en el contexto de una variedad de métricas basadas en revistas (por ejemplo, factor de impacto de 5 años, EigenFactor, SCImago, el índice h, tiempo editorial y de publicación, etc.) que proporcionan una visión más amplia del rendimiento de la revista.
  2. Poner a disposición una variedad de métricas a nivel de artículo para alentar un cambio hacia la evaluación basada en el contenido científico de un artículo en lugar de las métricas de publicación de la revista en la que se publicó.
  3. Fomentar las prácticas de la autoría responsable y la provisión de información sobre las contribuciones específicas de cada autor.
  4. Independientemente de que una revista sea de acceso abierto o basada en suscripciones, se deben eliminar todas las limitaciones de reutilización de las listas de referencias en los artículos de investigación y procurar que estén disponibles bajo la dedicación de dominio público de Creative Commons.
  5. Eliminar o reducir las restricciones al número de referencias en los artículos de investigación y, cuando corresponda, ordene la citación de la literatura primaria a favor de las revisiones para dar crédito al grupo o los grupos que primero informaron de un hallazgo.

Para las organizaciones que proporcionan métricas

  1. Ser abiertos y transparentes al proporcionar datos y métodos utilizados para calcular las métricas.
  2. Proporcionar los datos bajo una licencia que permita la reutilización sin restricciones y proporcione acceso computacional a los datos, cuando sea posible.
  3. Especificar que no se tolerará la manipulación inapropiada de las métricas; sea explícito sobre lo que constituye una manipulación inapropiada y qué medidas se tomarán para combatirla.
  4. Tener en cuenta la variación en los tipos de artículos (por ejemplo, revisiones frente a artículos de investigación) y en las diferentes áreas temáticas al utilizar, agregar o comparar métricas.

Para los investigadores

  1. Cuando se participe en comités que toman decisiones sobre financiación, contratación, permanencia o promoción, se deben realizar evaluaciones basadas en el contenido científico en lugar de en métricas de publicación.
  2. Cuando sea apropiado, se debe citar literatura primaria en que las observaciones son referidas primero, en lugar de revisiones para dar crédito donde debe darse.
  3. Utilizar una gama de métricas e indicadores basadas en declaraciones personales y de apoyo, como evidencia del impacto de artículos individuales publicados y otros resultados de investigación.
  4. Impugnar las prácticas de evaluación que dependan indebidamente del factor de impacto y promover y transmitir prácticas que se centren en el valor y la influencia de los resultados de investigación específicos.