revistas científicas

Enseñar a un parser a leer 30 años de artículos

Construir un parser capaz de extraer información de un artículo científico es, hoy en día, algo sencillo (relativamente) cuando todos los documentos siguen una misma estructura, pero, tal como se comentaba en la entrada anterior, esto cambia cuando se deben procesar casi 30 años de publicaciones, espacio de tiempo en el que ha cambiado el diseño de las revistas, la presentación de los autores, resúmenes, palabras clave y referencias bibliográficas e incluso los formatos de publicación (sin olvidarnos de identificadores como DOI u ORCID que no existían a principios de siglo).
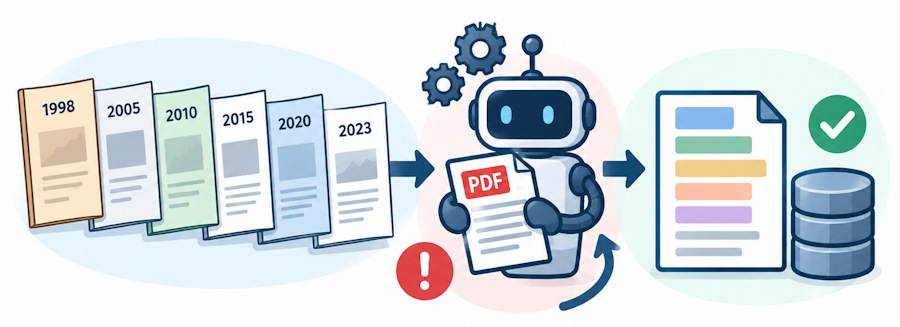
Enseñar a un parte durante casi 30 años, metáfora global.

Esta ha sido una de las principales dificultades encontradas durante el desarrollo de DOCUMENTALIA. No buscamos que el parser funcione con unos cuantos artículos recientes, sino que sea capaz de reconocer de forma consistente la estructura de documentos publicados en épocas y condiciones editoriales diferentes. Para conseguirlo, ha habido que enseñar al parser de forma progresiva: seleccionar una muestra de artículos de distintos años, ejecutar el script, comparar los datos obtenidos con los originales, localizar errores, modificar las reglas y volver a probar. La experiencia muestra que un corpus histórico no contiene únicamente documentos antiguos y modernos; contiene distintas formas de representar la información que se han sucedido a lo largo del tiempo.

Un mismo artículo, muchas formas de representarlo

Cuando una persona lee un artículo. reconoce el título, los autores o la bibliografía, es un proceso que suele resultar sencillo. Después utilizamos el contenido, la posición, la tipografía y nuestro conocimiento de cómo se organiza el mismo. Un parser de PDF debe convertir esos indicios en reglas: dónde aparece una línea, qué hay antes y después, cómo comienza una referencia o qué patrones permiten reconocer un correo electrónico, una fecha o un DOI (son las directrices gramaticales formales que determinan cómo se estructuran, agrupan y validan los tokens de una cadena de entrada).

Una regla que funciona con los artículos de un determinado año puede fallar cuando cambia la plantilla de la revista. En DOCUMENTALIA, además, el corpus incluye artículos de Anales de Documentación y Cuadernos de Gestión de Información publicados en épocas diferentes y con muchos cambios en las plantillas (especialmente en la primera revista que es la más longeva).

El parser no tiene que aprender una plantilla: debe reconocer las regularidades que permanecen detrás de plantillas diferentes. Las primeras pruebas mostraron que los fallos no siempre son evidentes y que pasan prácticamente desapercibidos a nuestros ojos. El script puede terminar correctamente y generar un fichero JSON donde guardar la información que ha identificado, aparentemente completo, pero con malas interpretaciones de algunos elementos. Por ejempo, hemos encontrado afiliaciones de autores interpretadas como autores («Universidad de Córdoba» por «Juana López. Universidad de Córdoba»), líneas incorporadas indebidamente al título, palabras clave mal separadas (esto ha sido más frecuente de lo esperado), resúmenes en distintos idiomas mezclados, párrafos considerados encabezados de sección o referencias bibliográficas partidas o fusionadas (algo demasiado frecuente que luego dificulta el cómputo de las citas a esos artículos por parte de los índices). Todos estos errores muestran el mismo problema: extraer el texto de un PDF no equivale siempre a comprender su estructura documental.
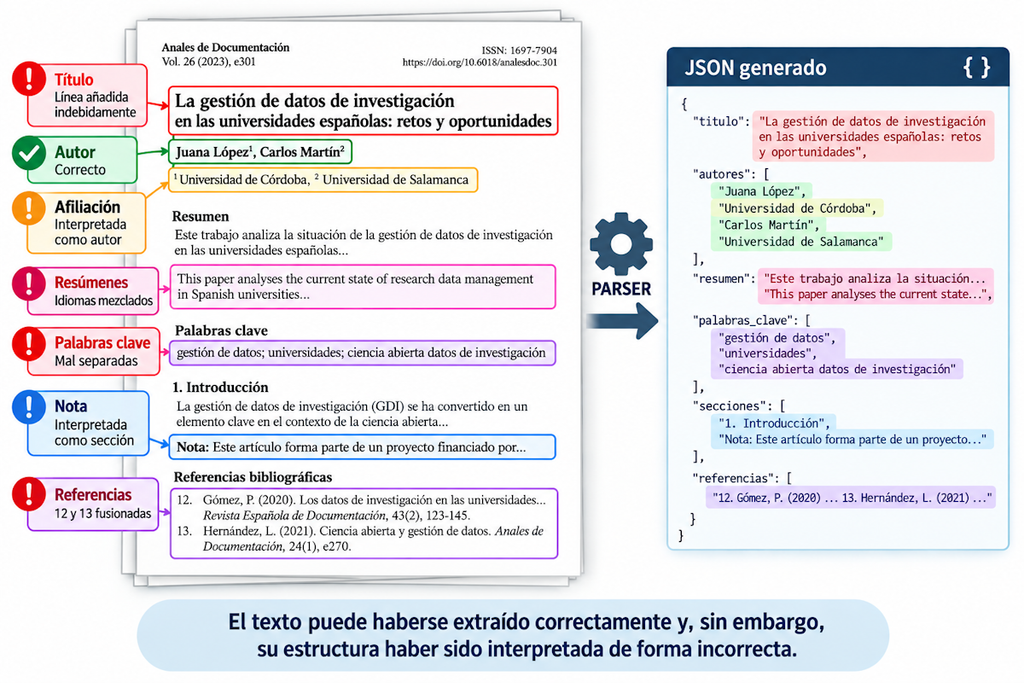
Posibles fallos en la interpretación automática del contenido de un artículo científico.
Cuando el texto es correcto pero la estructura no.

En el ejemplo de la imagen observamos que Autor está bien reconocido; la Afiliación se confunde con un autor; el Título tiene una línea añadida; la Nota se considera una sección y las Referencias 12 + 13 se han fusionado (error).

El parser debe viajar hacia atrás en el tiempo

Una parte especialmente interesante ha consistido en probar el parser con números cada vez más antiguos. Los documentos publicados en 1998, por ejemplo, plantearon unos problemas apenas presentes en artículos recientes: títulos y metadatos, autorías corporativas, palabras clave, segmentación de secciones o bibliografía. También se fueron incorporando a la revista tipos documentales, como reseñas y traducciones, cuya estructura no coincide con la de un artículo de investigación convencional o un artículo que recoge una experiencia aplicada (caso práctico). Con documentos más recientes han aparecido otros problemas: en artículos de 2022 tuvimos que tratar títulos traducidos truncados, notas numeradas interpretadas como secciones y referencias bibliográficas fusionadas.

Otro caso ilustrativo de la serie de fallos aparecidos fue en un artículo de Cuadernos de Gestión de Información de 2023. El número de referencias extraídas parecía correcto —53—, pero dos estaban truncadas. Una regla utilizada para eliminar números de página alteraba la reconstrucción del texto al cambiar de página y columna. Su corrección permitió recuperar las referencias completas sin alterar su número. Este ejemplo resume bien el problema: los indicadores cuantitativos pueden ser correctos y esconder errores cualitativos en la extracción de información.
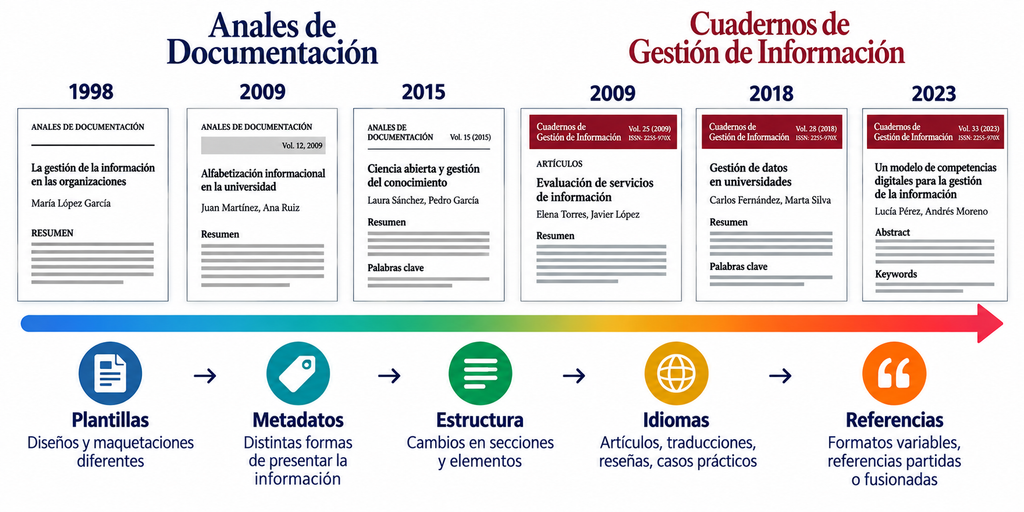
Casi treinta años de revistas: muchas formas de publicar

Corregir un error puede crear otro

Hay que ser consciente de que. al modificar una regla para resolver un problema, se puede provocar que un documento que antes se procesaba sin problemas deje de hacerlo (es lo que se conoce como «regresión», problema que ocurre cuando una modificación introduce un fallo en un comportamiento que anteriormente funcionaba. Por ello, no basta con volver a procesar el artículo que provocó el cambio, debemos reprocesar documentos que sí funcionaban, las correcciones deben verificarse con el mayor alcance posible. Esta forma de proceder se convirtió en una regla básica durante el afinado de DOCUMENTALIA: corregir el documento que falla no es suficiente: la modificación debe funcionar sin estropear los documentos que ya funcionaban.

Las excepciones son necesarias, pero también peligrosas

Cuando se presentaba un documento problemático (en Anales de Documentación hay un número donde el encabezado de la primera página de cada artículo es la referencia bibliográfica de ese artículo, por ejemplo), es tentador (y lógico) programar una excepción específica. De hacer lo mismo varias veces, terminaríamos elaborando un parser formado por una acumulación de casos particulares, difícil de mantener y poco preparado para documentos nuevos (y sus casuísticas). Por esta razón, hemos intentado distinguir entre excepciones documentales y regularidades editoriales. Cuando aparece un error no nos preguntamos únicamente cómo hacemos que «funcione ese artículo», la cuestión a resolver es ¿qué característica ha provocado el error y en qué otros documentos podría aparecer? Una buena regla del parser debe resolver una clase de problemas, no memorizar un documento dentro del código del script.

No todos los documentos científicos son artículos de investigación

El recorrido por todo el corpus reveló otra fuente de heterogeneidad: el tipo documental. Nuestras revistas publican mayoritariamente artículos de investigación, pero también recogen reseñas, traducciones u otros contenidos que no contienen los mismos elementos. En nuestras pruebas, por ejemplo, las reseñas de Anales de Documentación carecen de los elementos habituales de un artículo (resúmenes o palabras clave), lo que es normal y no constituye un error. El error sería obligar al parser a encontrar información que ese documento no contiene. Por tanto, la ausencia de un campo no siempre significa que la extracción haya fallado. Para interpretar el resultado también debemos conocer qué tipo de documento estamos procesando y se han introducido rutinas para identificarlo de forma automática.

El «afinado»: del artículo problemático a una regla más general

Este proceso de refinamiento puede resumirse del siguiente modo: documento → extracción → comparación → error → explicación → regla → nueva prueba → regresión

La fase fundamental es explicar el error. Si dos referencias aparecen unidas, no basta con separarlas, es necesario determinar por qué ocurrió. Las causas pueden ser variadas: ¿un salto de página?, ¿un cambio de columna?, ¿una referencia con una estructura diferente?, ¿una línea eliminada durante el preprocesamiento?, etc. Identificarla permite formular una regla más general y comprobarla sobre otros artículos.
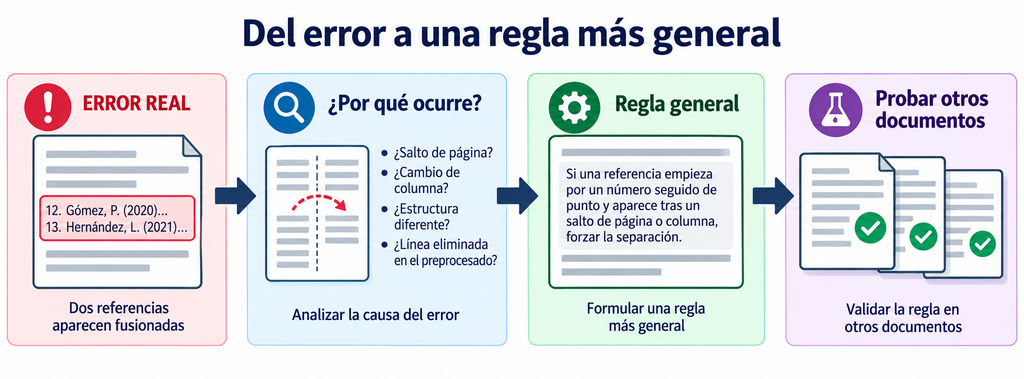
Refinamiento del parser: del error a una regla de alcance más general.

Un parser se construye con un corpus, no con un documento

Tras llevar a cabo numerosas iteraciones, reforzamos la idea de que un parser no se valida porque procese correctamente un artículo, sino porque podamos observar que mantiene un comportamiento consistente ante la diversidad del corpus. Si solo lo probamos con artículos recientes, habríamos obtenido un script aparentemente eficaz pero incapaz de interpretar una buena parte de la colección histórica. Las pruebas artículo por artículo han permitido descubrir cambios de plantilla, estructuras poco frecuentes, distintos tipos documentales y errores inesperados.

Pero este procedimiento tiene un límite. Revisar cuidadosamente cinco, diez o veinte artículos sirve para construir y corregir reglas. No demuestra que esas reglas funcionen sobre centenares de documentos.

De enseñar al parser a ponerlo a prueba

Cuando las principales reglas se estabilizan es necesario cambiar la escala de la prueba. En nuestro proyecto hemos pasado de revisar artículos de forma individual y/o pequeños conjuntos a ejecutar el parser sobre muestras aleatorias mucho mayores, algunas de hasta 200 artículos, buscando verificar si las reglas generalizan, localizan anomalías poco frecuentes y detectan regresiones. El resultado ha sido altamente positivo debido a la gran cantidad de cambios que habíamos ido introduciendo de forma previa con muestras más pequeñas. La diferencia entre ambas fases puede resumirse en dos preguntas:

  • Afinado: «¿Por qué falla este documento?»
  • Validación: «¿Con qué frecuencia falla el parser y qué errores siguen apareciendo?»

El cambio de escala nos lleva al siguiente paso: determinar cuándo el parser está suficientemente estabilizado para procesar el corpus completo y podemos incorporar los resultados a la base de datos de DOCUMENTALIA.
¿Qué necesitamos para construir un buscador IA sobre una colección documental?

Logo del proyecto DOCUMENTALIA

En la entrada anterior presentamos el proyecto DOCUMENTALIA y explicamos su propósito: formular preguntas en lenguaje natural sobre una colección de artículos científicos y obtener respuestas fundamentadas en los documentos recuperados. Ahora vamos a mirar dentro de este sistema.

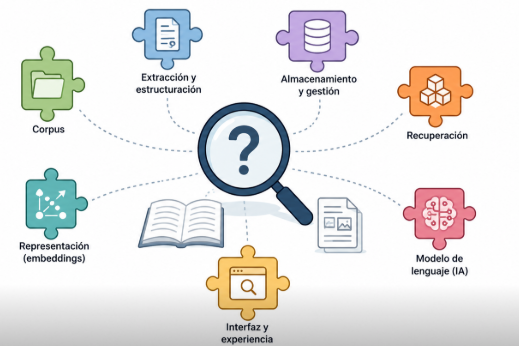
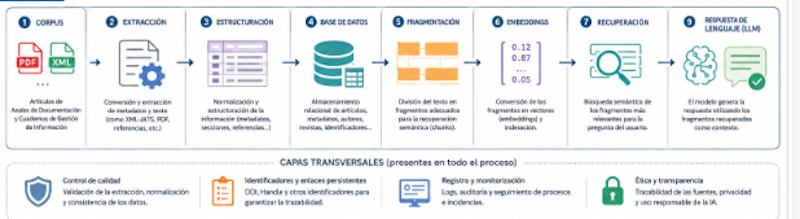
Un buscador de este tipo no se construye simplemente conectando una colección de artículos de revista almacenados en PDF o XML-JATS con un modelo IA. Entre los documentos originales y la respuesta final existe una cadena de procesos que permite extraer, organizar, representar y recuperar la información. Un buscador IA sobre una colección documental necesita de un corpus documental, mecanismos de extracción y estructuración de información, un sistema de almacenamiento, una estrategia de fragmentación, una representación semántica de los contenidos, un sistema de recuperación y un modelo de lenguaje que genere la respuesta a partir de las evidencias recuperadas. DOCUMENTALIA utiliza precisamente esta arquitectura.

Arquitectura general de Documentalia

De los documentos a la respuesta

La secuencia reflejada en la figura representa, de forma general, la arquitectura del sistema que vamos a construir: Corpus → extracción → estructuración → base de datos → fragmentación → embeddings → recuperación → modelo de lenguaje → respuesta con fuentes. Esta arquitectura proporciona el mapa de lo que iremos construyendo. Algunas partes ya están desarrolladas cuando escribimos esta entrada en este cuaderno de bitácora, otras corresponden a fases aun inexploradas. Veamos qué función cumple cada componente de DOCUMENTALIA.

1. Corpus: definir sobre qué documentos queremos preguntar

Todo comienza con una colección documental o corpus que, en nuestro proyecto, la constituyen inicialmente los artículos de Anales de Documentación y Cuadernos de Gestión de Información. No son documentos creados expresamente para realizar el experimento, sino publicaciones reales ya editadas (algunas van camino de los 30 años) bajo distintas condiciones editoriales (los rimeros números de Anales de Documentación solo tenían edición impresa pero pronto pasamos a disponer de la digital y, desde hace ya bastante tiempo, sólo de la digital). Esto introduce un primer problema: el corpus no es homogéneo. Se dispone, mayoritariamente de documentos en formato PDF y también en XML-JATS (correspondientes a los últimos número de Anales de Documentación), revista pionera en nuestra universidad en esta cuestión junto con Anales de Psicología). Los primeros conservan principalmente la presentación visual del artículo y los segundo contienen información estructurada mediante etiquetas; los segundos y serán los que se irán añadiendo a DOCUMENTALIA a partir de ahora.

c
Vista de un artículo en formato XML-Jats en la revista Anales de Documentación

Por tanto, antes de pensar en aplicar la inteligencia artificial, es preciso saber qué documentos tenemos y qué podemos extraer de ellos.

2. Extracción: convertir documentos en datos

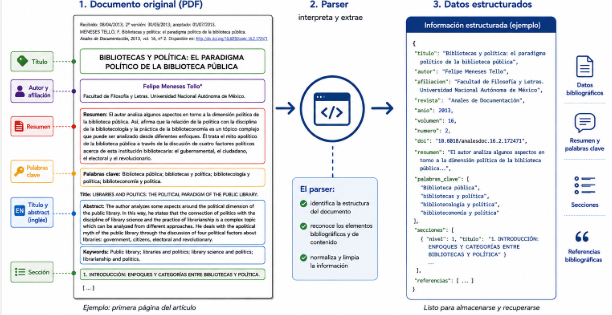
El siguiente componente es el parser. En recuperación de información es el programa encargado de interpretar los documentos y extraer la información que necesitamos. En un artículo científico queremos reconocer elementos como: título, autores, afiliaciones, fecha, revista, volumen, número, identificadores, resúmenes, palabras clave, secciones y referencias bibliográficas.

El problema a abordar es diferente según el formato. En los artículos que están ya redactados en XML-JATS, por ejemplo, una etiqueta puede indicar explícitamente que determinado texto corresponde al título o a un autor. En los documentos escritos en PDF (la gran mayoría), esa estructura debe ser reconstruida a partir del contenido y de determinadas regularidades documentales.

Cuestiones a resolver

Hay que tener presente que extraer el texto de un documento no implica haber extraído su estructura ni haber identificado correctamente la información que contiene. Esta cuestión ha ocupado la mayor parte del tiempo dedicado al proyecto en las primeras fases y será objeto de las próximas entradas.

3. Estructuración: representar documentos diferentes de una forma común

Los documentos originales pueden representar una misma información de maneras distintas. Un artículo puede disponer de DOI, otro, de handle; otro puede aportar los dos identificadores permanentes (eso sería lo deseable aunque, de momento, el repositorio de la Universidad de Murcia no devuelve el handle en la consulta por algún tipo de protección de seguridad), puede presentar tres resúmenes hasta en diferentes idiomas (es frecuente en los artículos escritos por autores brasileños); una reseña tiene una estructura completamente diferente de un artículo de investigación. Necesitamos transformar esa diversidad en una representación común.

Así entendido, la estructuración y normalización documental consiste en organizar la información extraída conforme a un modelo estable, independientemente de cómo estuviera originalmente representada. Gracias a ello, DOCUMENTALIA puede tratar de forma coherente artículos procedentes de diferentes formatos y épocas.

4. Base de datos: conservar la estructura del corpus

La información normalizada se almacena en una base de datos relacional creada al principio del proyecto con MySQL. En ella no guardamos únicamente una sucesión de textos, representamos entidades y relaciones: revistas, artículos, autores, afiliaciones, resúmenes, palabras clave, secciones, referencias e identificadores. Esto permite saber, por ejemplo, qué autores pertenecen a un artículo, qué resúmenes tiene, qué secciones hemos reconocido o qué DOI y handle permiten identificarlo. La base de datos y la futura búsqueda semántica cumplen, por tanto, funciones diferentes: la base de datos conserva la estructura conocida de la colección y la búsqueda semántica permite localizar información por su significado. Ambas formas de representación serán necesarias.

5. Fragmentación: dividir para recuperar mejor

Un artículo científico completo es una unidad demasiado grande para responder con precisión a una pregunta concreta (un artículo puede tratar varios temas y/o cuestiones). Si la información relevante está contenida en dos párrafos de un documento de veinte páginas, necesitamos ser capaces de recuperar esos párrafos y no necesariamente el artículo completo. Para ello dividiremos el contenido en fragmentos o chunks. El proceso de fragmentar persigue crear unidades de texto adecuadas para la recuperación: suficientemente pequeñas para ser precisas y suficientemente amplias para conservar el contexto. En una colección científica surge además una posibilidad interesante: aprovechar la propia estructura del artículo —introducción, metodología, resultados, discusión, conclusiones— para realizar una fragmentación más informada que un simple corte cada determinado número de palabras. Esta será una de las decisiones que tendremos que evaluar experimentalmente.

6. Embeddings: representar semánticamente los fragmentos

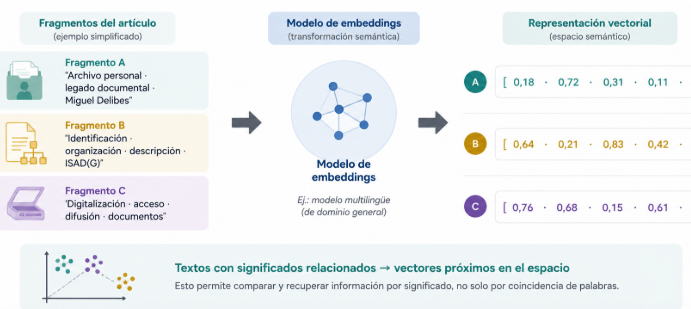
Una vez creados los fragmentos necesitamos una forma de comparar su significado con el de las preguntas formuladas por los usuarios, Aquí aparecen los embeddings (representación numérica de un contenido textual que permite comparar computacionalmente su proximidad semántica con otros textos).

Esquema del proceso de embeddings: fragmentos de un artículo científico se transforman en vectores numéricos que permiten comparar y recuperar textos por su significado semántico.
¿Qué es un embeding?

De manera simplificada, a un fragmento de texto se le aplica un modelo de embeddings para producir un vector. A la pregunta del usuario se le ha de aplicar el mismo procedimiento (tal como hace el modelo tf-idf en la RI clásica). De esta forma, tendremos dos vectores (representaciones) que se van a comparar para localizar fragmentos relacionados con una pregunta aunque no utilicen exactamente las mismas palabras. Es importante precisar qué los embeddings no responden a la pregunta, sino que ayudan a localizar qué partes del corpus pueden contener la respuesta.

7. Recuperación: encontrar las evidencias

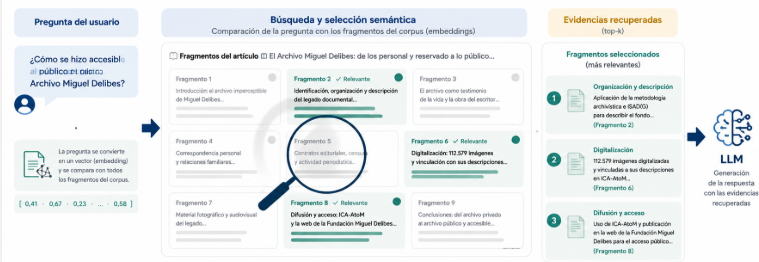
El siguiente componente selecciona, entre todos los fragmentos disponibles, aquellos más relevantes para la consulta. La proximidad entre embeddings puede constituir uno de sus mecanismos, pero no tiene por qué ser el único, se puede combinar búsqueda semántica con términos, metadatos, fechas, revistas u otros criterios de la búsqueda clásica.

Esquema del proceso de recuperación semántica: una pregunta se compara con los fragmentos del corpus, se seleccionan las evidencias más relevantes y se envían al modelo de lenguaje para generar la respuesta.
Esquema del proceso de recuperación semántica

La calidad de esta fase es crítica. Un modelo de lenguaje difícilmente podrá construir una respuesta correctamente fundamentada si previamente le proporcionamos fragmentos irrelevantes. Por ello, DOCUMENTALIA tendrá que evaluar dos cuestiones diferentes: (1) ¿hemos recuperado las evidencias adecuadas? y (2) el modelo ha respondido correctamente utilizando esas evidencias?

Separar ambas preguntas permitirá localizar mejor dónde se produce un posible error. No debemos olvidar que la recuperación no genera la respuesta: selecciona los fragmentos del corpus que pueden contener la información necesaria.

8. Modelo de lenguaje: generar la respuesta

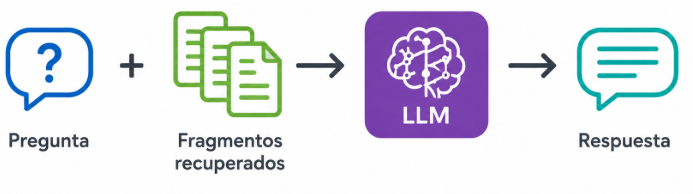
Solo después de recuperar información necesaria interviene el modelo de lenguaje o LLM. El mismo recibe la pregunta junto con los fragmentos seleccionados y genera una respuesta utilizando ese contexto documental. Se puede resumir en:

Modelo LLM: pregunta + fragmentos recuperados → LLM → respuesta

La función del modelo no es sustituir al sistema de recuperación, sino interpretar y sintetizar las evidencias que este ha localizado. En DOCUMENTALIA añadimos una condición esencial: la respuesta debe mantener la relación con los artículos de los que procede la información.

9. Respuesta con fuentes: cerrar el círculo documental

El resultado que buscamos no es simplemente un texto generado, aspiramos a obtener una respuesta trazable, acompañada de las fuentes utilizadas para construirla y, siempre que sea posible, con acceso al artículo correspondiente. Esto permite al usuario pasar de la respuesta generada al documento original y comprobar la evidencia. En una aplicación sobre artículos científicos como es nuestro proyecto, esta trazabilidad es especialmente importante porque la respuesta no debe convertirse en el punto final de la búsqueda, sino en una nueva vía de acceso a los documentos (artículos científicos) que contienen el conocimiento recuperado.

Hay componentes que atraviesan toda la arquitectura

El esquema de DOCUMENTALIA incorpora además varias capas transversales.

  • El control de calidad debe comprobar que la extracción y normalización son correctas.
  • Los identificadores persistentes mantienen la identidad y trazabilidad de los documentos.
  • El registro y la monitorización permiten conocer qué ocurre durante los procesos automáticos y localizar incidencias.

Finalmente, la ética y la transparencia afectan al sistema completo: procedencia de la información, trazabilidad de las fuentes, tratamiento de los documentos y uso responsable de los modelos de inteligencia artificial. No son etapas que ocurran al final, son requisitos que acompañan a todo el proceso.

No todo es inteligencia artificial

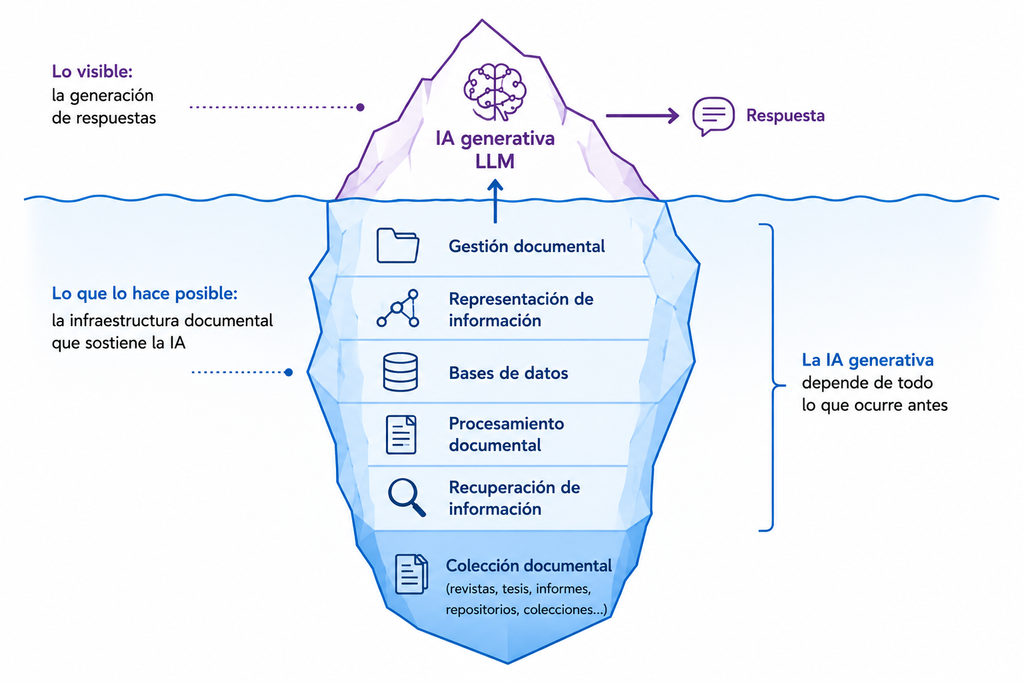
En la anterior entrada ya hacíamos mención a esta cuestión, reincidimos en ella. La arquitectura general del proyecto permite extraer una primera conclusión: no se trata únicamente de un problema de inteligencia artificial, es también un problema de gestión documental, representación de información, bases de datos y recuperación de información.

No todo es IA en DOCUMENTALIA

Antes de que un modelo de lenguaje pueda generar una respuesta habrá que seleccionar los documentos, interpretarlos, estructurar su información, almacenarla, dividir su contenido, representarlo y recuperar las evidencias adecuadas. La IA generativa ocupa una posición importante en la arquitectura, pero depende de todo lo que ocurre antes. Esta perspectiva es especialmente relevante en DOCUMENTALIA porque queremos comprobar hasta qué punto esta arquitectura puede reutilizarse con otras colecciones: repositorios institucionales, revistas, tesis doctorales, informes técnicos, colecciones patrimoniales o bibliotecas digitales.

¿Por dónde empezamos?

Se puede decir que ya disponemos del mapa general, toca ahora comenzar a recorrerlo de izquierda a derecha. El primer obstáculo apareció muy pronto: los artículos de las revistas no tienen todos la misma estructura ni están disponibles en el mismo formato de fichero. El gran problema han sido las maquetaciones, aspecto que podría parecer insignificante ante la potencia de la tecnología LLM, se ha convertido en un problema, tanto por los cambios de plantilla como por los muchos fallos a la hora de editar los artículos (es difícil encontrar tres o cuatro seguidos «bien maquetados»). Muchas formas de escribir en la Ciencia han cambiado con los años, también ha cambiado la norma para las referencias bibliográficas y existen artículos de investigación, reseñas, editoriales y otros tipos de documentos.

Por tanto, antes de construir embeddings o conectar un modelo de lenguaje, ha habido que resolver una cuestión mucho más básica: ¿cómo convertir una colección de documentos heterogéneos en un corpus estructurado que una máquina pueda interpretar de forma consistente?

Con suerte, lo podremos explicar en la siguiente entrada.

DOCUMENTALIA: buscador IA para revistas científicas

logotipo de DOCUMENTALIA

Los buscadores de las plataformas que alojan a las revistas científicas permiten localizar artículos localizando títulos, autores, palabras clave o términos presentes en los documentos. Pero, ¿qué ocurre si queremos hacer una pregunta sobre el contenido de una colección («documentos sobre comportamiento informacional«, por ejemplo) y obtener una respuesta elaborada a partir de los artículos publicados en esas revistas? Necesitaríamos un buscador IA con más capacidades.

DOCUMENTALIA es un proyecto experimental para desarrollar un buscador basado en inteligencia artificial sobre el texto completo de revistas científicas (Anales de Documentación y Cuadernos de Gestión de Información en este caso, dos de las revistas editadas por nuestra facultad y en las que participamos en el comité editorial. El objetivo de este proyecto es que el usuario pueda formular preguntas en lenguaje natural y recibir respuestas construidas a partir de los documentos de la colección, manteniendo siempre la posibilidad de identificar y consultar las fuentes utilizadas (tanto los artículos publicados en estas dos revistas como las referencias en las que se han basado los autores).

Cabecera de Anales de Documentación y de Cuadernos de Gestión de Información en el portal de revistas de la Universidad de Mucia
Cabeceras de las dos revistas indexadas en el proyecto DOCUMENTALIA

A lo largo de esta serie de entradas iremos explicando paso a paso cómo estamos construyendo el sistema, los problemas encontrados y las soluciones adoptadas.

¿Por qué construir un buscador con IA para una revista científica?

Un buscador convencional suele responder bien a una pregunta del tipo: «¿Qué artículos contienen el término «preservación digital»?«. Sin embargo, resulta algo más complicado utilizarlo para responder a preguntas como: «¿Qué problemas relacionados con la preservación digital han estudiado los artículos publicados en la revista?» (aunque el «modo IA» de Google puede matizar esta afirmación). La diferencia es importante: de forma habitual se buscan documentos que contienen determinadas palabras, con la ayuda de la IA intentaremos recuperar información relevante, relacionarla y generar una respuesta fundamentada en los documentos recuperados.

Aquí es donde entran en juego los sistemas de recuperación aumentada mediante generación ‘Retrieval-Augmented Generationde los que hablamos en un post anterior. Esta tecnología combina dos procesos:

  1. Recuperación de información: localizar de forma selectiva dentro de una colección los documentos o fragmentos más relacionados con la pregunta.
  2. Generación de la respuesta: un modelo de lenguaje utiliza la información recuperada como contexto para elaborar la respuesta.

En DOCUMENTALIA vamos a añadir una tercera exigencia: la trazabilidad, entendida bajo el paradigma de que una respuesta sobre literatura científica solo resulta verdaderamente útil si podemos saber qué documentos sustentan la información proporcionada.

¿Qué queremos conseguir?

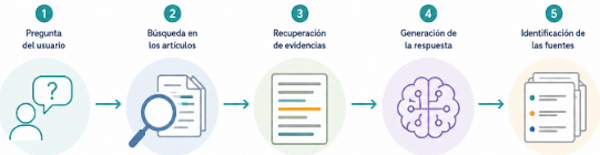
El objetivo se representa en un esquema muy simple: Pregunta del usuario → búsqueda en los artículos → recuperación de evidencias → generación de la respuesta → identificación de las fuentes

Esquema básico del funcionamiento de DOCUMENTALIA
Esquema básico del funcionamiento de Documentalia

Nuestro proyecto de buscador no pretende entrenar un nuevo modelo IA con los artículos de estas revistas. El planteamiento es diferente porque se aspira a construir una infraestructura que permita a un modelo consultar una colección documental previamente procesada y recuperar de ella la información necesaria para responder a una pregunta. Esta distinción va a ser muy importante durante todo el proyecto.

Sorpresa: el verdadero problema empieza antes de la IA

Cabe pensar que la parte más complicada consiste en conectar los documentos con un modelo de lenguaje, pero no es así. Antes de llegar a ese punto necesitamos responder a preguntas mucho más elementales:

  • ¿Qué documentos forman el corpus?
  • ¿En qué formatos se encuentran editadas?
  • ¿Siguen todas las mismas plantillas a lo largo de los años de edición de las revistas (Anales de Documentación tiene casi 30 años de antigüedad). ¿Los editores y/o los autores han respetado las plantillas y las normas editoriales?
  • ¿Cómo extraemos de los artículos títulos, autores, resúmenes, palabras clave, secciones y referencias?
  • ¿Cómo identificamos inequívocamente cada artículo?
  • ¿Cómo almacenamos toda esa información?
  • ¿Cómo comprobamos que la extracción ha sido correcta?
  • ¿Qué parte del contenido debemos proporcionar posteriormente al sistema de recuperación?

El paso del tiempo no es cuestión baladí. Una revista científica evoluciona. Los artículos más recientes de Anales de Documentación se editan en PDF y XML-JATS, y presentan una estructura muy regular, mientras que buena parte del corpus solo está disponible en PDF y el diseño editorial, la estructura de los artículos y las normas bibliográficas han cambiado durante los años (se pasó de ISO 690 a APA hace unos años). La otra revista, que aporta menos artículos porque sólo se editó durante unos años, tiene normas de formato diferentes sustancialmente, otra dificultad añadida. Por ello, antes de construir el buscador hay que convertir un conjunto documental heterogéneo en un corpus estructurado, normalizado y susceptible de ser procesado automáticamente.

La elección de un corpus real nos lleva a enfrentarnos a problemas que difícilmente aparecen en una demostración construida con unos pocos documentos:

  • documentos PDF y XML-JATS
  • artículos publicados en diferentes épocas
  • textos en español, portugués e inglés
  • artículos de investigación, reseñas y otros tipos documentales
  • diferentes estructuras y diseños de página
  • cambios en los sistemas de identificación de los documentos (hoy en día nadie discute el uso del DOI, identificador que no existía hasta hace unos años)
  • distintas formas de presentar autores, afiliaciones, resúmenes, palabras clave y referencias bibliográficas.

Esta heterogeneidad convierte nuestras dos revistas en un buen laboratorio para estudiar cómo construir sistemas de recuperación con IA sobre colecciones científicas reales.

Un proyecto que explicaremos paso a paso

Esta entrada inicia una serie en la que documentaremos el desarrollo de DOCUMENTALIA desde la preparación de los documentos hasta la construcción y evaluación del buscador. El proceso puede resumirse inicialmente en varias etapas: Corpus → extracción → estructuración → base de datos → fragmentación → embeddings → recuperación → modelo de lenguaje → respuesta con fuentes

Arquitectura general de DOCUMENTALIA
Arquitectura general de Documentalia

En las próximas entradas comentaremos (o lo intentaremos al menos) qué ocurre en cada una de estas etapas, prestando especial atención a los problemas encontrados, porque algunas de las decisiones más interesantes del proyecto han ido surgiendo precisamente cuando los documentos reales no se comportaban como esperábamos (lo que ha ocurrido más frecuentemente de lo deseado).

¿Puede aplicarse este procedimiento a otras colecciones?

Comònentes a desarrollar en documentalia
Documentalia: componentes a desarrollar

Ese es uno de los objetivos de esta serie de entradas: transferir el conocimiento adquirido. Buena parte de los problemas que estamos abordando en nuestro proyecto con dos revistas aparecen también al trabajar con repositorios institucionales, colecciones digitalizadas, revistas históricas, tesis doctorales, informes técnicos o bibliotecas digitales. Por eso no queremos presentar únicamente el resultado final, vamos a documentar el proceso de construcción y explicar qué decisiones pueden reutilizarse en otros proyectos.

En la siguiente entrada partiremos de una pregunta básica: ¿qué componentes necesitamos realmente para construir un buscador IA sobre una colección documental?

Gracias a ChatGPT

Logo de chatgpt

El desarrollo de DOCUMENTALIA cuenta con ChatGPT como asistente en las distintas fases del proyecto, no como sustituto de las decisiones de diseño, programación y validación. La interacción con el modelo se ha utilizado para analizar la estructura de documentos reales, diseñar y depurar los parsers de XML-JATS y PDF, interpretar errores, proponer modificaciones del código, definir el modelo de datos, establecer procedimientos de validación y documentar las sucesivas decisiones adoptadas. El proceso es deliberadamente iterativo: (1) se seleccionan documentos del corpus; (2) se ejecutan los programas desarrollados; (3) se contrastan sus resultados con los documentos originales y (4) los errores detectados sirven para plantear nuevas correcciones y pruebas. Esta forma de trabajo convierte la IA generativa en una herramienta de apoyo a la programación, análisis y resolución de problemas bajo supervisión humana, mientras que el corpus, los criterios de validación y las decisiones finales permanecen bajo control del responsable del proyecto.

Tom Wilson e Information Research: pioneros del acceso abierto diamante

En la revista científica ‘Information Research: an electronic international journal‘ hemos dedicado un número especial a los 30 años de la puesta en marcha de la misma por parte de nuestro querido maestro Tom Wilson de la Universidad de Sheffield (y de la de Borâs en los últimos años). Para nosotros ha sido un honor haber participado en este número y casi en los treinta años de vida de esta revista gracias a la generosidad de su fundador.

Fragmento del sitio web de la revista (versión histórica
Fragmento del sitio web de la revista (versión histórica en https://informationr.net/ir/).
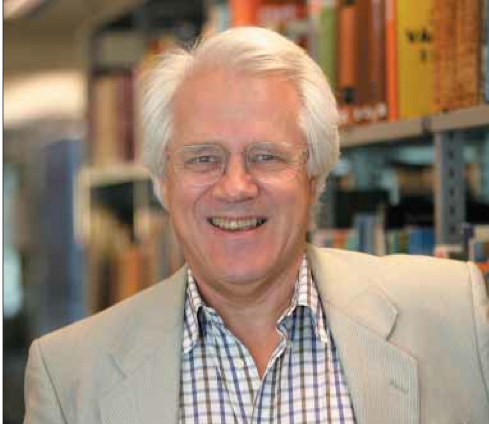
Fotografía de Tom Wilson (2010). Fuente: wikipedia

En nuestra aportación, que reproducimos en versión HTML a continuación, destacamos los vínculos que se han establecido entre nuestra Universidad, la revista y Tom, además de resaltar que esta revista es acceso abierto antes incluso de que se acuñara ese término y se difudiera tras el acuerdo de la Iniciativa por el Acceso Abierto firmada en Budapest en el año 2002. Sin duda alguna, Tom es un maestro, un genio y mejor persona.


Texto del artículo:

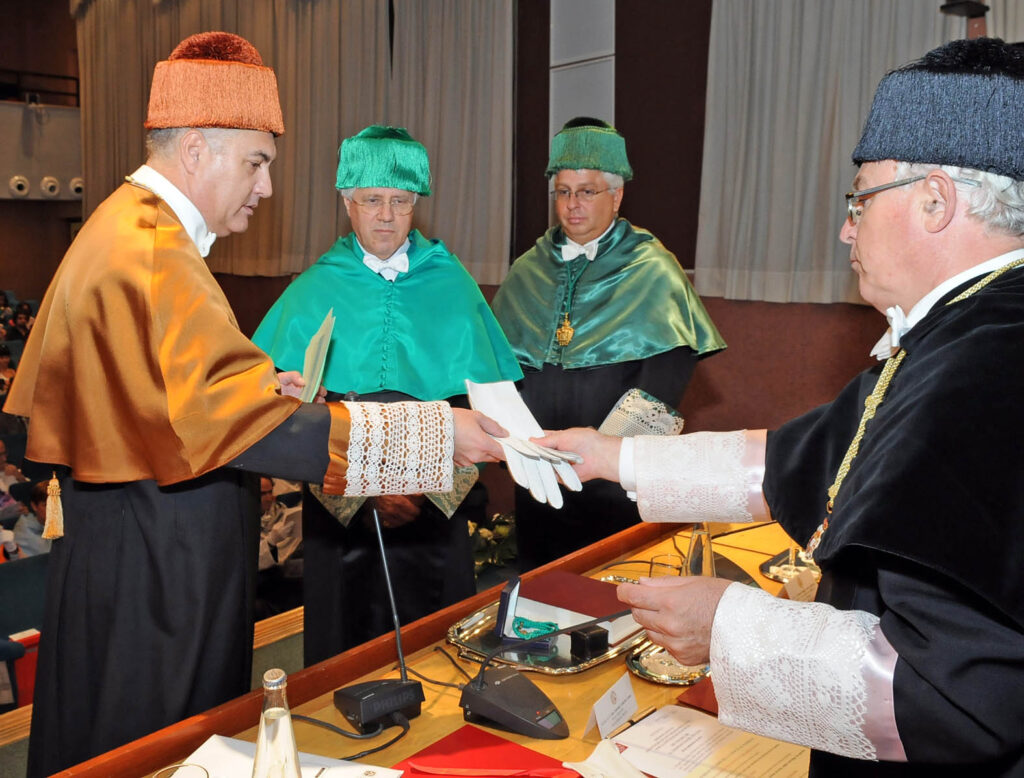
Son muchos los méritos contraídos por Tom Wilson a lo largo de toda su carrera docente e investigadora, en la que ha venido introduciéndonos en el estudio de la gestión de información y del comportamiento informacional en contexto prácticamente desde el inicio de estas disciplinas. En ambos casos, se produce el mismo fenómeno: con el paso del tiempo, ambas forman un binomio de muy difícil separación, por no decir indivisible, tal como dijo José Vicente Rodríguez Muñoz la mañana en la que le investimos Doctor Honoris Causa por nuestra Universidad (septiembre de 201). Es posible que, con anterioridad a Tom Wilson, otros autores pudieran haber realizado aproximaciones parciales alrededor de estos conceptos, pero quien, con su esfuerzo, dedicación y sabiduría, muchas veces acompañado de un grandísimo equipo de colaboradores, ha permitido su desarrollo e implantación dentro de la comunidad científica como temas de interés.

Acto de investidura de Tom Wilson como Doctor Honoris Causa por la Universidad de Murcia en el año 2010.
Acto de investidura de Tom Wilson como Doctor Honoris Causa por la Universidad de Murcia (2010).

De gran parte de todo ese trabajo ha sido testigo y depositaria la revista ‘Information Research: an electronic international journal‘, cuyo trigésimo aniversario celebramos con este número especial. Tal como informa la sección ‘About the Journal’ de su sitio web, fue fundada en 1995 por Tom Wilson en la Universidad de Sheffield y la ha dirigido casi todo este tiempo. En la presentación de la revista se comenta que ‘the Internet and the World ide Web were in their infancy, and the idea was to create a journal that covered the information disciplines in general’, recordando los significativos cambios acaecidos en nuestro campo durante todo este período, de proporciones exponenciales (casi hipergeométricas) en comparación con otros períodos anteriores donde la evolución seguía ritmos mucho más pausados.

Portada de un número de la revista Information Research en su diseño actual.
Portada de un número de la revista Information Research en su diseño actual (https://publicera.kb.se/ir).

La vocación internacional de la revista se observa claramente en el título de esta y constituye uno de sus puntos fuertes. No cabe duda alguna que esto es fiel reflejo de otro aspecto destacado de la personalidad de Tom Wilson: su afán por visitar la mayor parte de países del mundo posible para entrar en contacto con colegas y estudiantes. Gracias a esa actitud abierta y colaborativa tuvimos ocasión de conocerle personalmente y, desde entonces, ha sido para nosotros ese faro que guía a los barcos en la noche hacia puerto seguro donde descansar y avituallarse. Su primera visita a Murcia fue por motivo de un seminario sobre ‘Information Management’ justo el mismo curso que iniciábamos los estudios de Biblioteconomía y Documentación (1989-1999). Desde entonces, el contacto ha sido permanente y el vínculo se fue fortaleciendo hasta el punto de que es la única persona a quien se le ha concedido el Doctorado Honoris Causa a propuesta de nuestra facultad. Hicimos coincidir la ceremonia de investidura con esta distinción académica con la celebración de la conferencia ISIC-2010 para que una parte importante de sus amigos pudiera percibir en primera persona el alto nivel de reconocimiento y devoción que sentimos en esta humilde universidad del sureste de España por nuestro amigo, casi familia, Tom Wilson.

Durante este período de tiempo, el profesor Wilson participó como ponente invitado en el seminario de puesta en marcha de la Cátedra UNESCO en Gestión de Información en las Organizaciones, proyecto que coordinamos en colaboración con la Universidad de La Habana y que tuvo lugar en la Facultad de Economía de la Universidad Nacional Autónoma de México en el año 1995, unos meses antes de la puesta en marcha de la Maestría Internacional en Gestión de Información de la que llevamos realizadas más de 25 ediciones en distintos países de Latinoamérica y que ha permitido a muchos docentes e investigadores acceder al doctorado y progresar en su carrera académica.

En relación con ese progreso de la carrera académica y volviendo a la revista, no recordamos con precisión exacta la fecha, seguro que prácticamente en sus comienzos, el profesor Wilson abrió la posibilidad de publicar artículos en los idiomas portugués y español para colaborar en la difusión de los estudios e investigaciones realizadas en el ámbito iberoamericano, encargando en ese momento la responsabilidad de editar esa sección al profesor José Vicente Rodríguez Muñoz, nuestro maestro y compañero. Este hecho resultó fundamental para la comunicación de nuestras investigaciones en un ámbito internacional al que nos introdujo Tom Wilson, no sólo a los miembros de nuestra universidad, sino a muchos colegas de España, Portugal e Iberoamérica que aprovecharon ese espacio que gentilmente nos abrió el profesor Wilson. En el caso particular de nuestro departamento, Information Research ha sido depositaria de la buena parte de los artículos derivados de las tesis doctorales que hemos realizado a lo largo de estos 30 años, algunos de ellos con una considerable atención e interés por parte de la comunidad investigadora.

Fragmento del artículo 'Advantages of thesaurus representation using the Simple Knowledge Organization System (SKOS) compared with proposed alternatives' publicado en Information Research.
Fragmento del artículo ‘Advantages of thesaurus representation using the Simple Knowledge Organization System (SKOS) compared with proposed alternatives’ publicado en Information Research. Fuente: https://informationr.net/ir/14-4/paper422.html

Hoy en día esa sección sigue recibiendo de forma periódica abundantes peticiones de publicación de artículos, si bien la tendencia actual es presentarlos en inglés (la lingua franca de la Ciencia). Podemos asegurar, sin temor a equivocarnos, que tanto la revista como su director, tienen una pequeña parte de culpa en esa internacionalización de la comunicación de la ciencia en nuestro entorno.

Information Research ha sido siempre una revista digital con el mismo nivel de gestión editorial que otras revistas de más longevas en el tiempo y con mayor presupuesto (algo imaginario en nuestro caso particular). Todo ha sido posible por la disposición de una multitud de compañeros y colegas que nunca han dudado a responder afirmativamente a la “llamada” de Tom Wilson para colaborar con la revista. En todos estos años hemos aprendido muchas cosas y queremos resaltar algunas de ellas. La primera fue la inmensa sorpresa que percibimos ante el nivel de dedicación y atención que investigadores y autores de referencia mundial prestaban a las tareas de revisión y edición de los artículos dentro de un contexto colaborativo impregnado de armonía, equidad y respeto por las decisiones adoptadas por todos los compañeros participantes. Esto nos ha servido a muchos de nosotros para replicarlo en otros proyectos editoriales en los que participamos, aprendiendo todos de todos. Otro aspecto que destacar es la formalidad del proceso editorial, al que muchos autores no estábamos acostumbrados en nuestros entornos locales en aquella época. El uso de una plantilla XHTML para la maquetación rigurosa de los artículos ha permitido además una mayor interoperabilidad y difusión de los textos dentro del ecosistema de la Web Semántica, también embrionario e incipiente cuando se implantó su uso. Continuando con los aspectos formales, la revisión de estilo, que se mantiene en la actualidad, es otra de las fortalezas de nuestra revista, a pesar de que se ha ido trivializando en otras revistas con el paso del tiempo.

Quizá los lectores más antiguos de esta revista recuerden que, al poco de haber sido indexada por la base de datos Social Science Citation Index (hoy parte de la WOS), hubo que introducir algunos cambios en la denominación de los artículos y guardar una copia de este y de las referencias empleadas en un sistema de archivo digital (webcitation.org) para intentar obviar la futilidad propia del ecosistema de la web de aquella época. Tom Wilson condujo inteligentemente este proceso y llevó a cabo la asignación de identificaciones permanentes de artículos para favorecer una preservación de los documentos cuando prácticamente esos conceptos eran embrionarios. Hace un par de años realizamos un sondeo para verificar la existencia de “citas perdidas” de los artículos de nuestra revista en la Web of Science (WOS), un problema presente en muchas publicaciones de acceso abierto y que añade otra tarea más sus comités editoriales. Cuál fue nuestra sorpresa, en realidad no tanto, cuando verificamos que Information Research tenía debidamente computadas todas. La rigurosidad editorial por bandera forma parte de nuestro genoma vital.

En los relativo a la indexación en bases de datos y la posición de la revista en los índices de impacto (estos últimos no han preocupado en exceso a Tom Wilson), la revista siempre ha estado recopilada por los principales productores y distribuidores, además de tener factor de impacto tanto en JCR/JCI como en el índice SJR donde nuestra publicación recibe más citas debido al mayor alcance geográfico del mismo, volviendo a poner de manifiesto que la internacionalización de la revista es una de nuestras fortalezas.

Lo que no ha cambiado nunca es el acceso abierto a los contenidos publicados en nuestra revista sin aplicar coste alguno a los autores de los artículos (las tan controvertidas como perniciosas APCs). Nuestra revista es, desde sus inicios, una revista de acceso abierto “diamante”. Y he aquí la paradoja, Information Research es acceso abierto cuando aún no se había redactado la Declaración de Budapest (2002); incluso Information Research es “diamante” cuando aún no se había tenido que establecer esta categoría de publicaciones para distinguir el verdadero acceso abierto del que pretenden instaurar las editoriales comerciales intenta hacer frente al acoso de las editoriales comerciales, financiadas con dinero público por culpa de una deficiente aplicación del Plan “S” que ha dado pábulo a la proliferación de revistas predadoras y/o de escaso nivel científico que dañan mucho a la comunicación de la ciencia. IR es un claro ejemplo de lo contrario, de cómo el sueño de Tom Wilson se ha consolidado en una publicación de referencia internacional, abierta a todo tipo de autores, consolidados y noveles, y a todas las disciplinas relacionadas con la investigación en información. Por todo ello, creemos de justicia afirmar que, tanto la revista como su impulsor y director hasta el año pasado, son “pioneros del acceso abierto” junto a todos quienes hemos dedicado una parte de nuestro tiempo a la misma.

Autores

Jose-Vicente Rodriguez-Munoz, Francisco-Javier Martinez-Mendez, Pedro-Manuel Diaz-Ortuno, Gregorio Moya-Martinez y Rosana Lopez-Carreno, miembros del Grupo de Investigación en Tecnologías de la Información de la Universidad de Murcia y colaboradores habituales con la revista en los últimos 30 años.

References

Budapest Open Access Initiative. (2002). https://doi.org/10.4403/jlis.it-8629

Fuchs, C., & Sandoval, M. (2013). The diamond model of open access publishing: Why policy makers, scholars, universities, libraries, labour unions and the publishing world need to take non-commercial, non-profit open access serious. TripleC: Communication, capitalism & critique, 11(2), 428-443.  https://doi.org/10.31269/vol11iss2pp428-443  

Rodríguez Muñoz, J.V. et al. (2010) Discursos pronunciados en el acto de investidura del profesor Thomas Daniel Wilson como Doctor Honoris Causa por la Universidad de Murcia. http://hdl.handle.net/10201/40450

cOAlition S. (2019). Accelerating the transition to full and immediate Open Access to scientific publications. Science Europe. https://archive.org/details/plan-s-rationale-310519

Qué es un ‘retracted paper’

Hace unos pocos años, durante el primer aniversario de mi mandato como vicerrector de Comunicación de la UMU, una revista científica «detractó» una veintena cantidad de artículos a un exprofesor de mi universidad, ahora (afortunadamente) «catedrático» en una «universidad» privada cercana. Recuerdo una mañana respondiendo preguntas de algunos medios de comunicación locales, a media mañana nacionales, que demostraron un interés por la noticia inusitado y, al mismo tiempo, fiel reflejo de lo que la universidad representa para la sociedad, el sitio donde se forma a las personas encargadas de las profesiones, las artes, las ciencias, donde se investiga y se conserva la cultura, y se forman los nuevos maestros y maestras (esto no es mío, es de Ortega y Gasset en su discurso «Misión de la Universidad«).

artículo científico detractado

Cuando un artículo científico (o un conjunto de artículos) se retracta, significa que se ha puesto en duda su integridad (su calidad científica) y que se han retirado formalmente de la publicación. La retractación es un mecanismo utilizado para corregir el registro científico cuando hay problemas graves con la investigación, como errores, mala conducta o datos fraudulentos.

Se trata pues, de una medida seria que sólo debe tomarse tras una deliberación exhaustiva por parte del editor, los redactores y, a veces, el autor o los autores. Los motivos de la retractación suelen exponerse en un aviso que se publica en la propia revista afectada y en las bases de datos en las que ese artículo o artículos hayan sido indexados. La mala praxis de los autores suele ser la causa de estas detractaciones la mayor parte de las veces.

Los artículos retirados se eliminan del sitio web de la revista. También se pueden dejar y añadirles (como en la imagen anterior) una marca de agua u otra indicación de que han sido retirados. Esto ayuda a evitar que otros investigadores presten atención en el futuro en una investigación defectuosa o fraudulenta, lo que podría tener consecuencias negativas para el progreso científico. Los editores de las revistas científicas no pueden poner en juego el prestigio de sus publicaciones, el principal medio de comunicación científica desde los tiempos del ‘Journal des Scavants‘ o la ‘Philosophical Transactions‘, por lo que se toman muy en serio los casos denunciados.

Journal de Scavants - portada

Los científicos solemos trabajar en instituciones públicas, que pagan nuestros salarios y sufragan los gastos de las infraestructuras, equipos y proyectos de investigación. Sabemos que el dinero público tiene nos límites y que no hay para todos. Un año se puede poner en marcha un laboratorio en biotecnología de último nivel, es posible que no haya dinero para explorar una cueva donde creemos que hace treinta mil años vivieron los neandertales. Por ello, quienes reciben esos fondos deben devolver a la sociedad, con su trabajo honrado y, si es posible, con creces, esa inversión llevada a cabo por los ciudadanos y ciudadanas.

La transparencia en la actividad investigadora es totalmente necesaria y, por eso, los resultados de la investigación deben estar accesibles en abierto para el resto de la comunidad científica. En realidad no solo los resultados, los conjuntos de datos deben estar depositados en repositorios de libre acceso también.

Por ello, casos como el denunciado en la Universidad de Córdoba hace unos días, donde un «investigador» ha sido sancionado con suspensión por 13 años de empleo y sueldo por mala praxis abusiva y repetitiva en sus investigaciones (ha llegado a publicar artículos cada 37 horas en el campo de la Química Verde), son verdaderos lunares que obligan a plantearnos diversas cuestiones:

La primera: el sistema de promoción de la carrera docente e investigadora valora mucho más la investigación que la docencia. Eso es algo congénito en España (en Portugal también me cuentan mis amigos de la Universidade do Minho). España no es una potencia del i+d+i mundial, pero somos casi imbatibles en artículos publicados en revistas científicas internacionales, últimamente con los gastos de publicación sufragados total o casi totalmente con fondos públicos. ¿No parece incongruente?

En segundo lugar, incluso pudiendo asumir lo anterior (como lo de «pulpo animal de compañía» del anuncio), ¿de verdad existe tanta revista científica de calidad para que esto se lleve a cabo? Está claro que revistas existen, pero que buena parte de ellas (muchas de reciente aparición y rapidísimo crecimiento en los índices de impacto) han rebajado sus niveles de exigencia y calidad editorial también es cierto. Y encima, asistimos «cuasi» impávidos a la reciente aparición de muchas publicaciones que parecen haberse creado específicamente para acoger estos articulos «masivos» y cobrar APCs (gracias al Plan-S), sin apenas llevar a cabo procesos de revisión medianamente serios.

Llegados a este escenario, enfrente de un enemigo superior en número y armamento (el dinero), ¿podemos hacer algo? Lo cierto es que acabar con este negocio apoyado por fondos capital-riesgo se aventura complicado, pero no debemos quedarnos impasibles. En esta «batalla», la transparencia de los procesos editoriales se antoja como decisiva, sin olvidar que esa transparencia es un aspecto fundamental de la Ciencia Abierta porque fomenta la responsabilidad, la reproducibilidad y la fiabilidad de la investigación. Al compartir los datos, métodos y resultados de la investigación, los científicos aumentamos la calidad y el impacto de nuestras investigaciones, facilitaremos la colaboración y la innovación, permitiendo también que se verifiquen nuestros resultados y conclusiones.

La transparencia es esencial para alcanzar estos objetivos, garantizando que la investigación se lleve a cabo de forma ética y rigurosa, y que los resultados sean fiables y reproducibles. La información transparente sobre los métodos y resultados de una investigación permite a otros investigadores reproducir el estudio y validar sus conclusiones. Del mismo modo, el acceso abierto a los conjuntos de datos de la investigación permite volver a analizar los datos y probar hipótesis alternativas, lo que puede conducir a nuevos conocimientos y descubrimientos. Ademas, está claro que la transparencia ayuda a prevenir prácticas científicas indebidas, como el plagio y la falsificación de datos, porque permite detectar y denunciar estos problemas. Otro motivo más para evolucionar hacia la CIencia Abierta.

También hay casos donde la apertura de resultados y conjuntos de datos permite a la comunidad científica corregir errores presentes en las investigaciones. Casi todos recordaremos el tremendo error del «Experimento Opera» que afirmaba que los neutrinos podían llegar a velocidades más allá de la de la luz («superlumínica» es la palabra). La publicación de la investigación en abierto, en el repositorio Arxiv creo recordar, permitió rebatir la misma y el CERN, que participaba en el experimento original detectó fallos en el instrumental con el que se había llevado a cabo el experimento. Los autores de la investigación no cometieron mala praxis, solo se equivocaron, y eso se corrigió.

En resumen, la transparencia es un aspecto fundamental de la Ciencia Abierta que fomenta la credibilidad, fiabilidad y utilidad de la investigación científica. Al adoptar prácticas transparentes, los científicos pueden aumentar la calidad y el impacto de sus investigaciones, promover la colaboración y la innovación y contribuir al avance del conocimiento.