RAG

DOCUMENTALIA: buscador IA para revistas científicas

logotipo de DOCUMENTALIA

Los buscadores de las plataformas que alojan a las revistas científicas permiten localizar artículos localizando títulos, autores, palabras clave o términos presentes en los documentos. Pero, ¿qué ocurre si queremos hacer una pregunta sobre el contenido de una colección («documentos sobre comportamiento informacional«, por ejemplo) y obtener una respuesta elaborada a partir de los artículos publicados en esas revistas? Necesitaríamos un buscador IA con más capacidades.

DOCUMENTALIA es un proyecto experimental para desarrollar un buscador basado en inteligencia artificial sobre el texto completo de revistas científicas (Anales de Documentación y Cuadernos de Gestión de Información en este caso, dos de las revistas editadas por nuestra facultad y en las que participamos en el comité editorial. El objetivo de este proyecto es que el usuario pueda formular preguntas en lenguaje natural y recibir respuestas construidas a partir de los documentos de la colección, manteniendo siempre la posibilidad de identificar y consultar las fuentes utilizadas (tanto los artículos publicados en estas dos revistas como las referencias en las que se han basado los autores).
Cabecera de Anales de Documentación y de Cuadernos de Gestión de Información en el portal de revistas de la Universidad de Mucia
Cabeceras de las dos revistas indexadas en el proyecto DOCUMENTALIA

A lo largo de esta serie de entradas iremos explicando paso a paso cómo estamos construyendo el sistema, los problemas encontrados y las soluciones adoptadas.

¿Por qué construir un buscador con IA para una revista científica?

Un buscador convencional suele responder bien a una pregunta del tipo: «¿Qué artículos contienen el término «preservación digital»?«. Sin embargo, resulta algo más complicado utilizarlo para responder a preguntas como: «¿Qué problemas relacionados con la preservación digital han estudiado los artículos publicados en la revista?» (aunque el «modo IA» de Google puede matizar esta afirmación). La diferencia es importante: de forma habitual se buscan documentos que contienen determinadas palabras, con la ayuda de la IA intentaremos recuperar información relevante, relacionarla y generar una respuesta fundamentada en los documentos recuperados.

Aquí es donde entran en juego los sistemas de recuperación aumentada mediante generación ‘Retrieval-Augmented Generation‘ de los que hablamos en un post anterior. Esta tecnología combina dos procesos:

  1. Recuperación de información: localizar de forma selectiva dentro de una colección los documentos o fragmentos más relacionados con la pregunta.
  2. Generación de la respuesta: un modelo de lenguaje utiliza la información recuperada como contexto para elaborar la respuesta.

En DOCUMENTALIA vamos a añadir una tercera exigencia: la trazabilidad, entendida bajo el paradigma de que una respuesta sobre literatura científica solo resulta verdaderamente útil si podemos saber qué documentos sustentan la información proporcionada.

¿Qué queremos conseguir?

El objetivo se representa en un esquema muy simple: Pregunta del usuario → búsqueda en los artículos → recuperación de evidencias → generación de la respuesta → identificación de las fuentes
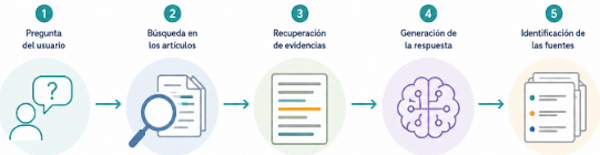
Esquema básico del funcionamiento de DOCUMENTALIA
Esquema básico del funcionamiento de Documentalia

Nuestro proyecto de buscador no pretende entrenar un nuevo modelo IA con los artículos de estas revistas. El planteamiento es diferente porque se aspira a construir una infraestructura que permita a un modelo consultar una colección documental previamente procesada y recuperar de ella la información necesaria para responder a una pregunta. Esta distinción va a ser muy importante durante todo el proyecto.

Sorpresa: el verdadero problema empieza antes de la IA

Cabe pensar que la parte más complicada consiste en conectar los documentos con un modelo de lenguaje, pero no es así. Antes de llegar a ese punto necesitamos responder a preguntas mucho más elementales:

  • ¿Qué documentos forman el corpus?
  • ¿En qué formatos se encuentran editadas?
  • ¿Siguen todas las mismas plantillas a lo largo de los años de edición de las revistas (Anales de Documentación tiene casi 30 años de antigüedad). ¿Los editores y/o los autores han respetado las plantillas y las normas editoriales?
  • ¿Cómo extraemos de los artículos títulos, autores, resúmenes, palabras clave, secciones y referencias?
  • ¿Cómo identificamos inequívocamente cada artículo?
  • ¿Cómo almacenamos toda esa información?
  • ¿Cómo comprobamos que la extracción ha sido correcta?
  • ¿Qué parte del contenido debemos proporcionar posteriormente al sistema de recuperación?

El paso del tiempo no es cuestión baladí. Una revista científica evoluciona. Los artículos más recientes de Anales de Documentación se editan en PDF y XML-JATS, y presentan una estructura muy regular, mientras que buena parte del corpus solo está disponible en PDF y el diseño editorial, la estructura de los artículos y las normas bibliográficas han cambiado durante los años (se pasó de ISO 690 a APA hace unos años). La otra revista, que aporta menos artículos porque sólo se editó durante unos años, tiene normas de formato diferentes sustancialmente, otra dificultad añadida. Por ello, antes de construir el buscador hay que convertir un conjunto documental heterogéneo en un corpus estructurado, normalizado y susceptible de ser procesado automáticamente.

La elección de un corpus real nos lleva a enfrentarnos a problemas que difícilmente aparecen en una demostración construida con unos pocos documentos:

  • documentos PDF y XML-JATS
  • artículos publicados en diferentes épocas
  • textos en español, portugués e inglés
  • artículos de investigación, reseñas y otros tipos documentales
  • diferentes estructuras y diseños de página
  • cambios en los sistemas de identificación de los documentos (hoy en día nadie discute el uso del DOI, identificador que no existía hasta hace unos años)
  • distintas formas de presentar autores, afiliaciones, resúmenes, palabras clave y referencias bibliográficas.

Esta heterogeneidad convierte nuestras dos revistas en un buen laboratorio para estudiar cómo construir sistemas de recuperación con IA sobre colecciones científicas reales.

Un proyecto que explicaremos paso a paso

Esta entrada inicia una serie en la que documentaremos el desarrollo de DOCUMENTALIA desde la preparación de los documentos hasta la construcción y evaluación del buscador. El proceso puede resumirse inicialmente en varias etapas: Corpus → extracción → estructuración → base de datos → fragmentación → embeddings → recuperación → modelo de lenguaje → respuesta con fuentes
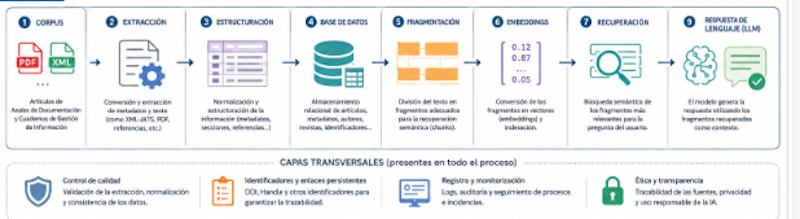
Arquitectura general de DOCUMENTALIA
Arquitectura general de Documentalia

En las próximas entradas comentaremos (o lo intentaremos al menos) qué ocurre en cada una de estas etapas, prestando especial atención a los problemas encontrados, porque algunas de las decisiones más interesantes del proyecto han ido surgiendo precisamente cuando los documentos reales no se comportaban como esperábamos (lo que ha ocurrido más frecuentemente de lo deseado).

¿Puede aplicarse este procedimiento a otras colecciones?
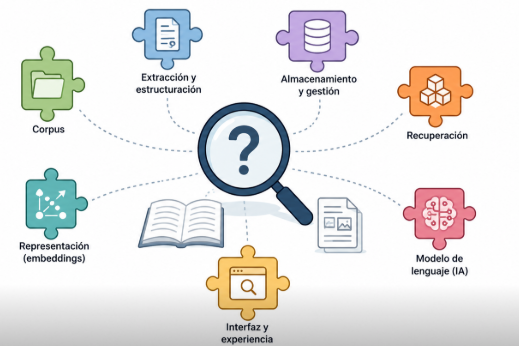
Comònentes a desarrollar en documentalia
Documentalia: componentes a desarrollar

Ese es uno de los objetivos de esta serie de entradas: transferir el conocimiento adquirido. Buena parte de los problemas que estamos abordando en nuestro proyecto con dos revistas aparecen también al trabajar con repositorios institucionales, colecciones digitalizadas, revistas históricas, tesis doctorales, informes técnicos o bibliotecas digitales. Por eso no queremos presentar únicamente el resultado final, vamos a documentar el proceso de construcción y explicar qué decisiones pueden reutilizarse en otros proyectos.

En la siguiente entrada partiremos de una pregunta básica: ¿qué componentes necesitamos realmente para construir un buscador IA sobre una colección documental?

Gracias a ChatGPT
Logo de chatgpt

El desarrollo de DOCUMENTALIA cuenta con ChatGPT como asistente en las distintas fases del proyecto, no como sustituto de las decisiones de diseño, programación y validación. La interacción con el modelo se ha utilizado para analizar la estructura de documentos reales, diseñar y depurar los parsers de XML-JATS y PDF, interpretar errores, proponer modificaciones del código, definir el modelo de datos, establecer procedimientos de validación y documentar las sucesivas decisiones adoptadas. El proceso es deliberadamente iterativo: (1) se seleccionan documentos del corpus; (2) se ejecutan los programas desarrollados; (3) se contrastan sus resultados con los documentos originales y (4) los errores detectados sirven para plantear nuevas correcciones y pruebas. Esta forma de trabajo convierte la IA generativa en una herramienta de apoyo a la programación, análisis y resolución de problemas bajo supervisión humana, mientras que el corpus, los criterios de validación y las decisiones finales permanecen bajo control del responsable del proyecto.
Retrieval Augmented Generative (RAG)

Esta mañana ha venido a visitarme mi director de departamento a preguntarme si se explicaba algo sobre RAG en la asignatura Recuperación de Información de tercero del grado. Le he dicho que no pero que tenía previsto hacerlo a partir del próximo mes de septiembre. Como prueba de ello publico este vídeo que le pedí a Google LLM que creara a partir de una serie de fuentes de información que nos permiten saber cómo está cambiando el ecosistema de las búsquedas de información tras la irrupción de chatGPT et al. hace poco más de tres años.

RAG: la convergencia entre los motores de búsqueda tradicionales y los Modelos de Lenguaje Extensos (LLM).

RAG son las siglas en inglés de «Generación Aumentada por Recuperación», técnica empleada por las lA para mejorar la precisión de los LLM (modelos de lenguaje extensos) al conectarles fuentes de datos externas y actualizadas antes de generar una respuesta. Su uso reduce alucinaciones y proporciona información contextualizada, siendo ideal para datos privados o de empresa. Esta integración permite superar limitaciones históricas, como la información desactualizada o las respuestas inexactas, al fundamentar la IA en datos específicos y verificables.

LLM y motores de búsqueda

La relación entre los motores de búsqueda y los modelos de lenguaje extensos se define como simbiótica porque ambas tecnologías aprovechan las fortalezas de la otra para superar sus limitaciones individuales, creando sistemas de información más inteligentes y eficientes. Mientras que los motores de búsqueda ofrecen frescura y cobertura masiva de datos, los LLM aportan capacidades de comprensión del lenguaje natural y síntesis de información

LLM y recuperación de información: cambio de paradigma

Esta integración no es solo una mejora incremental, sino un cambio de paradigma hacia servicios de búsqueda centrados en el usuario . Sistemas como el nuevo Bing o Google AI Overviews son ejemplos de esta simbiosis en acción, donde el motor de búsqueda recupera la información más relevante y actual, y el LLM la procesa para ofrecer una interacción fluida y personalizada

Escribir en la web «para» las gramáticas generativas LLM: el paradigma GEO

¿Por qué GEO?

Hace unos días escuché a unas de las personas que se presenta a las elecciones al rectorado de la Universidad de Murcia comentar en una entrevista en un podcast que quizá estábamos escribiendo páginas web bajo el paradigma equivocado porque son muchos los usuarios que emplean las gramáticas generativas IA tipo chatGPT, Gemini, Claude, Perplexity, etc. para recuperar información en lugar de los motores de búsqueda tradicionales y podemos preparar nuestras entradas de forma optimizada para esta nueva tecnología, avanzando desde el SEO hasta el GEO (siglas de ‘Generative Engine Optimization‘).

Desde entonces vengo preguntándome sobre esta cuestión y voy a decicar algunas entradas (redactadas en el formato «tradicional» de este blog, pero intentando tomar nota de algunas de las recomendaciones que he encontrado al respecto) a esta cuestión.

Claves del cambio de paradigma

Sabemos que los buscadores tradicional devuelven listas de enlaces a partir de palabras clave y la correspondencia entre esas palabras y el contenido de las páginas web. Una gramática generativa LLM devuelve respuestas construidas a partir de fragmentos de información. Esta diferencia es substancial y deja claro que estamos comparando tecnologías diferentes. Ahora, sin dejar de conferir importancia a la entrada en sí misma como unidad, para las gramáticas generativas resulta más trascendente que el contenido pueda ser reutilizado como una unidad de conocimiento.

1. Credibilidad: si no es verificable, no sirve.

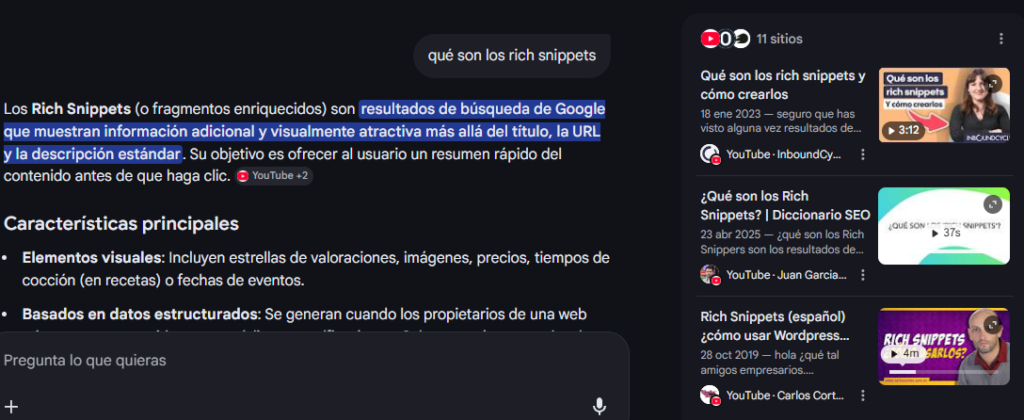
Los modelos generativos priorizan contenidos en los que se puede “confiar”, prefieren textos con fuentes identificables, contenidos con datos concretos y de autoría clara, como se comprueba en esta búsqueda en el modo IA de Google:

Ejemplo de búsqueda en el "modo IA" de Google.
Ejemplo de búsqueda en el «modo IA» de Google.

Además de elaborar un resumen para responder a la cuestión, muestra en la parte derecha de la pantalla las fuentes de información que le sirven de soporte. Entre los criterios que necesitamos los autores para ganarnos esa «confianza» destacan:

  • citar informes, artículos o datasets
  • incluir cifras, porcentajes o resultados medibles
  • indicar quién escribe y cuándo

Está claro que cuanto más verificable sea nuestro contenido, más probable es que sea reutilizado. Esto es algo habitual en el mundo científico al escribir un artículo, el mismo debe apoyarse en fuentes de autoridad contrastada que terminan confiriéndole a nuestro trabajo la calidad suficiente para ganar calidad en el seno de la comunidad científica. Esto no es frecuente en la web actual. Por cierto, he usado viñetas en lugar de escribir en un párrafo los criterios «de confianza» para las gramáticas LLM, lo he hecho porque esa forma de exponer el contenido también les parece interesante.

2. Estructura: escribir pensando en fragmentos, no en páginas.

Las gramáticas generativas no “leen artículos”, trabajan con fragmentos (‘chunks‘). Los autores podemos, fácilmente, ayudar a ello usando los encabezados (H1, H2, H3, …) de una forma clara y consistente (de hecho, cualquiera que siga este blog verá que hay más encabezados que de costumbre, antes no hacía tanto uso de ellos). Dividir el contenido en bloques pequeños y evitar referirnos a esos bloques (párrafos) con expresiones ambiguas del estilo de “esto último permite” o “lo anterior indica” servirá para aumentar el interés de esas gramáticas hacia nuestra entrada web, esto no contradice para nada lo que hemos venido haciendo hasta ahora. La novedad fundamental reside en estructurar en formato pregunta–respuesta estos fragmentos de información, por ejemplo:

Formato de redacción "pregunta-respuesta" en una entrada web.
Formato de redacción «pregunta-respuesta» en una entrada web.

Este tipo de bloques de contenido encaja perfectamente con cómo funcionan los sistemas RAG (Retrieval-Augmented Generation), técnica que mejora la precisión de los modelos LLM en la consulta de fuentes de datos externos.

3. Claridad: menos retórica, más información.

Para un lector humano, cierto grado de estilo es positivo, aunque siempre se ha comentado que la web no es el lugar para perífrasis y circunloquios. Para una gramática generativa LLM lo importante es encontrar contenidos con:

  • frases claras
  • conceptos explícitos
  • poca ambigüedad

Asím funciona mejor la frase «Un eclipse solar ocurre cuando la Luna bloquea la luz del Sol desde la Tierra” que el texto «Este fenómeno sucede cuando se alinean ciertos cuerpos celestes”. Redactar sencillo genera contenido de fácil comprensión y mayor reutilización. La clave es la densidad informativa (cuánta información útil y concreta hay en una frase o texto en relación con su longitud).

4. Metadatos para ayudar a las máquinas a entender el contenido.

Si bien no es obligatorio, añadir metadatos estructurados, lo cierto es que ayuda bastante. Aquí entramos en el territorio de Schema.org y de los datos estructurados que sirven para indicar (entre otras cosas):

  • tipo de contenido (artículo, dataset, etc.)
  • autor
  • fecha
  • tema

Este enriquecimiento de los sitios web con microdatos reduce la ambigüedad del texto y mejora la interoperabilidad con sistemas externos. En este caso, esto es positivo tanto para las gramáticas generativas como para la recuperación de información tradicional.

5. Pensar en RAG: cómo “leen” realmente estos sistemas.

Muchos sistemas actuales combinan modelos de lenguaje con recuperación de información RAG. Esto implica:

  1. el contenido se fragmenta
  2. el contenido se convierte en vectores (‘embeddings‘)
  3. del contenido se van a recuperar los fragmentos más relevantes
  4. el modelo genera la respuesta

Lo cierto es que los autores no podemos controlar este proceso, pero sí facilitarlo por medio de:

  • bloques de contenido de tamaño medio (ni demasiado largos ni demasiado cortos)
  • repetir ligeramente conceptos clave (sin forzar)
  • responder preguntas que el usuario realmente haría

Lo cierto es que las dos primeras recomendaciones también son válidas para la recuperación de información tradicional, es la tercera (que ya hemos adelantado) la que representa una novedad: escribir pensando en preguntas concretas.

6. Qué ya no funciona (o funciona peor)

Algunas prácticas del SEO clásico pierden sentido aquí:

  • keyword stuffing (uso excesivo de palabras clave) → irrelevante o incluso perjudicial
  • textos largos sin estructura → difíciles de reutilizar
  • contenido genérico sin datos → baja probabilidad de uso

Tanto el exceso de palabras clave como la desestructuración de los textos sabemos desde hace tiempo que estaba penalizado en la recuperación de información clásica. En el contexto GEO podemos considerar su abolición como una premisa. En GEO, más no es mejor: mejor es mejor.

Resumiendo …

Todo esto se puede resumir así en una frase corta: «No escribas páginas. Diseña unidades de conocimiento«. Para ello, debemos seguir, como mínimo, esta serie de pasos:

  1. Hacer el contenido verificable (fuentes, datos, autoría).Q
  2. Estructurar el texto en bloques claros (mejor si son preguntas y respuestas).
  3. Escribir de forma explícita y sin ambigüedades.
  4. Facilitar la fragmentación del contenido (‘chunking’).

La optimización del contenido para las gramáticas generativas no sustituye completamente al SEO, lo que hace es añadir una nueva capa.

Para finalizar, le he pedido a Google Notebook LLM que prepare un pequeño vídeo para mostrar la transición del SEo al nuevo paradigma GEO a `partir de algunas de las fuentes que hemos empleado para preparar esta entrada. Creo que ha quedado interesante.

Del SEO al GEO: algunas pistas básicas.

¿Recuperamos información o datos?

Nota de actualización de entracda antigua en el blog

Actualizo una entrada antigua de este blog que escribí en el año 2006 sobre la cierta confusión existente sobre si, en una búsqueda, recuperamos información o datos. Vamos a ver cómo queda.

En el campo de la recuperación de información (‘information retrieval‘), casi al principio de la disciplina, era normal encontrar autores que empleaban la expresión «recuperación de datos» cuando en realidad de lo que estaban hablando era de recuperar información. Teniendo en cuenta las fechas de lasque hablamos (años 80, cuando el tecnopop), Esto se debía, fundamentalmente, a una clara influencia de la terminología informática, disciplina cuya rapidísima evolución llevó a muchos autores a cometer el error de considerar sinónimos ambos conceptos, llegándose a olvidar, como afirmaba Brookes, que se puede recuperar información sin emplear procedimientos informáticos (hecho indiscutible aunque no sea lo más común hoy en día, evidentemente).

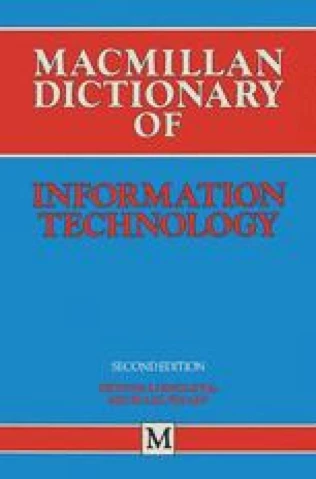
Portda del Diccionaro MacMillan de Tecnologías de la Informació

El frecuente y necesario empleo de una tecnología no sustituye la obligatoriedad de utilizar adecuadamente los conceptos terminológicos. Un ejemplo de este desacierto lo hallamos en el Glosario ALA que define “information retrieval” como “recuperación de la información» en su primera acepción y como “recuperación de datos” en una segunda, considerando sinónimos ambos términos en lengua inglesa. De parecida opinión es el Diccionario Mac Millan de Tecnología de la Información, que considera la recuperación de información como el conjunto de “técnicas empleadas para almacenar y buscar grandes cantidades de datos y ponerlos a disposición de los usuarios”.

Afortunadamente, es mayor el grupo de autores que establecen diferencias entre ambos conceptos. Entre ellos destaca Meadow, para quien la recuperación de la información es “una disciplina que involucra la localización de una determinada información dentro de un almacén de información o base de datos”. Este autor establece de forma implícita una ligazón entre recuperación de información y el concepto de «selectividad» a la hora de presentar esa información al usuario siguiendo algún tipo de criterio discriminatorio (selectivo por tanto) entre una gran colección de documentos. Meadow marca un poco más estas diferencias, al afirmar que no es lo mismo la recuperación de información entendida como traducción del término inglés information recovery que cuando se traduce el término information retrieval, porque “en el primer caso no es necesario proceso de selección alguno”. Pérez-Carballo y Strzalkowski refuerzan esta idea afirmando que “una típica tarea de la recuperación de información es traer documentos relevantes desde una gran archivo en respuesta a una pregunta formulada por un usuario y ordenar estos documentos de acuerdo con su relevancia”.

Grossman y Frieder indican que la recuperación de información es “hallar documentos relevantes, no encontrar simples correspondencias a unos patrones de bits”. De similar criterio es el W3C que define recuperar información como “dado un conjunto de documentos y una pregunta, encontrar el conjunto de documentos más relevantes con la pregunta”.

En clase, explico a mis estudiantes que, en la recuperacíón de datos, las preguntas son altamente formalizadas y la respuesta  es directamente toda la información deseada. Así, “recuperar los títulos de los libros escritos por Jorge Luis Borges en la década de los 50” sería la ecuación “SELECT titulo WHERE autor=’Jorge Luis Borges’ AND fecha>1949  AND fecha<1960”. Otra pregunta fácil es saber cuántos ciudadanos de Murcia tienen alguna multa de tráfico sin abonar al Ayuntamiento de la ciudad y cuánto totaliza esa deuda para las arcas municipales. Nos movemos en un paradigma determinista, el territorio del modelo relacional de bases de datos. También les explico que en la recuperación de información, las preguntas son más difíciles de trasladar a un lenguaje formal y la respuesta es un conjunto de documentos que probablemente contendrá la información deseada, siempre con un factor de cierta indeterminación. En este modelo, el territorio de los SRI, La consulta sería, por ejemplo, «Obras Borges década 50”.

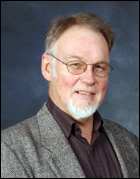
Foto de C.J: Rijsbergen, de la Universidad de Glasgow

El gran profesor ‘Keith’ Rijsbergen establece en la siguiente tabla las diferencias entre recuperar datos e información:

Diferencias entre recuperación de datos y recuperación de información según Keith Risjbergen

Finalizo siempre esta cuestión presentando la siguiente cita de Ricardo Baeza-Yates:

“dada una necesidad de información (consulta + perfil del usuario + … ) y un conjunto de documentos, ordenar los documentos de más a menos relevantes para esa necesidad y presentar un subconjunto de aquellos de mayor relevancia”

¿Sigue este tema vigente?

Creo que esta distinción conceptual sigue siendo especialmente pertinente hoy en día. Si se observa la evolución reciente de los sistemas de búsqueda y acceso a la información. Las tecnologías actuales —como la búsqueda semántica, el uso de representaciones vectoriales (embeddings) o los modelos de lenguaje de gran tamaño (LLMs)— no han eliminado el problema clásico de la recuperación de información, sino que han añadido nuevas capas de complejidad. Estos sistemas ya no se limitan a la coincidencia literal entre términos (‘matching‘), sino que operan sobre representaciones semánticas del contenido, aproximándose con mayor eficacia a la noción de relevancia, aunque sin resolverla plenamente.

Datos, información y recuperación en sistemas de búsqueda actuales
Datos, información y recuperación en sistemas de búsqueda actuales.
Imagen elaborada por chatGPT.

Muchos de los SRI contemporáneos combinan, de forma híbrida, procedimientos propios de la recuperación de datos y de la recuperación de información. La indexación estructurada, las búsquedas exactas o las consultas sobre bases de datos conviven con mecanismos de ranking, inferencia semántica y estimación de relevancia. Esta convergencia tecnológica no invalida la distinción conceptual entre ambos enfoques; al contrario, la hace más necesaria, ya que permite comprender mejor los límites, fortalezas y riesgos interpretativos de cada tipo de sistema. En este contexto, los sistemas basados en modelos de lenguaje de gran tamaño y arquitecturas de retrieval-augmented generation (RAG) reintroducen, bajo nuevas formas, el debate clásico entre datos e información. Aunque estos modelos pueden generar respuestas coherentes y contextualmente plausibles, su funcionamiento depende en gran medida de procesos previos de recuperación y selección de documentos relevantes. La calidad informativa del resultado no reside únicamente en la capacidad generativa del modelo, sino en la adecuación del proceso de recuperación que lo alimenta, confirmando la vigencia de los principios fundamentales de la recuperación de información.

Fuentes bibliográficas. 

[1] Brookes afirma esto en la presentación del primer capítulo de la obra Information Retrieval Research titulado ‘Information Technology and Information Science’, donde recuerda que el problema de la recuperación de información no ha de aplicarse sólo a lo automático, sino también a lo manual. (Oddy et al, 1981). Salton también lo recalca al comentar que no siempre se recupera información textual (Salton & McGill, 1983).

[2] Meadow, C.T. (1992) Text Information Retrieval. 

[3] Pérez-Carballo, J. and Strzalkowski, T. ‘Natural language information retrieval: progress report’. Information Processing and Management 36, 2000. p. 155-178

[4] (Grossman and Frieder, 1998) Grossman, D.A. and Frieder, O. Information retrieval: algorithms and heuristics. Boston: Kluwer Academia Publishers, 1998.