Construir un parser capaz de extraer información de un artículo científico es, hoy en día, algo sencillo (relativamente) cuando todos los documentos siguen una misma estructura, pero, tal como se comentaba en la entrada anterior, esto cambia cuando se deben procesar casi 30 años de publicaciones, espacio de tiempo en el que ha cambiado el diseño de las revistas, la presentación de los autores, resúmenes, palabras clave y referencias bibliográficas e incluso los formatos de publicación (sin olvidarnos de identificadores como DOI u ORCID que no existían a principios de siglo).
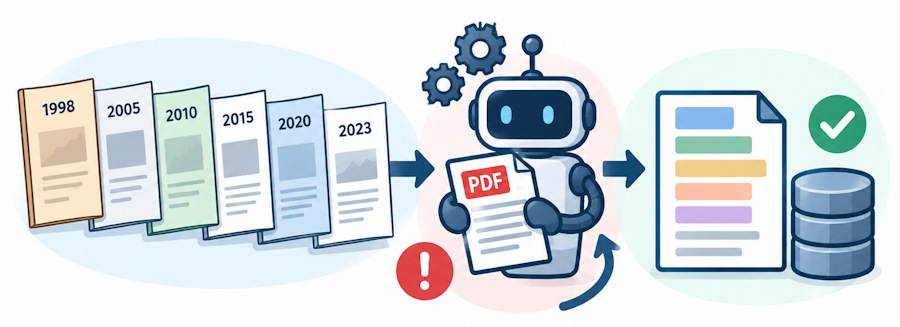
Esta ha sido una de las principales dificultades encontradas durante el desarrollo de DOCUMENTALIA. No buscamos que el parser funcione con unos cuantos artículos recientes, sino que sea capaz de reconocer de forma consistente la estructura de documentos publicados en épocas y condiciones editoriales diferentes. Para conseguirlo, ha habido que enseñar al parser de forma progresiva: seleccionar una muestra de artículos de distintos años, ejecutar el script, comparar los datos obtenidos con los originales, localizar errores, modificar las reglas y volver a probar. La experiencia muestra que un corpus histórico no contiene únicamente documentos antiguos y modernos; contiene distintas formas de representar la información que se han sucedido a lo largo del tiempo.
Un mismo artículo, muchas formas de representarlo
Cuando una persona lee un artículo. reconoce el título, los autores o la bibliografía, es un proceso que suele resultar sencillo. Después utilizamos el contenido, la posición, la tipografía y nuestro conocimiento de cómo se organiza el mismo. Un parser de PDF debe convertir esos indicios en reglas: dónde aparece una línea, qué hay antes y después, cómo comienza una referencia o qué patrones permiten reconocer un correo electrónico, una fecha o un DOI (son las directrices gramaticales formales que determinan cómo se estructuran, agrupan y validan los tokens de una cadena de entrada).
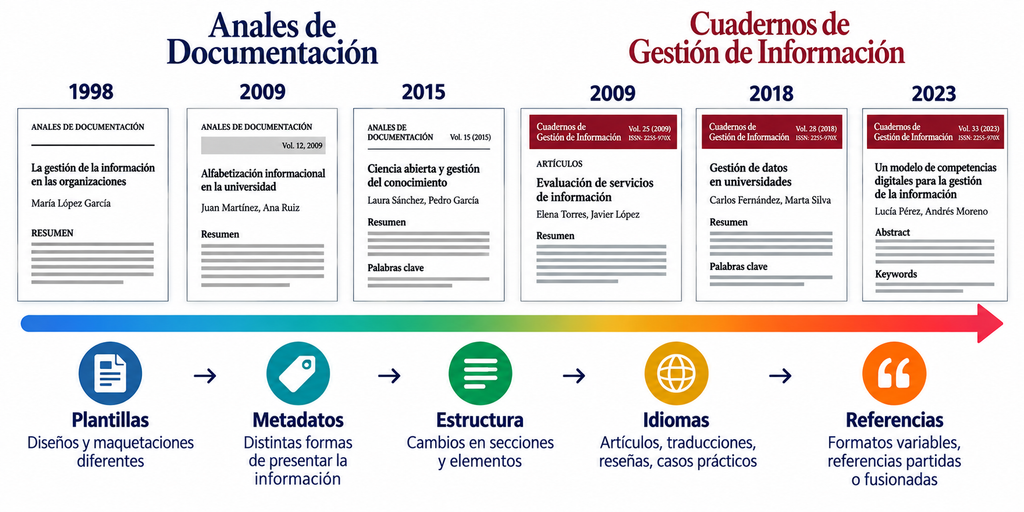
Una regla que funciona con los artículos de un determinado año puede fallar cuando cambia la plantilla de la revista. En DOCUMENTALIA, además, el corpus incluye artículos de Anales de Documentación y Cuadernos de Gestión de Información publicados en épocas diferentes y con muchos cambios en las plantillas (especialmente en la primera revista que es la más longeva).
El parser no tiene que aprender una plantilla: debe reconocer las regularidades que permanecen detrás de plantillas diferentes. Las primeras pruebas mostraron que los fallos no siempre son evidentes y que pasan prácticamente desapercibidos a nuestros ojos. El script puede terminar correctamente y generar un fichero JSON donde guardar la información que ha identificado, aparentemente completo, pero con malas interpretaciones de algunos elementos. Por ejempo, hemos encontrado afiliaciones de autores interpretadas como autores («Universidad de Córdoba» por «Juana López. Universidad de Córdoba»), líneas incorporadas indebidamente al título, palabras clave mal separadas (esto ha sido más frecuente de lo esperado), resúmenes en distintos idiomas mezclados, párrafos considerados encabezados de sección o referencias bibliográficas partidas o fusionadas (algo demasiado frecuente que luego dificulta el cómputo de las citas a esos artículos por parte de los índices). Todos estos errores muestran el mismo problema: extraer el texto de un PDF no equivale siempre a comprender su estructura documental.
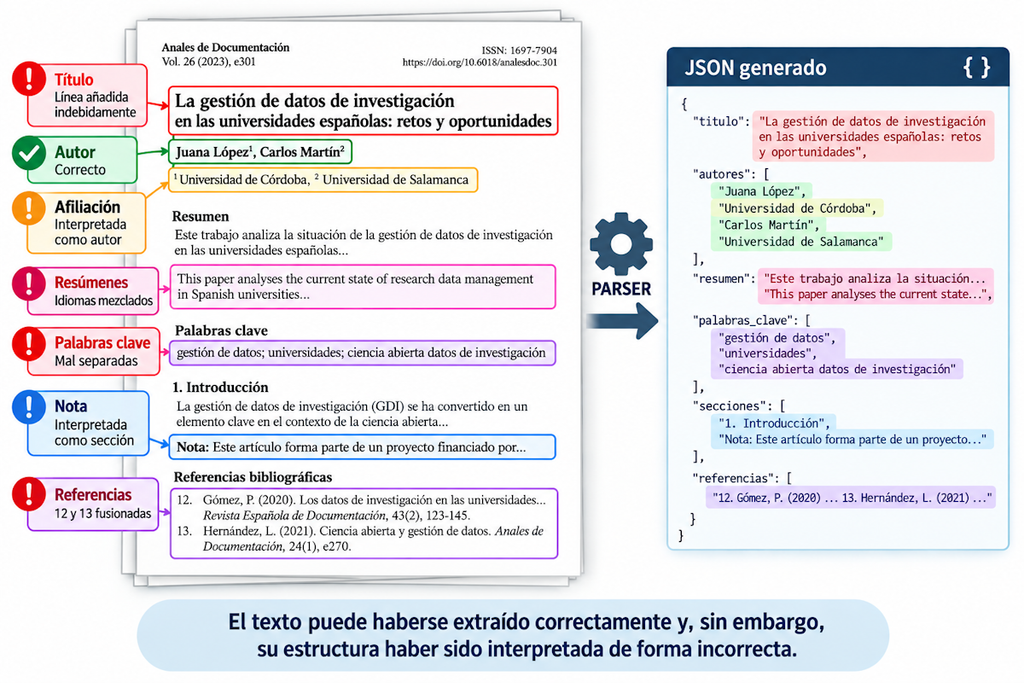
En el ejemplo de la imagen observamos que Autor está bien reconocido; la Afiliación se confunde con un autor; el Título tiene una línea añadida; la Nota se considera una sección y las Referencias 12 + 13 se han fusionado (error).
El parser debe viajar hacia atrás en el tiempo
Una parte especialmente interesante ha consistido en probar el parser con números cada vez más antiguos. Los documentos publicados en 1998, por ejemplo, plantearon unos problemas apenas presentes en artículos recientes: títulos y metadatos, autorías corporativas, palabras clave, segmentación de secciones o bibliografía. También se fueron incorporando a la revista tipos documentales, como reseñas y traducciones, cuya estructura no coincide con la de un artículo de investigación convencional o un artículo que recoge una experiencia aplicada (caso práctico). Con documentos más recientes han aparecido otros problemas: en artículos de 2022 tuvimos que tratar títulos traducidos truncados, notas numeradas interpretadas como secciones y referencias bibliográficas fusionadas.
Otro caso ilustrativo de la serie de fallos aparecidos fue en un artículo de Cuadernos de Gestión de Información de 2023. El número de referencias extraídas parecía correcto —53—, pero dos estaban truncadas. Una regla utilizada para eliminar números de página alteraba la reconstrucción del texto al cambiar de página y columna. Su corrección permitió recuperar las referencias completas sin alterar su número. Este ejemplo resume bien el problema: los indicadores cuantitativos pueden ser correctos y esconder errores cualitativos en la extracción de información.
Corregir un error puede crear otro
Hay que ser consciente de que. al modificar una regla para resolver un problema, se puede provocar que un documento que antes se procesaba sin problemas deje de hacerlo (es lo que se conoce como «regresión», problema que ocurre cuando una modificación introduce un fallo en un comportamiento que anteriormente funcionaba. Por ello, no basta con volver a procesar el artículo que provocó el cambio, debemos reprocesar documentos que sí funcionaban, las correcciones deben verificarse con el mayor alcance posible. Esta forma de proceder se convirtió en una regla básica durante el afinado de DOCUMENTALIA: corregir el documento que falla no es suficiente: la modificación debe funcionar sin estropear los documentos que ya funcionaban.
Las excepciones son necesarias, pero también peligrosas
Cuando se presentaba un documento problemático (en Anales de Documentación hay un número donde el encabezado de la primera página de cada artículo es la referencia bibliográfica de ese artículo, por ejemplo), es tentador (y lógico) programar una excepción específica. De hacer lo mismo varias veces, terminaríamos elaborando un parser formado por una acumulación de casos particulares, difícil de mantener y poco preparado para documentos nuevos (y sus casuísticas). Por esta razón, hemos intentado distinguir entre excepciones documentales y regularidades editoriales. Cuando aparece un error no nos preguntamos únicamente cómo hacemos que «funcione ese artículo», la cuestión a resolver es ¿qué característica ha provocado el error y en qué otros documentos podría aparecer? Una buena regla del parser debe resolver una clase de problemas, no memorizar un documento dentro del código del script.
No todos los documentos científicos son artículos de investigación
El recorrido por todo el corpus reveló otra fuente de heterogeneidad: el tipo documental. Nuestras revistas publican mayoritariamente artículos de investigación, pero también recogen reseñas, traducciones u otros contenidos que no contienen los mismos elementos. En nuestras pruebas, por ejemplo, las reseñas de Anales de Documentación carecen de los elementos habituales de un artículo (resúmenes o palabras clave), lo que es normal y no constituye un error. El error sería obligar al parser a encontrar información que ese documento no contiene. Por tanto, la ausencia de un campo no siempre significa que la extracción haya fallado. Para interpretar el resultado también debemos conocer qué tipo de documento estamos procesando y se han introducido rutinas para identificarlo de forma automática.
El «afinado»: del artículo problemático a una regla más general
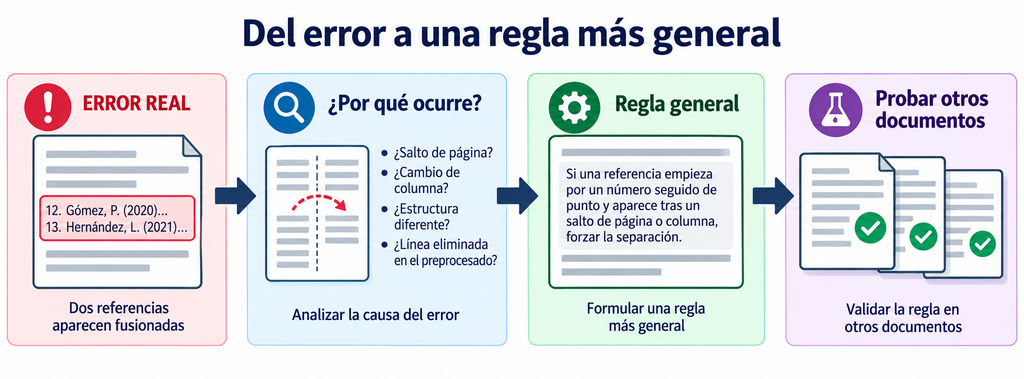
Este proceso de refinamiento puede resumirse del siguiente modo: documento → extracción → comparación → error → explicación → regla → nueva prueba → regresión
La fase fundamental es explicar el error. Si dos referencias aparecen unidas, no basta con separarlas, es necesario determinar por qué ocurrió. Las causas pueden ser variadas: ¿un salto de página?, ¿un cambio de columna?, ¿una referencia con una estructura diferente?, ¿una línea eliminada durante el preprocesamiento?, etc. Identificarla permite formular una regla más general y comprobarla sobre otros artículos.
Un parser se construye con un corpus, no con un documento
Tras llevar a cabo numerosas iteraciones, reforzamos la idea de que un parser no se valida porque procese correctamente un artículo, sino porque podamos observar que mantiene un comportamiento consistente ante la diversidad del corpus. Si solo lo probamos con artículos recientes, habríamos obtenido un script aparentemente eficaz pero incapaz de interpretar una buena parte de la colección histórica. Las pruebas artículo por artículo han permitido descubrir cambios de plantilla, estructuras poco frecuentes, distintos tipos documentales y errores inesperados.
Pero este procedimiento tiene un límite. Revisar cuidadosamente cinco, diez o veinte artículos sirve para construir y corregir reglas. No demuestra que esas reglas funcionen sobre centenares de documentos.
De enseñar al parser a ponerlo a prueba
Cuando las principales reglas se estabilizan es necesario cambiar la escala de la prueba. En nuestro proyecto hemos pasado de revisar artículos de forma individual y/o pequeños conjuntos a ejecutar el parser sobre muestras aleatorias mucho mayores, algunas de hasta 200 artículos, buscando verificar si las reglas generalizan, localizan anomalías poco frecuentes y detectan regresiones. El resultado ha sido altamente positivo debido a la gran cantidad de cambios que habíamos ido introduciendo de forma previa con muestras más pequeñas. La diferencia entre ambas fases puede resumirse en dos preguntas:
- Afinado: «¿Por qué falla este documento?»
- Validación: «¿Con qué frecuencia falla el parser y qué errores siguen apareciendo?»
El cambio de escala nos lleva al siguiente paso: determinar cuándo el parser está suficientemente estabilizado para procesar el corpus completo y podemos incorporar los resultados a la base de datos de DOCUMENTALIA.