recuperación de información

El carácter selectivo de la recuperación de información

recuperación de datos e informaciones (nube)

Uno de los libros fundamentales sobre recuperación de información es la obra ‘Language and representation in information retrieval’ de D.C. Blair de 1990. Y una de sus principales aportaciones es, sin duda alguna, el llegar a establecer una clara diferenciación entre el término ‘data retrieval’ y el término ‘information retrieval’, utilizando como criterios distintivos: 

  1. En recuperación de datos se usan preguntas altamente formalizadas, cuya respuesta es directamente la información deseada. En cambio, en recuperación de información las preguntas resultan difíciles de trasladar a un lenguaje normalizado (aunque existen lenguajes para ello son de naturaleza mucho menos formal que los empleados en los sistemas relacionales) y la respuesta es un conjunto de documentos que pueden contener, sólo probablemente, lo deseado, con un evidente factor de indeterminación.
     
  2. De lo anterior y según la relación entre el requerimiento al sistema y la satisfacción de usuario, la recuperación de datos es determinista y la recuperación de información es posibilista, por causa del nivel de incertidumbre presente en la respuesta.
     
  3. En cuanto al éxito de la búsqueda, en recuperación de datos el criterio a emplear es la exactitud de lo encontrado, mientras que en recuperación de información, el criterio de valor es el grado en el que la respuesta obtenida satisface las necesidades de información del usuario, es decir, su percepción personal de utilidad, más conocido como la relevancia de la respuesta..

Jesús Tramullas destaca un aspecto de las reflexiones de Blair, “la importancia, en ocasiones ignorada, que tiene el factor de predicción. Predicción por parte del usuario, ya que éste debe intuir, en numerosas ocasiones, los términos que han sido utilizados para representar el contenido de los documentos, independientemente de la presencia de mecanismos de control terminológico. Este criterio de predicción es otro de los elementos que desempeñan un papel fundamental en el complejo proceso de la recuperación de información” y que no se presenta en el campo de la recuperación de datos.

Metadatos y usabilidad

Seguimos intentando convencernos de las ventajas del uso de los metadatos. El otro día, buscando en Google por «metadatos» y «usabilidad» me encontré un trabajo con la siguiente frase al comienzo:

frase de Ricardo Baeza Yates

Supongo que algunos ya saben que el autor de esta frase es el profesor e investigador Ricardo Baeza-Yates en el artículo titulado «Ubicuidad y Usabilidad en la Web» escrito en 2002. El mismo introduce la idea de que un sitio web “bueno” no se define únicamente por su estética, sino por una secuencia de condiciones necesarias para que el usuario llegue a usarlo y, sobre todo, vuelva a visitarlo. El autor parte de un princicio claro: la web crece a un ritmo tan acelerado (y con tanta renovación de páginas) que es imposible pensar que todos los sitios van a ser diseñados por especialistas en interfaces. De ahí se desprenden tres salidas: (1) facilitar que se diseñen sitios razonables sin ser experto; (2) formar a más gente en diseño o (3) resignarse a un ecosistema web difícil de usar. Mediante la analogía con una tienda física, Baeza-Yates explica que la desorganización, la mala ayuda y la dificultad para encontrar lo que se busca llevan al abandono del sitio, algo frecuente en cualquier ámbito, no solo en comercio electrónico.

El éxito de una página depende de su facilidad de uso y de localización

Sobre esa base, el artículo articula dos conceptos clave en la web: ubicuidad y usabilidad. Primero, un sitio debe ser “ubicuo”: poder ser encontrado y accedido. La ubicuidad se descompone en buscabilidad (que el sitio sea localizable, especialmente a través de buscadores) y visibilidad (que el sitio pueda verse y cargue adecuadamente en condiciones técnicas diversas). Esto implica acciones concretas: asegurar que los buscadores puedan rastrear el sitio (registro, enlaces entrantes, evitar barreras como Flash, mapas de imagen, ‘frames’ o JavaScript mal usado), cuidar el vocabulario de la página principal para que coincida con los términos de los usuarios, y mejorar la posición con enlaces y metadatos (con cautela por el “spam” de metadatos). La visibilidad, por su parte, exige ligereza (tamaños moderados), compatibilidad con distintos navegadores y sistemas, y atención a la accesibilidad (WAI), recordando que los robots de búsqueda “son ciegos” y que los enlaces textuales ayudan a usuarios y buscadores.

Después, una vez que el sitio se encuentra y se ve, entra la usabilidad, definida (Norma ISO 9241-11) como efectividad, eficiencia y satisfacción en un contexto de uso. Se revisan atributos clásicos (aprendizaje, velocidad, errores, retención, satisfacción) y otros complementarios (control, apoyo a habilidades, privacidad). Finalmente, se expone la ingeniería de usabilidad y la evaluación como núcleo del proceso: inspecciones, pruebas con usuarios, pensar en voz alta, evaluaciones heurísticas, caminatas cognitivas y encuestas. El texto culmina con heurísticas y recomendaciones prácticas (consistencia, prevención de errores, diseño minimalista, rapidez, compatibilidad, diseño para diversidad, escritura concisa), subrayando que la verdadera meta es la fidelidad del usuario: que encuentre, use, se “seduzca” y regrese.

El Modelo del Espacio Vectorial: similitud entre vectores.

representación de la función del coseno para calcular la similitud de dos vectores de documentos en recuperación de información

En algunas partes de esta web hablamos de Gerad Salton y de «su Modelo del Espacio Vectorial que implementan la mayoría de los motores de búsqueda lo implementan como estructura de datos y que el alineamiento suele realizarse en función del parecido (o similitud) de la pregunta con los documentos almacenados. Viniendo hacia el trabajo me he parado a pensar que igual muchos no saben cómo funciona realmente este modelo y que no sería nada malo dedicarle una pequeña serie de posts para explicarlo. Vamos a ello.

La idea básica de este modelo reside en la construcción de una matriz (podría llamarse tabla) de términos y documentos, donde las filas fueran estos últimos y las columnas correspondieran a los términos incluidos en ellos. Así, las filas de esta matriz (que en términos algebraicos se denominan vectores) serían equivalentes a los documentos que se expresarían en función de las apariciones (frecuencia) de cada término. De esta manera, un documento podría expresarse de la manera d1=(1, 2, 0, 0, 0, … … …, 1, 3) siendo cada uno de estos valores el número de veces que aparece cada término en el documento. La longitud del vector de documentos sería igual al total de términos de la matriz (el número de columnas).

De esta manera, un conjunto de m documentos se almacenaría en una matriz de m filas por n columnas, siendo n el total de términos almacenamos en ese conjunto de documentos. La segunda idea asociada a este modelo es calcular la similitud entre la pregunta (que se convertiría en el vector pregunta, expresado en función de la aparición de los n términos en la expresión de búsqueda) y los m vectores de documentos almacenados. Los más similares serían aquellos que deberían colocarse en los primeros lugares de la respuesta.

¿Cómo se calcula esta similitud? Disponemos de varias fórmulas que nos permiten realizar este cálculo, la más conocida es la Función del Coseno, que equivale a calcular el producto escalar de dos vectores de documentos (A y B) y dividirlo por la raíz cuadrada del sumatorio de los componentes del vector A multiplicada por la raíz cuadrada del sumatorio de los componentes del vector B.

representación de la función del coseno para calcular la similitud de dos vectores de documentos en recuperación de información

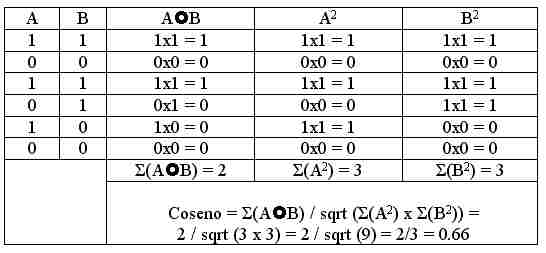
No hay que asustarse a la hora de oir hablar de «producto escalar de dos vectores», ya que se calcula multiplicando componente a componente y sumando los productos. Así, si disponemos de los vectores de documentos A (1, 0, 1, 0, 1, 0) y B (1, 0, 1, 1, 0, 0) su valor de similitud según la función del Coseno se calculará tal como podemos ver en la siguiente tabla:

tabla de ejemplo de cálculo de la función de similitud del coseno

De esta manera tan sencilla se calcula este valor de similitud. Como es obvio, si no hay coincidencia alguna entre los componentes, la similitud de los vectores será cero ya que el producto escalar será cero (circunstancia muy frecuente en la realidad ya que los vectores llegan a tener miles de componentes y se da el caso de la no coincidencia con mayor frecuencia de lo que cabría pensar). También es lógico imaginar que la similitud máxima sólo se da cuando todos los componentes de los vectores son iguales, en este caso la función del coseno obtiene su máximo valor, la unidad. Lo normal es que los términos de las columnas de la matriz hayan sido filtrados (supresión de palabras vacías) y que en lugar de corresponder a palabras, equivalgan a su raíz ‘stemmed’ (agrupamiento de términos en función de su base léxica común, por ejemplo: economista, económico, economía, económicamente, etc.). Generalmente las tildes y las mayúsculas/minúsculas son ignorados. Esto se hace para que las dimensiones de la matriz, de por sí considerablemente grandes no alcancen valores imposibles de gestionar. No obstante podemos encontrar excepciones a la regla general, tal como parece ser el caso de Yahoo!, que no ignora las palabras vacías.

Para finalizar, la del coseno no es la única función de similitud. Existen otras, entre las que destacan las de Dice y Jaccar, pero que pueden resultar algo más engorrosas no sólo de calcular sino más bien de interpretar y que por tanto son menos aplicadas en Recuperación de Información

Precisión y exhaustividad normalizadas en recuperación de información

Entre las medidas de la recuperación de informació alternativas a la relevancia encontramos la Exhaustividad Normalizada como propuesta de diversos autores. Casi todo el mundo reconoce que el mayor problema de las medidas basadas en la relevancia es la alta dosis de subjetividad inherente a su determinación. Otro de los problemas que conlleva su uso reside en la secuencialidad de la lectura de los resultados.Korfhage avisa: “los sistemas de recuperación de información típicos presentan los resultados formando una secuencia de documentos. Incluso en aquellos sistemas que no presentan así la información, el usuario suele examinar los documentos secuencialmente» (Korfhage, 1997). Inevitablemente, este modo de consulta afectará al juicio que el usuario ha de llevar a cabo sobre la relevancia o no de los documentos siguientes.

En la práctica, todos los usuarios de estos sistemas sufren este problema cuando, al consultar dos documentos más o menos igual de interesantes y relacionados con una materia, centran su atención de forma preferente en el primero de ellos, aunque el segundo no desmerezca en nada al anterior. Algo parecido acaece cuando un usuario realiza una búsqueda y los primeros documentos recuperados resultan relevantes con el tema de su interés. En esta circunstancia, el usuario tendrá una sensación positiva y se considerará satisfecho, no preocupándose por el número de documentos no relevantes que también recupera (que puede llegar a ser muy grande). La situación contraria también ocurre cuando la presencia de los documentos no relevantes al principio de la respuesta es masiva. En este caso la sensación de frustración va a ser de gran consideración, independientemente de que en el global de la búsqueda se entreguen muchos más documentos relevantes que no relevantes.

Estas reflexiones han propiciado el desarrollo de medidas que tomen en consideración la secuencia en la que los documentos son presentados a los usuarios. El primer trabajo conocido corresponde a Rocchio (citado en [Rijsbergen, 1999] y en [Moschitii, 2003]), quien define una exhaustividad normalizada y una precisión normalizada para sistemas que presentan los documentos alineados según un determinado criterio de clasificación y donde no afecte el tamaño de la muestra analizada. El autor define un “sistema ideal donde los documentos relevantes se recuperan antes que los documentos no relevantes y se puede representar en un gráfico la evolución de la exhaustividad de esta operación de recuperación de información”. 

e-p normalizadas
Ejemplo de cómo la Exhaustividad normalizada queda comprendida entre el peor y el mejor resultado posible. Fuente: Rijsbergen, C.J. Information Retrieval. [En línea]. Glasgow, University, 1999.[Consulta: 29 noviembre 2004]
Si en una base de datos de 25 documentos se sabe que cinco de ellos son relevantes, y que han sido devueltos por el sistema al realizar una búsqueda en las posiciones {3, 5 , 10, 11, 15}, se puede representar un gráfico etapa a etapa (tal como muestra la imagen anterior). La exhaustividad de esta búsqueda alcanza el valor de 0.2 (1 documento relevante recuperado dividido entre 5 documentos relevantes de la colección) al analizar el tercer documento (hasta entonces vale cero). Cada vez que se analice un documento relevante, el valor de la exhaustividad aumentará, hasta llegar a la unidad (en este caso, en el documento 15), permaneciendo constante hasta el último documento recuperado, ya que todos los relevantes ya han aparecido. Tal como se desprende de la comparación con la gráfica de la mejor búsqueda posible (cuando se presentan los cinco documentos relevantes en las cinco primeras posiciones de la secuencia) o con la peor búsqueda posible (cuando se presentan los cinco documentos relevantes en las cinco últimas posiciones de la secuencia), resulta muy intuitiva, tal como se refleja en la anterior imagen.

Para Korfhage, “el área comprendida entre la búsqueda actual y la gráfica ideal representa una medida de la ejecución del SRI” (Korfhage, 1997). Esta medida se calcula restando al valor de la unidad el resultado de dividir el valor de esta área por (n1 * (N – n1)). En el ejemplo anterior, el valor del área es 29, por lo que el valor de la exhaustividad normalizada, aplicando la anterior fórmula, será el resultado de la siguiente operación: (1 – 21/(5 * (25 – 5)) = (1 – 0.21) = 0.79

La precisión normalizada se define de manera análoga: “mientras la precisión ordinaria es una medida exactamente definida, esta medida depende del conocimiento del número total de documentos relevantes” (Korfhage, 1997). Rijsbergen propone como método para su cálculo “restar a la unidad el resultado de dividir el valor de esta área por el valor del área existente entre la búsqueda ideal y la peor búsqueda” (Rijsbergen, 1999). En el ejemplo propuesto, el resultado de esta precisión normalizada sería (1 – 21/(95 – 15)) = (1 – 21/80) = 0.7375. Rijsbergen destaca algunos aspectos de estas medidas: “ambas presentan un comportamiento consistente, es decir, cuando una se aproxima a cero la otra se aproxima a la unidad. Ambas medidas asignan valores distintos de peso a los documentos recuperados en la secuencia, la precisión los asigna a los iniciales y la exhaustividad asigna un valor uniforme a todos los documentos relevantes. En tercer lugar, estas medidas pueden entenderse como una aproximación de la precisión y exhaustividad promedio y, por último, los problemas que surgían en la determinación de la longitud esperada de búsqueda (por la posición de los documentos relevantes), son inexistentes en este caso”.

Bibliografía.

(Korfhage, 1997) Korfhage, R.R. Information Retrieval and Storage. New York: Wiley Computer Publisher, 1997.

(Moschitti, 2003) Moschitti, A. ‘A study on optimal parameter tuning for Rocchio Text Classifier’. ECIR 2003 [En línea][Consulta: 29 noviembre 2004]

(Risjbergen, 1999) Risjbergen, C. J. Information Retrieval. [En línea]Glasgow, University, 1999.[Consulta: 29 noviembre 2004]