Recuperación de información

¿Qué es «contenido de calidad» para Google?

El contenido de calidad es esencial para Google

Contenido de calidad para Google es el que cumple con los principios de utilidad, relevancia y confiabilidad, mientras se optimiza para las necesidades de los usuarios. Este concepto ha evolucionado con el tiempo e incluye ahora una atención especial al alineamiento con los principios E-E-A-T.

El contenido de calidad es el principal factor que considera Google para su ranking.

(a) Los principios E-E-A-T: Experiencia, Conocimientos, Autoridad y Confiabilidad

  1. Experiencia (‘experience’): es bueno que el creador del contenido posea experiencia práctica y directa en el tema tratado. Esto incluye anécdotas, casos de uso y resultados obtenidos de primera mano, relevantes sobre todo en industrias como portales de viajes o productos especializados.
  2. Conocimientos (‘expertise’): relacionado con el anterior principio, es conveniente que el contenido sea escrito por alguien con un conocimiento técnico o especializado en el tema (en medicina un médico o un investigador biosanitario, en derecho un magistrado o un fiscal, etc.). También se puede traducir como «pericia».
  3. Autoridad (‘authoritativeness’): principio vinculado con la reputación del creador y de la fuente. Incluye menciones por otros expertos y enlaces entrantes de sitios confiables. Google valora el contenido que sea verdadera referencia dentro de un sector. Google evalúa la autoridad analizando factores como la calidad de las fuentes que enlazan al contenido y las menciones del autor o sitio web en medios confiables. Un sitio web o creador de contenido que es considerado la fuente definitiva en un tema tiene una autoridad muy alta.
  4. Confiabilidad (‘trustworthiness’): principio relacionado con la precisión y seguridad del contenido. Aquello sitios web con errores, datos imprecisos o que no usen el protocolo seguro https, afectan negativamente a la percepción del contenido.  La confianza se evalúa con base en la precisión, honestidad, seguridad y fiabilidad del contenido del sitio web en general. Factores como la transparencia en la información de contacto, la explicación de políticas claras, la seguridad del sitio web y la concreción y precisión en la información proporcionada (‘clickbaits‘ fuera por favor), contribuyen a la confiabilidad.
Explicación de los principios E-E-A-T. Fuente: SEMrush

Factores y Criterios de Evaluación del Contenido de Calidad

En la siguiente tabla recogemos los factores clave que Google considera para valorar la calidad del contenido de un sitio web en la primera columna. En la segunda presentamos el enfoque distintivo del análisis de cada autor como factor particular o estrategia central resaltada como clave para mejorar la calidad del contenido.

AutorPrincipales Factores de CalidadEnfoque Distintivo
Iqra JamalNarrativa atractiva, datos originales y actualización constante.Uso de ‘storytelling‘ para conectar emocionalmente con el usuario.
Search Engine JournalIntención de búsqueda, estructura organizada y contenido optimizado técnicamente.Adaptación a diferentes etapas del viaje del usuario.
SlickplanUso de multimedia, organización lógica y profundización temática.Diseño visual como una herramienta de engagement clave.
Stellar ContentE-E-A-T, claridad de lenguaje y relevancia cultural.Localización cultural del contenido para mayor resonancia.
ContentGoAutoridad, confiabilidad y optimización semántica.Enfoque en el uso de datos verificados por expertos reconocidos.
Ethan LazukEnfoque «people-first», interactividad y utilidad directa.Diseño enfocado en resolver necesidades reales de los usuarios.
Chevron EditingConcisión, estructura lógica y palabras clave estratégicas.Simplificación de mensajes sin perder el impacto técnico.
Kopp Online MarketingMétricas de experiencia del usuario (tiempo en página, interacción).Uso de datos analíticos para afinar contenido a las necesidades del público.
Marketing InsiderCalidad editorial, investigaciones únicas y formato amigable para compartir.Creación de contenido alineado a las demandas del marketing digital actual.
Akhtar & ResearchGateOptimizaciones en metadatos, ‘backlinks‘ y experiencia de usuario.Conexión entre calidad del contenido y SEO técnico estratégico.
Cameron-KitchenTono conversacional, ‘engagement‘ y adaptabilidad técnica.Optimización de contenido mediante pruebas continuas de audiencia.

Fuentes empleadas para el resumen.

Iqra Jamal. How I Create Top-Quality Content and Rank High on Google: A Step-by-Step Guide – https://www.linkedin.com/pulse/how-i-create-top-quality-content-rank-high-google-guide-iqra-jamal-ffzuf/
Search Engine Journal. How To Create High-Quality Content. https://www.searchenginejournal.com/how-to-create-high-quality-content/254511/
Slickplan. Create quality content for SEO success: how-to guide. https://slickplan.com/blog/quality-content-for-seo
Stellar. How to Create a SEO Content Strategy for 2024. https://www.stellarcontent.com/blog/content-marketing/how-to-create-a-seo-content-strategy/
ContentGo. The Role of Content in Google’s E-E-A-T snd How to Create High-Quality Content. https://blog.contentgo.com/the-role-of-content-in-googles-e-e-a-t-and-how-to-create-high-quality-content/
Ethan Lazuk. People Tell Me What to Say: Creating Helpful, Reliable, People-First Content for Google Search in 2024 & Beyond (An SEO Deep Dive). https://ethanlazuk.com/blog/people-first-content/
Module 4 – Content Optimisation The Cornerstone of SEO – https://cromsalvatera.com.au/content-optimisation-seo/

Chevron Editing. High-Quality Content: What is it? https://chevronediting.com.au/high-quality-content/
Helpful content: What Google really evaluates? – https://www.kopp-online-marketing.com/google-helpful-content
Stellar. Boost SERP rankings with user-first content for SEO. https://www.stellarcontent.com/blog/seo/boost-serp-rankings-with-user-first-content-for-seo/
Thrive. Google’s Helpful Content Now Included in Core Ranking. https://thriveagency.com/news/quality-ranking-googles-helpful-content-now-included-in-core-ranking-system/
Akstar Bristi. Mastering SEO — A Step by Step Guide to Increasing Google Rankings and Get More Website Visitors, https://www.linkedin.com/pulse/mastering-seo-step-guide-increasing-google-rankings-get-aktar-bristy-bb6wc/
Moss 51. How I should write web pages. https://moss51.com/how-to-write-website-content/
Marketing Insider Group. Google Makes It Official: Content Marketing Is Now the #1 Ranking Factor – https://marketinginsidergroup.com/content-marketing/google-makes-it-official-content-marketing-is-now-the-1-ranking-factor/
Saud Akhtar & Jamia Milia Islamia. SEO Secrets Revealed: Techniques for Higher Rankings. https://www.researchgate.net/profile/Saud-Akhtar/publication/377981890_SEO_Secrets_Revealed_Techniques_for_Higher_Rankings/links/65c1d1ec34bbff5ba7ef9a66/SEO-Secrets-Revealed-Techniques-for-Higher-Rankings.pdf
Tim Cameron-Kitchen. How To Get To The Top of Google. https://exposureninja.com/wp-content/uploads/2016/10/How-To-Get-To-The-Top-of-Google-2022.pdf

Factores «clave» del contenido web para el ranking de Google

La web Backlinko dedica una página informativa sobre los factores de alineamiento de Google ofreciendo una guía exhaustiva de más de 200 elementos que influyen en el algoritmo. Su propósito es «educar» a las personas que administran sitios web y a profesionales del SEO sobre cómo mejorar la posición de sus páginas en los resultados de búsqueda. En este análisis dividen los factores en categorías clave, como la calidad del contenido, ‘backlinks‘ y la experiencia del usuario (UX) y aspectos técnicos tales como la velocidad de carga y la optimización para el escosistema móvil. También se analizan señales de comportamiento del usuario y actualizaciones constantes del algoritmo.

Imagen inspirada en el ranking de Google creada con Delle - 3, la IA para gráficos de chatgpt
El ranking de Google dibunado por Delle – 3

En la siguiente tabla recogemos una síntesis de los once (como si fuera una alineación de un equipo de fútbol) factores que más se destacan en este artículo.

FactorDescripciónEjemplo
Calidad del ContenidoGoogle prioriza contenido de alta calidad, informativo y relevante.Un artículo detallado y bien investigado sobre un tema específico que responde completamente a las preguntas de los usuarios.
‘Backlinks‘ (enlaces entrantes)Los enlaces de otros sitios web actúan como votos de confianza. Cuantos más enlaces de entrada de alta calidad tenga tu sitio, mejor se posicionará.Un sitio web que recibe enlaces de universidades y sitios de noticias reconocidos.
SEO TécnicoAspectos técnicos del sitio web, como la velocidad de carga, la compatibilidad con dispositivos móviles y la capacidad de rastreo.Un sitio web optimizado para cargar rápidamente en dispositivos móviles y que utiliza un archivo robots.txt adecuado para permitir el rastreo de los motores de búsqueda.
Optimización de palabras claveUso de palabras clave relevantes en el contenido del sitio web para ayudar a los motores de búsqueda a entender de qué trata el sitio.Un blog de recetas que utiliza palabras clave como “recetas saludables” y “comida vegana” en sus artículos.
Experiencia del usuario (UX)Medida de lo fácil y agradable que es para los usuarios utilizar el sitio web. Google prefiere sitios que proporcionan una buena experiencia de usuario.Un sitio web con una navegación intuitiva, tiempos de carga rápidos y diseño responsive.
Marcado de esquema (Schema Markup)Datos estructurados que se pueden añadir al sitio web para ayudar a los motores de búsqueda a entender mejor el contenido.Un sitio de comercio electrónico que utiliza marcado de esquema para mostrar reseñas de productos y precios directamente en los resultados de búsqueda.
Señales socialesInteracciones sociales como “me gusta”, “compartir” y otros. Aunque no son un factor directo, pueden influir en la visibilidad del contenido.Un artículo que recibe muchas comparticiones en redes sociales como Facebook y Twitter.
Señales de marcaLa percepción general de la marca en línea. Google favorece marcas bien conocidas y respetadas.Un sitio web de una marca reconocida que recibe menciones en medios de comunicación y tiene una fuerte presencia en redes sociales.
Edad del dominioLos dominios más antiguos pueden tener una ligera ventaja, ya que se consideran más confiables.Un sitio web que ha estado activo durante más de 10 años y ha mantenido un historial constante de contenido de calidad.
Velocidad de carga del sitioLa rapidez con la que se carga un sitio web es un factor importante, especialmente en dispositivos móviles.Un sitio web que utiliza técnicas de optimización como la compresión de imágenes y el almacenamiento en caché para mejorar los tiempos de carga.
Intención de búsquedaLa capacidad del contenido para satisfacer la intención del usuario en el momento de la búsqueda.Un artículo que proporciona una guía completa y detallada sobre “cómo plantar un jardín de hierbas” cuando los usuarios buscan información sobre jardinería.
RTabla resumen de los 11 factores más importantes en el ranking de Google. Fuente: Backlinko

Como pasa con las selecciones de fútbol donde cualquier aficionado o aficionada tiene su propio «once«, si buscamos en otras páginas web es más que seguro que algunas de estas características no sean consideradas por sus autores e incluyan otras que hemos dejado fuera. Es ley de vida.

Evan Bailyn, CEO de la empresa de SEO ‘First Page Sage‘, escribió en diciembre de 2021 un artículo en Linkedln una nota informatica titulada ‘The 2022 Google Algorithm Ranking Factors‘ donde presentaba los factores ordenados a partir de su «peso» en la fórmula final del algoritmo de ranking, que podemos visualizar en el siguiente diagrama circular.

peso de los distintos factores del algoritmo de ranking de Google en 2022

Como se observa, un 26% de la fórmula final se debe al contenido de calidad (de alto nivel se menciona), un 17% se le asigna a las metaetiquetas del título de la página, los enlaces de entrada (‘backlinks‘) tienen un peso del 15% (con Pagerank era el factor clave, desde 2018 ha descencido mucho en importancia). También tiene importancia la presencia de esa página entre lo que se considera «nichos de expertos» (13%) y la involucración de los usuarios (fidelidad) que alcanza el 11%. Entre estos cinco factores suman un poco más del 75% del peso de la fóruma final según Evan Bailyn. Aquí va la tabla completa.

factores principales del algoritmo de Google según firstpagesage.com

¿Qué es «contenido de calidad» para Google?

Son varios aspectos a considerar:

Se trata de contenido original, único y valioso. Google da preferencia al contenido nuevo y único. Es conveniente crear entradas que respondan a las preguntas de sus lectores, que aporten valor y que sean originales. Como regla general, Google premia el contenido de liderazgo intelectual producido al menos dos veces por semana. Si tu contenido es similar al de otras páginas web, causará un impacto negativo en tu SEO. Para empezar, el motor podría no indexar y clasificar la página y ralentizará la tasa de rastreo de su sitio web (la web se hará “obsoleta”). Por lo tanto, cuando creemos contenido, ha de ser diferente y mejor que el de otros sitios web clasificados para el término de búsqueda. Ya lo avisaba Bill Gates en 1996 en su frase «Content is king» (que viene a ser I Ley Universal de la Gestión de Contenidos en la Web para mis alumnos).

Hay que mantener el contenido fresco y actualizado. Si las publicaciones se actualizan y se añade habitualmente información  nueva, se envía una señal positiva al motor de búsqueda. La frescura del contenido juega un papel importante si en nuestras entradas se tratan noticias o tendencias. En estos casos, Google prefiere las páginas que proporcionan la información más reciente. Por ejemplo, si escribimos sobre la crisis sanitaria mundial, nuestro contenido debe contener noticias e investigaciones recientes. Una forma sencilla de encontrar la información más reciente para mantener tu contenido fresco es utilizar Google Trends.

La longitud del contenido es otro factor clave. Una de las preguntas recurrentes en SEO ha sido siempre si la extensión del contenido forma parte de los factores de clasificación de Google. La respuesta es “SÍ”. Según diferentes estudios, los posts con 1.890 palabras de media se sitúan en la primera página de resultados. Dicho esto, no hay una regla rígida por la que debamos ceñirnos a un límite de palabras. Lo mejor es crear contenido con profundidad y que cubra un tema con gran detalle. Google prefiere las páginas que responden completamente a la pregunta del usuario y proporcionan soluciones detalladas.

longitud de entradas en la web y posición en google
Relación entre la longitud de una entrada web y la posición en la respuesta de Google.

La estructura del contenido y su organización también influye en la valoración de su calidad. Las entradas deben estar bien organizadas y estructuradas. Esto facilita a los visitantes la lectura y la búsqueda de soluciones a sus problemas. Para mejorar la estructura y la organización de estos artículos, se pueden utilizar distintos niveles de encabezado (H2, H3, H4, etc.) para agrupar el contenido. Mantener debidamente actualizado el fichero sitemap.xml ayuda también. También podemos utilizar etiquetas HTML para viñetas  y listas numéricas para organizar aún más el contenido. Esto es beneficioso ya que Google recoge estas listas y las muestra como fragmentos destacados para diferentes palabras clave.

El carácter selectivo de la recuperación de información

Cubierta del libro ‘Language and representation in information retrieval’, de DC Balir

Uno de los libros fundamentales sobre recuperación de información es la obra ‘Language and representation in information retrieval’ de D.C. Blair de 1990. Y una de sus principales aportaciones es, sin duda alguna, el llegar a establecer una clara diferenciación entre el término ‘data retrieval’ y el término ‘information retrieval’, utilizando como criterios distintivos: 

  1. En recuperación de datos se usan preguntas altamente formalizadas, cuya respuesta es directamente la información deseada. En cambio, en recuperación de información las preguntas resultan difíciles de trasladar a un lenguaje normalizado (aunque existen lenguajes para ello son de naturaleza mucho menos formal que los empleados en los sistemas relacionales) y la respuesta es un conjunto de documentos que pueden contener, sólo probablemente, lo deseado, con un evidente factor de indeterminación.
     
  2. De lo anterior y según la relación entre el requerimiento al sistema y la satisfacción de usuario, la recuperación de datos es determinista y la recuperación de información es posibilista, por causa del nivel de incertidumbre presente en la respuesta.
     
  3. En cuanto al éxito de la búsqueda, en recuperación de datos el criterio a emplear es la exactitud de lo encontrado, mientras que en recuperación de información, el criterio de valor es el grado en el que la respuesta obtenida satisface las necesidades de información del usuario, es decir, su percepción personal de utilidad, más conocido como la relevancia de la respuesta..
Diferencias entre búsquedas de datos y de información.
Imagen elaborada con chatGPT.

Jesús Tramullas destaca un aspecto de las reflexiones de Blair, “la importancia, en ocasiones ignorada, que tiene el factor de predicción por parte del usuario, ya que éste debe intuir, en numerosas ocasiones, los términos que han sido utilizados para representar el contenido de los documentos, independientemente de la presencia de mecanismos de control terminológico. Este criterio de predicción es otro de los elementos que desempeñan un papel fundamental en el complejo proceso de la recuperación de información” y que no se presenta en el campo de la recuperación de datos.

El primer método de evaluación de los buscadores web

tabla de comparativa de la efectividad de dos buscadores web

tabla de comparativa de la efectividad de dos buscadores webSin duda alguna, el honor de haber propuesto el primer método de evaluación de los sistemas de recuperación de información en la web le corresponde a Heiting Chu y Marilyn Rosenthal, quienes en el año 1996 (prácticamente en el inicio del desarrollo de los buscadores web) publicaron el trabajo ‘Search Engines for the World Wide Web: A Comparative Study and Evaluation Methodology‘ con motivo de la conferencia ASIS’96.

Se compararon tres sistemas de búsqueda (AltaVista, Excite y Lycos), midiendo  sus capacidades de búsqueda (por ejemplo, lógica booleana, truncamiento, búsqueda por campos, búsqueda de palabras y de frases) y de su rendimiento en la recuperación de información (es decir, precisión y tiempo de respuesta), utilizando consultas de ejemplo extraídas de preguntas reales de referencia.

La exhaustividad (recall), el otro criterio clásico de evaluación en recuperación de información, se omite deliberadamente en este estudio, ya que resulta imposible suponer cuántos ítems relevantes existen para una consulta determinada dentro del enorme y cambiante sistema de la web. Ya adelantaba este estudio pionero la poca utilidad de calcular esta ratio en este contexto (nadie aspira a consultar la mayor parte de la respuesta, con la primera y/o segunda página de resultados va a ser suficiente).

Los autores del estudio constataron que AltaVista superaba a Excite y Lycos tanto en las funcionalidades de búsqueda como en el rendimiento de recuperación, aunque Lycos presentaba la mayor cobertura de recursos web entre los tres motores de búsqueda analizados.

Como resultado de esta investigación, se propuso además una metodología para evaluar otros motores de búsqueda web no incluidos en el presente estudio.

Los primeros buscadores de la web

En otra entrada comentamos que la expansión de la web a principios de los años 90 pronto desbordó el entorno académico, hábitat natural de internet, y comenzó a expandirse por otros ámbitos: administraciones, empresas, medios de comunicación y particulares (algo más adelante con los blogs), publicándose páginas y sitios web por su cuenta.

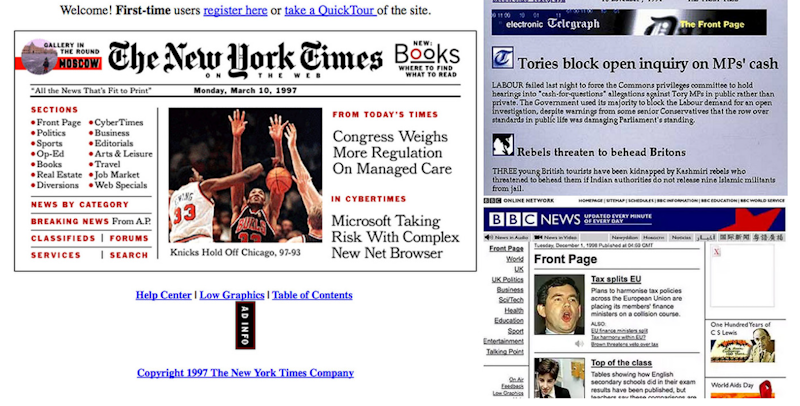
Algunos sitios web de prensa de los años 90

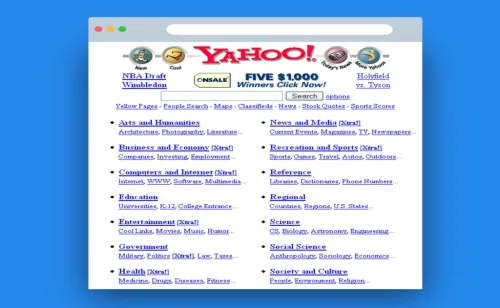
En estos primigenios sitios de la «Web 1.0” era frecuente incluir una página con enlaces a otras páginas que parecían interesantes y podían permitir ampliar información a los lectores, a modo de «misceláneas«. Se puede que esto era replicar, en cierto modo, el muy tradicional servicio de referencia que desde tiempos inmemoriales llevan a cabo las personas que trabajan en las bibliotecas. Esto constituyó el germen para el desarrollo de los primeros sistemas de recuperación de información (SRI) en la web: los índices o directorios, sistemas de los cuales Yahoo! fue durante un tiempo el mejor ejemplo.

Estos SRI, como muchos recordamos todavía, son un producto documental considerado una fuente de información de carácter secundario porque dirige a la fuente original, justo lo que hacían y actualmente hacen estos sistemas de recuperación. Una actividad de gestión de información vuelve a confluir con la tecnología de la web. Se llevaba a cabo un seguimiento generalista y se registraban apenas unas pocas páginas de cada sitio web, a diferencia de los motores de búsqueda cuyo propósito es indexar la totalidad de un sitio web (o intentarlo al menos).

Pantalla de inicio de yahoo directory

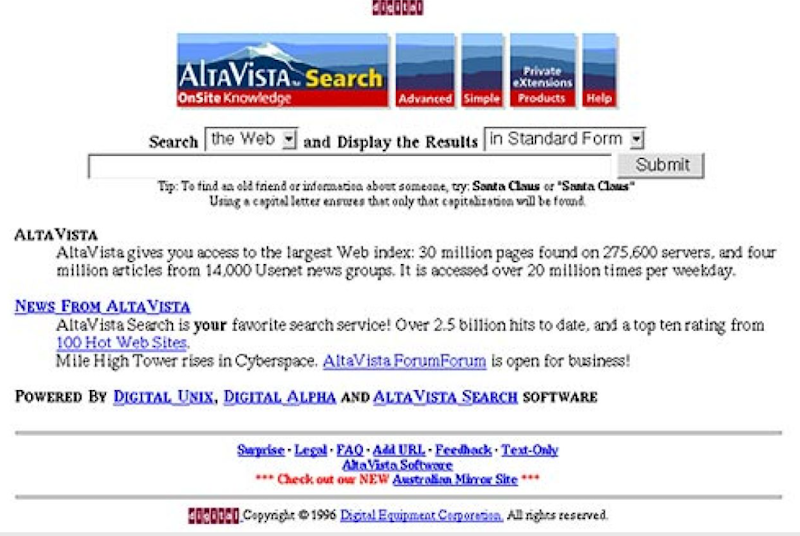
Con el paso del tiempo, el vertiginoso crecimiento de la web hizo imposible el rastreo manual de los nuevos sitios que iban surgiendo ni la actualización del contenido ya rastreado. El día que Yahoo! se convirtió en motor de búsqueda tras comprar Altavista, comenzó el final definitivo de estos sistemas.

pantalla principal del antiguo buscador Altavista

1989-2014: WWW, de una propuesta de gestión de información a un universo de información

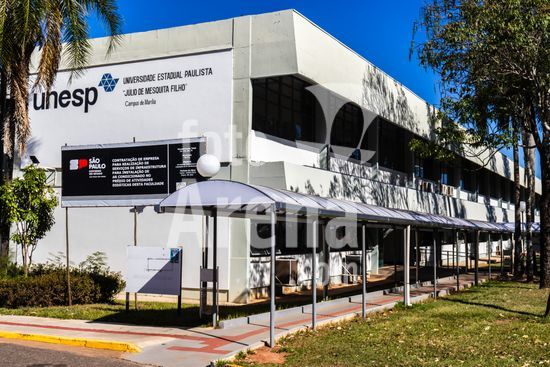
En noviembre de 2014 estuve de visita en la Universidade Estadual Paulista «Julio de Mesquita Filho», más concretamente en el Campus de Marilia. El motivo de la misma fue participar en el Programa de Posgrado de Ciencias de la Información, impartiendo una conferencia el segundo día de mi estancia y un seminario sobre recuperación de datos y recuperación de información al final de la misma. Antes de proseguir quiero agradecer a los compañeros y estudiantes brasileños sus muchas atenciones hacia mi persona, son unos grandes anfitriones y mejores personas.

Edificio de aulas del campus de Marilia en la UNESP
Faculdade de Filosofia e Ciências – Universidade Estadual Paulista «Júlio de Mesquita Filho» – Câmpus de Marília (UNESP).

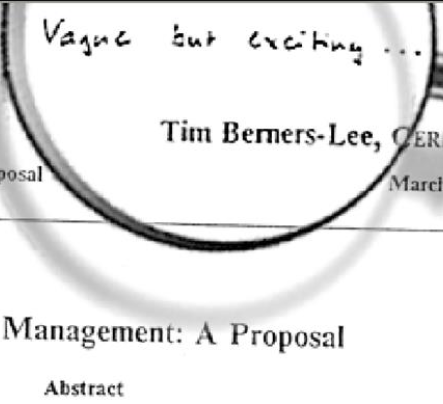
La conferencia se titulaba «1989-2014: WWW, de una propuesta de gestión de información a un universo de información por descubrir» y en la misma llevaba a cabo un pequeño homenaje a la creación de la WWW por parte de Berners-Lee como una propuesta de nuevo sistema para la gestión de la información, algo que muchos desconocen. 

fragmento de la primera página de la propuesta de Tim Berners Lee sobre la WWW
Fragmento de la portada de la propuesta de Tim Berners Lee sobre la WWW

He revisado algunos errores en la redacción original del texto de la conferencia y la he publicado en el respositorio Digitum de nuestra universidad. Espero que guste, hice un amplio recopilatorio de hitos y conceptos alrededor de la gestión y de la recuperación de información.   

Microdatos en páginas estáticas.

microdatos en páginas web - rich snnipets

Dedicamos una entrada al enriquecimiento de los sitios web con microdatos y, si bien pienso que creo quedó bastante completa, también es verdad que quedó algo teórica de más. Vamos a intentar mostrar algunas aplicaciones prácticas. Lo primero que vamos a hacer es recordar qué es un ‘Rich Snippet‘.

En la jerga de la web un ‘snippet‘ es el pequeño resumen informativo que aparece en un motor de búsqueda cuando se localiza una página web. Cuando «delegamos» en el motor la tarea de elaborar ese resumen de forma automática suele incluir las primeras palabras que encuentra en la página y lo cierto es que no suelen quedar muy bien, que digamos, Por ello, existe la posibilidad de personalizar de alguna manera esa presentación informativa aportando nosotros los datos, es decir, aportando microdatos.

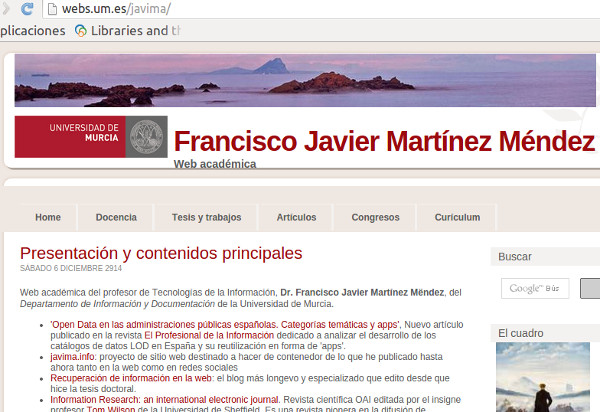
página principal de la web académica de Francisco Javier Martínez Méndez en la UMU

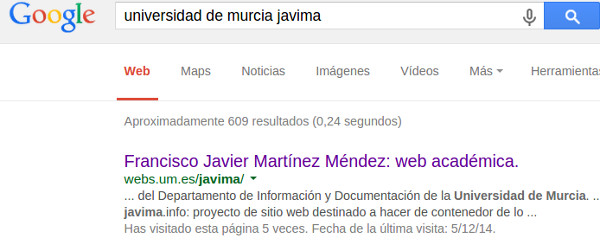
Si tomamos como punto de partida mi página web académica en la Universidad de Murcia , el ‘snippet’ que ofrece Google es el siguiente:

datos estructurados Microdatos snippets Google

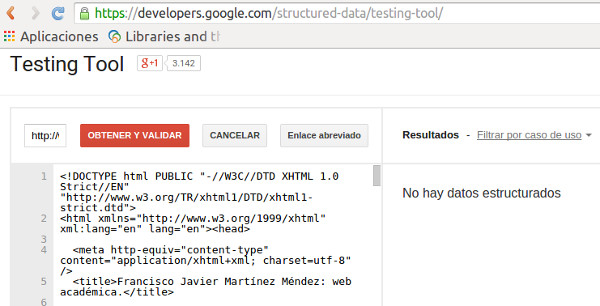
En estos resultados observamos que Google ha elegido algunas palabras de la presentación de esta página como las más representativas para diseñar el ‘snippet’. Esto se debe a que no ha encontrado texto enriquecido que el administrador de la misma haya querido destacar de alguna manera para que aparezca resaltado en la presentación de la misma por parte del motor de búsqueda. De hecho, si usamos la herramienta ‘Testing Tool’ de Google para verificar la presencia de microdatos, éste sería el resultado:

datos estructurados Microdatos snippets Google

Continuando con la tecnología que ofrece Google para trabajar con datos estructurados, encontramos un asistente para introducir este tipo de código en las páginas. Una vez hemos accedido a esta página nos encontramos con un pequeño inconveniente, el asistente solicita la URL (o el fragmento de texto) a enriquecer y el tipo de página web que queremos enriquecer (si se trata de una página de negocio local, de serie de televisión, de películas o de eventos, entre otras limitadas opciones que ofrece la iniciativa schema.org). Podemos entonces hacer dos cosas, incluir nosotros los microdatos directamente como hicimos en el post anterior (algo lento y farragoso), o bien intentar adaptarnos a lo más parecido de la «oferta» que disponemos. En nuestro caso vamos a optar por lo segundo y elegimos «Negocio local».

datos estructurados Microdatos snippets Google página web académica Francisco Javier Martínez Méndez

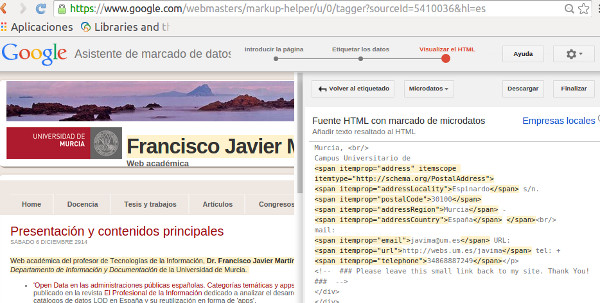
Aparecen dos subventanas, una es la página a enriquecer con microdatos, la otra es el asistente con los elementos de descripción previsto para «Empresa o Negocio local». De lo que se trata ahora es de ir marcando textos o imágenes en la subventana de la izquierda e ir asignándole elementos (marcas) en la subventana de la derecha, de la manera que se ve en la siguiente imagen:

datos estructurados Microdatos snippets Google página web académica Francisco Javier Martínez Méndez

En la imagen anterior se observa que hemos asignado marcas a textos e imágenes de la página objeto de mejora. El siguiente paso es generar ese texto enriquecido (parte del mismo se resalta en la imagen siguiente en la subventana de la derecha).

datos estructurados Microdatos snippets Google página web académica Francisco Javier Martínez Méndez

Lo siguiente que hemos de hacer es descargar ese texto y usarlo para sustituir el de la página original (la que no tiene datos estructurados). Transferir esa nueva página  a la web académica de la Universidad de Murcia y dejar al motor Google un tiempo prudencial para que la reindexe y podamos comprobar si hay algún efecto sobre el ‘snippet’.

El «ego organizacional» y la confianza en un sitio web

Gerry McGovern escribió en New Thinking sobre los problemas de «ego» en las organizaciones y cómo están acabando con la confianza que un sitio web transmite a sus visitantes. Pone como ejemplo la web de una organización ya de por sí no muy estimada – el Fondo Monetario Internacional – dirigido (tanto en la realidad como en su sitio web) por la política francesa Christine Lagarde.

Es muy posible que la vista de la página que tenía el autor en diciembre de 2014 no sea exactamente la que reproducimos ahora unos meses más tarde. El tema de diseño elegido dedica un porcentaje importante de la pantalla a un carrusel de diapositivas (cinco en este caso) que enlazan con distintos temas de interés para los responsables de esta web. La primera de ellas es la que estamos viendo, dedicada a una intervención de la directora del este organismo ante el Consejo Atlántico  (la más alta autoridad de la OTAN) y cuyo vídeo también podemos visualizar rápidamente porque ocupa uno de los cuatros «subtemas de interés» que se presentan en formato de recuadro en el centro de la pantalla. Pero está claro que la visita que hizo el autor en diciembre no debió de satisfacerle especialmente:

«Dominando la página aparece la jefa del FMI, Christine Lagarde, con una gran foto de sí misma. En lenguaje imperativo se informa que Lagarde acoge con satisfacción el compromiso del grupo G-20 de las economías avanzadas y emergentes para intensificar los esfuerzos en el impulso del crecimiento económico y la creación de puestos de trabajo. Esta arcaica redacción está fuera de paso con el mundo de los medios sociales. Esto no es excepcional, si usted visita, por ejemplo, la página de Bangladesh, leerá títulos como: «Comunicado de Prensa: Declaración de Subdirector Gerente del FMI Naoyuki Shinohara, al término de su visita a Bangladesh». Como usted puede observar fácilmente, se trata de una verdadera Realeza FMI, .todo en cuanto al FMI se refiere a la página web, el mundo y el universo es todo acerca de ellos. No se trata de lo que el cliente quiere hacer, sino qué cosas increíbles están haciendo los funcionarios imperiosas del FMI (sin saber muy bien para qué, esto lo añado yo). Lo dicho: un desenfrenado ego«.

recreación con IA de la página comentada (la original es de 2014 y no la hemos encontrado)-
Recreación con IA de la página comentada (la original es de 2014).

Estamos ante un caso muy claro de ausencia de comunicación entre la organización y su entorno. Este organismo internacional (o quizá «supranacional» podríamos decir porque las naciones le importan lo justo, especialmente sin son pobres y mediterráneas), no considera que su sitio web pueda ser la puerta de entrada para que gobiernos y otras instituciones puedan interaccionar con ellos. No, para ellos, el sitio web es su escaparate donde ellos pueden mostrar lo buenos e inteligentes que son, aunque luego dediquen la mitad del año a justificar por qué han fallado las previsiones que habían realizado durante la mitad del año anterior. El FMI reproduce en su sitio web uno de los principales problemas con los que deben lidiar los gestores de información a la hora de diseñar la arquitectura de una sede web, no reproducir la estructura de poder orgánico de la organización en la sede web («egos» les llama McGovern), porque eso no va a aportar nada positivo para la experiencia de sus usuarios.

«Esa es la naturaleza de las grandes organizaciones, qué vamos a decir de ello ahora. La gestión de la cadena es de más arriba hacia abajo y del ego más grande al menor en ese sentido. Es cierto que así es el camino organizacional seguido desde los tiempos de los emperadores de Roma o de los faraones de Egipto. Pero lo que es diferente hoy en día es cómo vemos a las organizaciones. Muchas organizaciones no han cambiado, pero las personas y la sociedad sí, de hecho, cada día que pasa, dejamos de confiar en más organizaciones«.

Prosigue el autor citando diversas estadísticas sobre esa pérdida de confianza en los gobiernos a la que estamos asistiendo en la última década especialmente y que está propiciando cambios en los modos de funcionamiento de la sociedad (y esperemos que en las urnas cuando nos toque ejercer nuestro derecho al voto). Y esa pérdida de confianza es poliédrica, afecta en varios planos y a muchos sectores, los medios de comunicación incluidos (en algunos estudios resultan menos fiables que los bancos, que ya es decir). ¿A qué se debe esa falta de confianza en los medios de comunicación? 

«La gente se ha vuelto más educada. Atienden a sus iguales más de lo que atienden a los líderes. Las organizaciones han abusado enormemente de la confianza que la gente les había conferido. Tengamos en cuenta que entre 1990 y 2010, el sueldo medio de un CEO creció un 533%, según Business Week, mientras que el salario de un trabajador ordinario creció un 32% Desafortunadamente, muchos directivos parecen pensar que la organización es un reino del más allá y que el resto estamos para servirles. En lugar de que el sitio web del FMI se centre en sus clientes, se centra en sus jefes. La página de inicio se convierte en una página de inicio para Christine Lagarde, con las otras páginas asignadas a los otros príncipes. El contenido web dice mucho acerca de quién eres en realidad y lo que realmente piensas. Un contenido web centrado (focalizado) en el cliente ayuda a las personas en sus tareas. Un diseño centrado en la destrucción de la confianza hacia la organización es un diseño centrado en los egos. No busca justificar o complacer, el mundo ha cambiado, pero muchas organizaciones todavía están atrapadas en una mentalidad medieval. Sus egocéntricas sedes web son anuncios y por ello no merecen confianza. Domar el ego es el primer paso en la reconstrucción de la confianza«.

Diseño web centrado en el usuario: flujo de pasos.

Más allá de las consideraciones de tipo sociológico que emplea McGovern para criticar el planteamiento general de diseño de esta sede web (que es un buen ejemplo de otras muchas similares), queremos recordar la idea del Diseño Centrado en el Usuario, marco metodológico que (citando a Norman y Draper, 1986) nos presenta Hassan Montero y que podemos ver en la imagen anterior.