Recuperación de información
La importancia del código HTML entre los factores de éxito de la «tabla periódica» del SEO
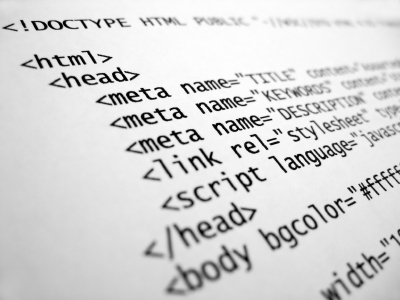
Retomamos el análisis de la «tabla periódica del SEO» que ha elaborado Search Engine Land prestando nuestra atención en el código HTML con el que se elaboran las páginas, factor que siempre ha aparecido como importantes en todas las recomendaciones elaboradas para obtener un buen posicionamiento de nuestro sitio web.
Ht:la etiqueta del título (<TITLE>): al igual que si escribiéramos 100 libros no le podríamos el mismo título a cada uno de ellos sino que buscaríamos las palabras que mejor describen. el contenido de cada obra, lo mismo hemos de hacer con el título de la página web que estemos editando (tampoco vale asignarle un título vago o genérico, el problema es similar). El contenido de esta etiqueta es tan valorado por los motores de búsqueda que alguno de ellos, Google en concreto, si no lo considera adecuado lo cambia antes de almacenar la página en sus índices. El peso de esta etiqueta es +3 y si alguien quiere profundizar en esta cuestión, puede consultar el tutorial Writing HT;L Title Tags for Humans, Google & Bing elaborado también por Search Engine Land. Su peso es +3.

Hd: la meta-etiqueta de descripción: como pasa con la etiqueta del título es un factor siempre tenido en cuenta a la hora de elaborar recomendaciones para los webmasters. Algunos puristas del SEO pueden decir que esta meta-etiqueta no «describe» propiamente hablando en términos de recuperación de información sino que sirve para «presentar» la información dentro de la lista de sitios recuperados por un motor. Es cierto, lo que no le quita ningún valor a la misma y puede servir para aumentar el número de visitas a la página por la subjetividad del usuario que consulta la lista de respuestas y se puede sentir atraído por una correcta descripción frente a una genérica. Al igual que ocurre con el elemento anterior, los motores de búsqueda pueden llegar a modificarla si lo consideran oportuno. Su peso es +2.
Hh: las etiquetas de los encabezados y subencabezados. Otro factor suficientemente conocido y presente en la mayoría de guías y recomendaciones para los diseñadores de sitios web. Además de establecer una secuencia lógica en la estructura de los mismos dentro de una página (es decir, no pasar de un encabezado de nivel a uno de nivel cuatro sin hacer uso del encabezado de nivel 3), estas etiquetas sirven para definir secciones en una página y, por tanto, cumplen una función parecida a la etiqueta del título de la página: «nombran» a la sección de la página. Por ello hay que llevar cuidado especial a la hora de elegir las palabras que representen el contenido de esas secciones. Su peso es algo inferior: +1
Hs: datos estructurados: todo lo que tiene que con los microdatos, microformatos y schema.org ayuda sin duda alguna, al motor de búsqueda (y a sus usuarios) en el acceso a la información. No está del todo claro si son factores directos de éxito para el posicionamiento pero su importancia está ahí y debe ser tenida en cuenta. Su peso es +1
Arquitectura de un sitio web, su importancia en la «tabla periódica» del SEO

Rosenfeld y Morville establecieron su visión de la Arquitectura de Información para la Web a partir de cómo se podían organizar los siguientes elementos componentes de un sitio web;
- Esquemas de organización del contenido.
- Sistemas de navegación.
- Sistemas de rotulación.
- Sistemas de búsqueda, tesauros y vocabularios controlados.
Estos «pilares» tienen algunas correspondencias en la Tabla Periódica del SEO, son las siguientes:
Ac: «recopilabilidad» del sitio web (‘site crawlability‘). Sabido es que los motores de búsqueda recopilan sitios web a partir de una serie de direcciones «semillas» desde las cuales inician sus rastreos e indexan todo el contenido de estas páginas, además de ir anotando todos los enlaces que en ellas vayan encontrando, tanto a efectos de mejor posicionamiento como para aumentar el tamaño de la colección del índice de los motores. Es uno de los factores más considerados, de hecho se le ha asignado un valor de +3 en la tabla. Si se desea atraer tráfico a un sitio web es fundamental (e incluso vital) que los elementos que forman parte del mismo no generen problemas a estos módulos recopiladores (los robots o ‘crawlers’ de los motores de búsqueda). La mayoría de los sitios en general no tienen problemas de rastreo, pero siempre hay cosas que pueden causar problemas y que, muchas veces nos pasan desapercibidas. Por ejemplo, el uso de las tecnologías JavaScript o Flash potencialmente pueden hacer invisible para los robots los vínculos presentes en las páginas y así haremos más complicado un rastreo profundo de nuestro sitio web. Cada sitio Web se beneficia de un presupuesto de rastreo, es decir, de una cantidad aproximada de tiempo o número de páginas que un motor de búsqueda rastreará cada día: Ese presupuesto será de mayor valor cuanta más confianza y autoridad reconocida tenga en nuestro sitio (y los elementos del diseño influyen en ello decisivamente). Los sitios más grandes pueden tratar de mejorar su eficiencia de rastreo para garantizar que las páginas «correctas» están siendo rastreadas con mayor frecuencia. El uso de robots.txt , estructuras de enlace internos e indicar de forma explícita a los motores de búsqueda no rastrear páginas con ciertos parámetros de URL, por ejemplo, pueden mejorar la eficiencia del rastreo. En la mayor parte de las ocasiones, los problemas de rastreo se pueden evitar fácilmente, destacando especialmente el uso de sitemaps porque tanto HTML como XML lo aprovechan para hacer más fácil a los motores de búsqueda el rastreo.

Ad: Duplicación / Canonicalización (‘Duplication / Canonicalization‘). A veces, el índice del motor de búsqueda se complica especialmente cuando, tras una operación de selección de información, se localiza un conjunto de páginas con contenido prácticamente similar (algo desgraciadamente frecuente en los blogs con un alto índice de copia directa de contenidos) y el algoritmo de ranking se encuentra con problemas para discernir cuál de esas muchas páginas es la más relevante para la necesidad de información planteada. Esto no es bueno (y ya hemos visto en este blog que, por ejemplo Google, lo penaliza por la vía de sus algoritmos Penguin y Panda).
As: Velocidad de descarga (‘site speed’). El interés por la velocidad de acceso al contenido de un sitio web es tal que Google ha declarado que aquellos sitios más rápidos tendrán una pequeña ventaja en su algoritmo de alineamiento (si bien será uno más de los muchos factores que emplea Google) Eso sí, cuando diseñamos una página pensando en su velocidad de descarga, también estamos mejorando de forma indirecta otros factores que contribuirán, sin duda alguna, a mejorar el posicionamiento de la misma. Por tanto, es algo importante a tener en cuenta.

Au: URL descriptiva. Si bien no es un factor decisivo, desde siempre se ha recomendado que en la dirección del sitio web (URL) aparezcan la palabra o las palabras que mejor lo representan (por ejemplo, un blog sobre turismo en Tarifa podría tener una URL como turismoentarifa.com). Eso siempre ayuda y además, parece que a los usuarios de la web les aportan más confianzas estas URLs tan «concretas» en lugar de algunas algo más «difuminadas». También es conveniente que la URL indique el objeto principal del sitio web a la hora de presentar los datos estructurados en los resultados de la búsqueda, tal como hacen los motores.
Por lo tanto, observamos que guardar siempre una serie de buenos hábitos sobre la arquitectura del contenido de nuestro sitio web es positivo (y nunca negativo como dirían seguramente Van Gaal y un innombrable ex-entrenador del Real Madrid) para nuestro posicionamiento. Son pequeños detalles que siempre ayudan. El gusto por la vida, ya se sabe, es cuestión de detalles ..
Propuesta y desarrollo de un modelo para la evaluación de la recuperación de información en Internet
La recuperación de información, como disciplina claramente diferenciada de la recuperación de datos, posee una naturaleza no determinista que provoca ineludiblemente ciertas dosis de incertidumbre a la hora de realizar una operación de búsqueda. Es por ello que, desde el inicio del desarrollo de esta disciplina, ha sugerido una considerable cantidad de propuestas de medida de la efectividad del funcionamiento de los sistemas encargados de esta tarea: los sistemas de recuperación de información (SRI). La consolidación de la World Wide Web como ejemplo paradigmático del desarrollo de la Sociedad de la Información y del Conocimiento, y la continua multiplicación del número de documentos que en ella se publican cada día, propicia la creación de los sistemas de recuperación de información más avanzados, de mayor volumen de documentos gestionados y de mayor popularidad: los motores de búsqueda.
En estos sistemas, no obstante, subyacen las dudas sobre su efectividad, máxime cuando los mismos suelen ofrecer grandes cantidades de referencias entre las cuales abundan muchas poco relevantes con la necesidad de información del usuario. La evaluación de estos sistemas ha sido, hasta el momento, dispersa y dispar. La dispersión procede de la poca uniformidad de los criterios empleados y la disparidad surge de la aperiodicidad de los estudios y por la diferente cobertura de los mismos. Surge entonces la necesidad de proponer el desarrollo de un modelo de evaluación multidimensional de estos sistemas, próximos a los usuarios y al contexto donde se desarrolla, la World Wide Web, entorno difícil de gestionar y que, además, se encuentra afectado de grandes dosis de volatilidad. Nuestra propuesta de modelo de evaluación adapta medidas empleadas en otros procesos de la misma naturaleza, basadas en los juicios de relevancia y en la detección de errores y/o duplicados e implementa una función discreta de ponderación de la relevancia de los documentos recuperados.
Autor Principal: Martínez Méndez, Francisco Javier
Título: Propuesta y desarrollo de un modelo para la evaluación de la recuperación de información en Internet
Mención de Responsabilidad: / Francisco Javier Martínez MéndezRodríguez Muñoz, José Vicente (Profesor Titular de Universidad de Ciencias de la Información, Universidad de Murcia)
Publicación: Alicante : Biblioteca Virtual Miguel de Cervantes, 2003
Nota General: Calificación de la tesis : Sobresaliente cum laude
Portal: Biblioteca Virtual Miguel de Cervantes
Materias:
CDU:
- 681.3.01 – Mecánica de precisión. Relojería. Balanzas, básculas.
- 002 – Documentación. Libros. Escritos. Autoría.
Encabezamiento de materia:
- Recuperación de la información Tesis doctorales
- World Wide Web Tesis doctorales
- Internet (Redes de ordenadores) Tesis doctorales
- Sistemas de información Tesis doctorales
Autor Secundario: Universidad de Murcia , Facultad de Ciencias de la Documentación
Año: 2002
New architectures for presenting search results based on web search engines users experience

Hoy voy a hacer un poco de «autopromoción» enlazando con el texto que presentamos en la última Conferencia ISIC que celebramos en Murcia el pasado septiembre de 2010 y que ahora Tom Wilson edita en su revista ‘Information Research: an international electronic journal‘.
Este artículo trata sobre cómo está cambiando los motores de búsqueda la presentación de los resultados en función de los cada vez más dinámicos hábitos de recuperación y manejo de la web por parte de los usuarios. Examina la evolución de los motores de búsqueda web y cómo sus arquitecturas de presentación de resultados han cambiado en respuesta a la experiencia y necesidades de los usuarios. Los autores destacan que los motores de búsqueda han sido, siguen siendo y probablemente seguirán siendo los sistemas más utilizados en la web para la recuperación de información, dada su presencia dominante desde hace más de quince años y la fuerte lealtad de los usuarios hacia ellos .
El trabajo se estructura en torno a una revisión histórica y analítica de las generaciones de motores de búsqueda y sus interfaces. En una primera generación, los buscadores clásicos —junto con directorios y metabuscadores— ofrecían resultados principalmente como listas de enlaces ordenados por algoritmos tradicionales, dominando la navegación web en sus inicios . Sin embargo, con el tiempo la atención se desplazó del mero tamaño del índice o la velocidad de respuesta hacia la eficiencia de recuperación y la satisfacción del usuario, incluyendo factores como la relevancia contextual y el feedback implícito derivado de la interacción usuario-sistema .
El artículo identifica una segunda generación de motores de búsqueda, caracterizada por interfaces más sofisticadas que integran diferentes fuentes de información (textos, imágenes, vídeos, noticias, etc.) y funcionalidades que responden directamente a las demandas de los usuarios. Por ejemplo, los buscadores ya no solo devuelven enlaces; ofrecen acceso directo a contenidos específicos (como imágenes o reproducciones de vídeo), recomendaciones, búsquedas relacionadas y asistentes que mejoran la experiencia de búsqueda .

El análisis comparativo de Yahoo!, Google y Bing muestra cómo cada uno aplica tendencias de presentación (como diseños de múltiples columnas o herramientas auxiliares) con el objetivo de hacer la experiencia más interactiva y personalizada, aunque con diferencias en la implementación y alcance . En conclusión, los autores sostienen que la evolución de los motores de búsqueda implica tanto avances tecnológicos como una transformación en la forma en que los usuarios interactúan y perciben la información en línea, dando lugar a un nuevo paradigma de búsqueda en Internet .
Martínez, F.J., Pastor, J.A., Rodríguez, J.V., López, R. and Rodríguez Jr., J.V. (2011). «New architectures for presenting search results based on Web search engines users experience» Information Research, 16(1) paper 461. [Available at http://InformationR.net/ir/16-1/paper461.html]
Si alguien quiere el texto original en español sólo tiene que escribirme
¿Tienen ya 20 años los motores de búsqueda?
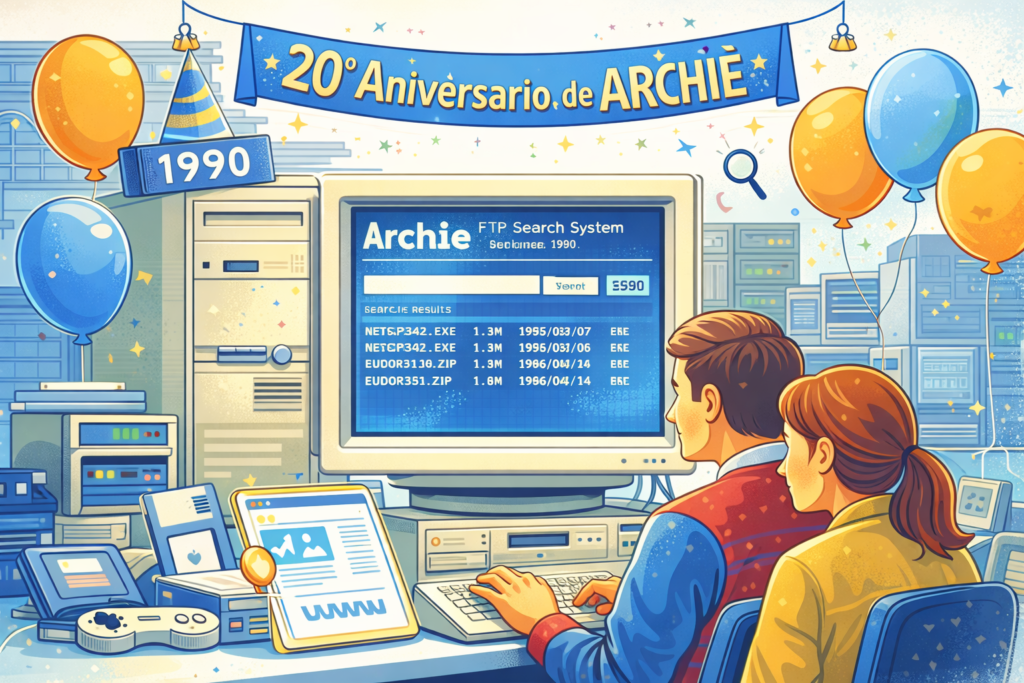
He leído un comentario en facebook de Tom Wilson publicado en la revista New Scientist sobre el vigésimo aniversario de la aplicación Archie que aprovechan los autores para celebrar el aniversario de los motores de búsqueda. Lo cierto es que en 1990 aún no habíamos entrado la mayoría de nosotros en internet pero algunos de nosotros sí hemos utilizado ese sistema que, tal como escribí en su momento en mi tesis doctoral:
«la mayoría de los autores coinciden en que el primer motor de búsqueda desarrollado en la red fue Archie, creado en 1990, aunque no fue hasta la creación del primer navegador web, Mosaic, cuando se propició el crecimiento de los documentos publicados en la web»
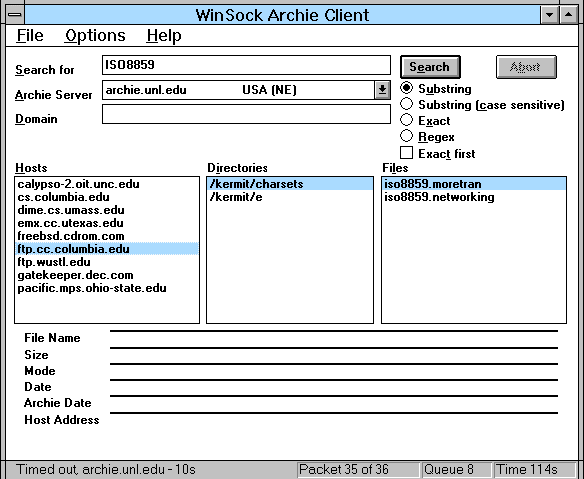
De ahí surge la necesidad de disponer de herramientas de búsqueda sofisticadas que terminaron siendo los sistemas de recuperación de información en la web. Es muy posible que casi nadie recuerde este sistema (Archie). Era una base de datos que contenía información sobre el contenido de servidores FTP Anónimo dispuestos en la red Internet. La usábamos para localizar en qué servidor FTP se podía encontrar un determinado recurso (por ejemplo el cliente de correo Eudora o el navegador Nestcape) y entonces lanzábamos la descarga del módulo ejecutable o del ZIP.
Recuerdo que entonces estos ficheros se almacenaban en esos servidores en nombres casi crípticos tales como «NETSCP342.exe» o «EUDOR351.zip«, aunque, tal como se ha podido comprobar, no representaba mucho problema. Posteriormente Archie tuvo un «lavado de cara» y se podía acceder a este sistema de búsqueda vía web. Si bien tengo dudas de que Archie fuera el primer motor de búsqueda, indudablemente es el antecedente más antiguo de otros sistemas de búsqueda (por ejemplo, los empleados en las aplicaciones de descarga/intercambio de ficheros P2P) y por supuesto, podría decirse sin lugar a duda alguna que es el «bisabuelo» de sitios web como Softonic.
Motores de búsqueda: similitud en la respuesta
Uno de los experimentos que llevé a cabo cuando mi tesis doctoral fue intentar determinar la similitud en la respuesta de los motores de búsqueda. A partir de los 30 primeros documentos devueltos por seis motores a 30 preguntas, determinamos que la similitud de la respuesta era bastante escasa, alrededor del 15% hacia principios del año 2001.
Este análisis, bastante manual, lo repetimos de forma algo más automatizada, con motivo de nuestra participación en la Conferencia ISIC de 2008 celebrada en Vilnius y los resultados fueron más o menos similares, tal como podemos ver en el artículo que publicamos como resultado de la investigación en Information Research, la revista de Tom Wilson.
Analysis of the similarity of the responses of Web search engines to user queries: a user perspective” publicado en Information Research (vol. 13, nº 4, paper 382).
El artículo analiza la similitud de las respuestas proporcionadas por distintos motores de búsqueda ante consultas idénticas, desde una perspectiva centrada en el usuario. En un contexto caracterizado por el crecimiento exponencial de la información disponible en la Web y el uso masivo de motores de búsqueda como principal vía de acceso a contenidos digitales, los autores se plantean una cuestión clave: ¿ofrecen realmente los motores resultados similares cuando se formula la misma consulta?

El estudio parte de investigaciones previas que habían observado un bajo nivel de solapamiento entre los resultados de diferentes motores, sugiriendo que cada sistema devuelve conjuntos de documentos en gran medida distintos. Esta diversidad se atribuye a varios factores, entre ellos las diferencias en los índices utilizados (cada motor rastrea y almacena una porción distinta de la Web), los criterios de actualización de sus bases de datos y, sobre todo, los algoritmos de ranking que determinan el orden de aparición de los resultados.

Para analizar empíricamente esta cuestión, los autores desarrollan un metabuscador experimental que permite enviar simultáneamente la misma consulta a varios motores de búsqueda y recopilar los resultados obtenidos. A partir de este sistema, se examinan dos dimensiones principales de similitud: (1) el grado de coincidencia en los documentos recuperados (es decir, si los mismos enlaces aparecen en diferentes motores), y (2) la similitud en la posición que ocupan esos documentos en las listas de resultados. Este segundo aspecto resulta especialmente relevante, dado que numerosos estudios sobre comportamiento de usuarios demuestran que la mayoría de las personas se limita a consultar los primeros resultados mostrados.


Los hallazgos confirman que el nivel de coincidencia entre motores es limitado. Incluso cuando se plantean consultas idénticas, los motores devuelven conjuntos de resultados considerablemente diferentes, tanto en términos de contenido como de ordenación. Esta falta de homogeneidad implica que la experiencia de búsqueda puede variar sustancialmente dependiendo del motor utilizado. Desde la perspectiva del usuario, esto significa que la elección del buscador no es neutral: puede influir en el tipo de información a la que se accede y en la visibilidad de determinadas fuentes.

El artículo también pone de relieve la complejidad del concepto de “cobertura” en la Web. Ningún motor indexa la totalidad de los contenidos disponibles, y las estrategias de rastreo y almacenamiento varían significativamente entre sistemas. Además, los algoritmos de ranking incorporan múltiples factores —como popularidad, enlaces entrantes, relevancia semántica u otros criterios propietarios— que introducen diferencias adicionales en la presentación de resultados. Así, la divergencia observada no es un error del sistema, sino una consecuencia estructural del funcionamiento de los motores de búsqueda.

Desde un punto de vista metodológico, el estudio contribuye a la evaluación comparativa de sistemas de recuperación de información en entornos web dinámicos. También subraya la necesidad de realizar análisis periódicos, ya que la Web y los motores evolucionan constantemente, lo que puede alterar los niveles de solapamiento y similitud con el tiempo.

En términos más amplios, el trabajo plantea implicaciones importantes para la alfabetización informacional y la comprensión crítica del entorno digital. Si diferentes motores ofrecen resultados distintos ante una misma consulta, los usuarios deberían ser conscientes de que la información accesible depende en parte de la herramienta utilizada. Esta constatación refuerza la idea de que los motores de búsqueda no son meros intermediarios neutrales, sino sistemas complejos que modelan el acceso al conocimiento.

En definitiva, el artículo demuestra que la diversidad entre motores de búsqueda es significativa y persistente, lo que invita a reflexionar sobre la naturaleza de la recuperación de información en la Web y sobre la importancia de adoptar una actitud crítica y comparativa en el uso de estas herramientas.
TrustRank o la lucha ‘anti spam’
En la búsqueda de mejorar la efectividad de Google contra el ‘web spamming‘ hace poco más de un año trascendió el trabajo de Zoltán Gyöngyi, Hector Garcia-Molina y Jan Pedersen titulado ‘Combating Web Spam with TrustRank‘, propuesta de algoritmo de posicionamiento basado en enlaces que podría llegar a sustituir a PageRank.
La idea fundamental de este algoritmo la comentaban sucinta y claramente en alt64:
- Google desea que en las primeras posiciones de los resultados de búsqueda encontremos páginas de cierta relevancia y que estén siendo recomendadas por otras páginas que a su vez también tengan relevancia.
- Para determinar el PageRank, el motor Google analiza el número de enlaces que provienen de otras páginas web y su PageRank.
- El algoritmo TrustRank, parte de la misma base. Pero en lugar de valorar la importancia de una recomendación en función del PageRank de la página que recomienda, lo hace a partir de una serie de páginas web que han sido consideradas importantes por humanos en lugar de por algoritmos.
- A las páginas web que los humanos determinan como importantes se las considera «web semilla» y a sus enlaces se les asigna un valor. Y será ese valor el que se irá transmitiendo por toda la red.
Para ilustrarlo con un ejemplo: Supongamos que disponemos de una web semilla A que transmitirá un valor de 100 TrustRank a todas las webs a las que enlace. Estas páginas, a su vez, transmitirán un TrustRank de 99 a todas las webs a las que enlacen. Y éstas últimas, transmitirán un TrustRank de 98 a las que ellas enlacen.
Para mitigar la degradación del TrustRank a medida que se distancia de las webs semilla, en el algoritmo se ha incluido un corrector que tiene en cuenta el número de grados que hay entre la web semilla y la web que recibe el TrustRank, sin anular completamente la distancia que las separa de la semilla».
En la propuesta inicial aún había que refinar algunos detalles, tales como esa corrección en nodos «lejanos», cuáles serán los criterios que ha de cumplir una página web para ser considerada «semilla» y también dónde se debe cortar el factor de corrección de una página para que no incorporara (o sí incorporara) un valor negativo de TrustRank. No parece que estos factores fueran a modificar sustancialmente la idea pero un poco más de un año después no se ha vuelto a hablar del tema. ¿Alguien sabe por qué?